IBM Research Blog
IBM vLLM-Hook MIA 插件实现快速运行时监控与控制
IBM 发布 vLLM-Hook MIA 插件,在 vLLM 推理引擎中实现运行时监控与控制,速度比前身 vLLM-Hook 快 20 倍、比模型内插入代码的类似方法快 14 倍,延迟仅增加 2%-6%。该插件允许开发者实时观察和调整模型状态,如拒绝恶意提示、标记幻觉事实或编辑响应语气与准确性,同时几乎不降低性能。
IBM Research BlogIBM 发布 vLLM-Hook MIA 插件,在 vLLM 推理引擎中实现运行时监控与控制,速度比前身 vLLM-Hook 快 20 倍、比模型内插入代码的类似方法快 14 倍,延迟仅增加 2%-6%。该插件允许开发者实时观察和调整模型状态,如拒绝恶意提示、标记幻觉事实或编辑响应语气与准确性,同时几乎不降低性能。
 NVIDIA Blog5555
NVIDIA Confidential Computing 通过硬件根隔离和加密认证保护模型和数据执行,新增 Confidential Bare Metal 部署选项,使前沿模型构建者能在第三方基础设施上运行敏感工作负载并保留模型数据控制权。
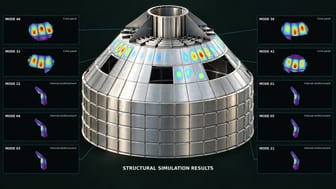
NVIDIA Blog同一件事 · 2 家3838NVIDIA cuDSS 正式 GA,作为 CUDA-X 库把大型稀疏方程组求解迁移到 GPU,缩短仿真出结果时间并提升吞吐。Applied Materials 在 Ginestra 中实现最高 10x 加速,Dassault Systèmes 的 Abaqus 报告 8-10x 提升,ZEISS SMT 用 COMSOL 完成 EUV 光刻等离子体仿真基准提速 4x。
各家口径不同:NVIDIA博客称ZEISS SMT使用COMSOL进行EUV光刻等离子体仿真提速4倍;NVIDIA新闻室提到使用cuDSS对COMSOL进行10倍加速。
NVIDIA Blog5858NVIDIA 欧洲合作伙伴正扩展区域计算能力,支持模型训练与推理,帮助开发者构建 agentic 和物理 AI 应用。Nscale 使用 NVIDIA DSX 平台实现 37% 更多 GPU 和 50% 更高推理吞吐量,Crusoe 开发液冷 AI 工厂支持低延迟推理,Nebius 采用 NVIDIA Groq 3 LPX 加速敏感应用。
NVIDIA Blog精选7272Google Cloud 与 NVIDIA 宣布基于 NVIDIA Vera Rubin 的 A5X 实例正式可用,下月开放并计划扩展至欧洲。
推荐理由: 原文给出 A5X 实例的可用时间、客户实测与机密计算配套,读者可据此判断大规模强化学习基础设施的落地节奏。
NVIDIA BlogNVIDIA 在 GTC Berlin 上展示了其本地 AI 硬件全阵容,RTX Spark 已上线支持 Windows PC 上的个人智能体,DGX Spark 支持开发者构建和扩展 Linux 应用,DGX Station 则为 Linux 企业团队运行前沿工作负载,Windows 版将于 12 月推出。
 Databricks Blog
Databricks 发布 AI Runtime (AIR),将托管 GPU 基础设施直接引入其平台,让客户能在企业数据所在地训练高需求模型。AIR 提供 GPU 基础设施、开发者工具和数据治理功能,支持大规模训练、快速迭代和负载安全,客户无需管理独立的 GPU 堆栈。
NVIDIA Blog精选6767NVIDIA CEO 黄仁勋在 GTC Berlin 2026 主旨演讲中宣布多项更新,包括以模块化集装箱交付的 Vera Rubin AI 工厂参考设计 DSX POD,现场部署时间可从六个月缩短到 14 天。
推荐理由: 黄仁勋在 GTC Berlin 的主旨演讲集中披露了 AI 工厂、智能体安全运行时与开源模型三条产品线的最新进展,读者可据此了解 NVIDIA 在欧洲的布局重点。
 AWS Machine Learning Blog5858
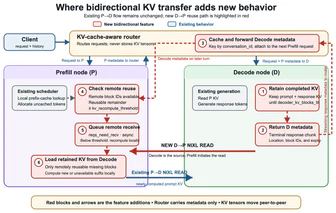
vLLM 的双向 KV 传输机制通过让解码节点在后续对话回合中返回先前计算的 KV 缓存给预填充节点,减少了重复计算,在 AWS EC2 P5en 实例上的多轮基准测试中将 Qwen3-32B 的 TTFT 提升了 1.6 倍,zai-org/GLM-5-FP8 提升了 3.3 倍。该功能通过扩展 NIXL KV 连接器实现,并利用 KV 缓存感知路由器协调跨对话回合的 KV 重用。
AWS Machine Learning Blog3131Amazon SageMaker JumpStart 上线以来已集成 100 多个来自 30 家提供商的新模型,涵盖 Qwen 3.8-27B、Cosmos3 系列等。
AWS Machine Learning Blog3434新 AWS 体验让新 SageMaker AI 客户在注册后只需几步即可进入完全配置的 SageMaker Studio 环境,无需设置高级 AWS 账户或手动配置环境,新客户还可获得 100 美元的 AWS Free Tier 信用额度。
AWS Machine Learning Blog4040Eon 使用 Amazon Bedrock AgentCore Gateway 替代了本地 Model Context Protocol (MCP) 服务器,将跨 AWS、GCP 和 Azure 的操作工具访问整合为单一认证网关,使新工程师调查工具配置时间从 2 天缩短至 2 分钟。
AWS Machine Learning Blog5858AWS Agent Registry 通过运行时发现机制解决智能体演示中隐藏的问题,其 orchestrator 代理向 AWS Agent Registry 数据平面发送自然语言查询。
AWS Machine Learning Blog3838Octave Reliance 团队为解决监管行业质量管理的知识孤岛问题,在 Amazon Bedrock 上构建了基于 Cohere Embed v4 的三层安全多人租户 AI 基础设施,将部署时间缩短 50%。
AWS Machine Learning Blog3838Amazon Quick 结合 Amazon Bedrock AgentCore 为供应链团队提供跨系统实时数据访问,用户可通过对话式提问在 seconds 内获取跨系统答案,如识别受港口关闭影响的高收入 SKU 及成本。Quick 作为界面层,AgentCore 作为智能层,通过 MCP 协议连接 ERP、监控、采购等后端系统,实现从问题发现到生成应急采购请求的完整流程,所有操作需人工确认。
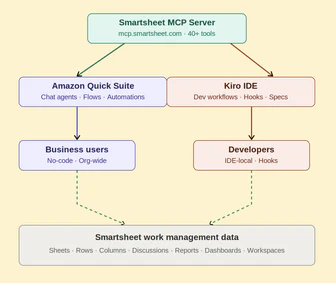
AWS Machine Learning BlogSmartsheet 推出通用版 Model Context Protocol (MCP) Server,使 AI 助手能通过标准化协议读写管理 Smartsheet 数据,支持 40 多种工具操作表格、行、列和自动化
 GitHub Blog · AI & ML3333
GitHub Copilot 用户可直接在 VS Code 中打开 GitHub Copilot app 会话,继续其对话、代码变更和上下文。用户可逐行审查 Copilot 的修改,直接在 VS Code 中进行手动编辑,并在本地运行和验证项目。会话和代码工作区保持连接,支持与 Copilot 交互式迭代优化,最后将更新提交到关联的拉取请求。
NVIDIA Blog欧洲广播联盟(EBU)与 NVIDIA 合作扩展主权框架,引入云服务商、开源模型开发者及系统集成商,帮助欧洲广播机构在部署智能体时保留数据、基础设施、模型和安全的控制权。
Databricks BlogDatabricks 将 RFD4-Proteina 模型集成到 Genesis Workbench,支持在 AI 运行时环境中执行,并与研究数据和工作流程连接。开发者可通过 Genie Code 和 NVIDIA BioNeMo Agent Toolkit 技能构建和调整管道,利用 serverless NVIDIA GPU 计算进行蛋白质设计。
 腾讯混元 · Hugging Face 新模型精选7878
腾讯混元在 Hugging Face 发布视频世界生成模型 Hy-Nomas,支持通过文本指令和相机控制进行自由形式的多轮交互,逐段生成视频并延续同一世界。模型采用分段自回归 DiT 架构,结合 Qwen2.5-VL-7B 文本编码器、相机条件模块和 PixelUMM 解码器,蒸馏推理配置为 8 步去噪、720×1280 分辨率、24 FPS。
推荐理由: 腾讯混元开源可多轮交互的世界生成模型,给出架构细节与单卡 4090 部署配置,便于评估落地成本。
 vLLM Blog精选6060
vLLM 宣布在 Flint 发布当天提供支持,NVFP4 与 BF16 两个 checkpoint 均可在单张 GPU 上运行,单请求在单张 GB200 上、10 万 token 上下文下解码约 500 tokens/s。
推荐理由: 原文给出了 Flint 在 vLLM 上的 day-0 支持、单卡吞吐数据和逐项内核优化过程,读者可据此判断小批量推理的工程取舍。
 Google Developers Blog
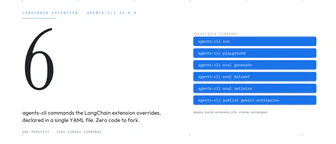
Agents CLI 1.5.0 版本引入扩展系统,允许开发者无需修改工具即可覆盖或添加命令,支持跨框架使用;官方发布的 LangChain 扩展替换了与框架绑定的命令,保留其余生命周期功能;开发者可创建自定义扩展,如添加软件物料清单(SBOM)扫描的部署命令,企业平台团队可借此强制执行治理策略。
AWS Machine Learning Blog3838Smartsheet 推出通用模型上下文协议 (MCP) 服务器,使 AI 助手能通过标准化协议读写管理 Smartsheet 数据;支持 Amazon Quick 和 Kiro 连接,Quick 供知识工作者和运营团队自然语言查询更新 Smartsheet,Kiro 让开发者能参考项目规格和更新任务状态,无需离开编码环境。
Databricks BlogDatabricks 推出 Agent Memory,通过存储关键事实、偏好和流程提升智能体质量、降低成本和延迟,支持在 Lakebase 上运行,目前处于 Beta 版本。Agent Memory 基于 Databricks 最新内存研究,采用 MemCurrent 架构,在内部基准测试中使智能体任务通过率提升三倍,同时减少 31% 的 token 使用量。
IBM Research Blogllm-d 项目宣布发布 1.0 版本,这是一个 Kubernetes 原生的分布式推理服务网络,支持在任何加速器上、任何云中部署任何模型的推理栈。该版本增强了多租户服务质量、零停机操作和智能体感知服务,以在常见生产操作中实现持续性能。通过前缀缓存感知路由和 KV 缓存卸载等技术,llm-d 1.0 可捕获 97% 的可用缓存重用,降低大规模 AI 服务的成本。
 Hugging Face Blog5858
AnyLanguageModel 1.0 发布,一年支持苹果平台本地模型进展。新增支持 OpenAI Chat Completions、Anthropic Messages、Google Gemini 等云端模型,本地模型支持 llama.cpp、MLX、Core ML,工具调用与引导生成功能扩展。云端模型具备本地模型相同功能,API 密钥支持闭包动态获取。
 Anthropic Research
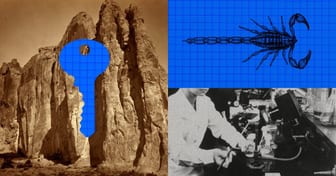
Claude 在 64 小时内自主生成 318,484 个蛋白质设计并筛选 180 个用于测试,与 Adaptyv Bio 和 Twist Bioscience 合作实验验证 211 个设计,其中 17 个符合结合标准,所有设计数据已公开。专家认为这是针对蝎子神经毒素的首次 AI 设计尝试,可能加速对忽视疾病的药物发现。
vLLM BlogvLLM TorchTPU (vllm-torchtpu) 发布,可在 Google Cloud TPU 上运行 vLLM,支持 Pallas 内核的注意力、Mixture-of-Experts 和量化矩阵乘法,保持 vLLM 体验不变,支持六维并行,推荐 TPU v7x (Ironwood)。
Hugging Face Blog精选6262Hugging Face 的 PyTorch 团队介绍 PyTorch 2.15 在 MPS 后端的更新,新增 torch.float8_e4m3fn 张量与 F.scaled_mm,FP8 张量占用为 BF16 的一半。
推荐理由: 原文给出 MPS 后端在 FP8、MoE 解码和显存占用上的具体数字,可据此判断 Mac 本地跑模型的实际变化。
Google Developers BlogCoral NPU 发布了完整的 32 位架构,包含新的矩阵执行单元,支持高达 1 TOPS 性能和 10mW 平均功耗;推出基于 IREE/MLIR 的 Coral Compiler v1.0。
Google Developers BlogArm 利用 Google AI Edge Model Explorer 的分层图可视化和插件架构,开发了支持 TOSA、VGF 和 PTE 等格式的开源适配器,帮助开发者更便捷地检查边缘模型转换流程。
Hugging Face BlogHugging Face 发布 TorchTPU,使 TPU 成为 PyTorch 的原生后端设备。Transformers、Diffusers 和 Kernels 现可直接在 TPU 上运行,用户只需从 Hugging Face Hub 选择模型,指定 device_map="tpu" 即可。
 Claude · YouTube
Claude 推出 Claude Dashboards 和 Claude Motion,前者在所有付费计划中支持将数据平台或 CRM 数据实时转化为仪表盘,后者在 Team 和 Enterprise 计划中支持将报告或图表生成动画解释视频,两者均以代码形式生成无需视频模型,可修改内容后导出 MP4 或编辑。
 Meta Engineering
GenRecs Tokenization 通过将广告、产品等项用稳定语义词汇表表示,结合 Meta 生成式广告模型(GEM)和自适应排序模型,为广告主带来 0.35% 的转化率提升。该技术利用预训练大模型的世界知识,使推荐系统能理解新项目或无历史交互的用户偏好,并通过共享概念加速学习、实现跨活动迁移、随大模型规模提升性能,形成性能改进的反馈循环。
Meta EngineeringMeta工程师通过构建一个1,300行的精简路由器,将20+工作流分配给14个专业AI代理,路由器自身不执行任何领域工作,显著提升了数据管道代理的效率和准确性。
 LangChain Blog
Nu公司在开发AI健康教练Nu时,优先构建了评估标准以避免越界医疗诊断,采用LangGraph框架和LangSmith工具,通过按类别评分的LLM裁判和开放式行为测试,确保系统在满足健康指导需求的同时符合监管要求。评估框架针对单一回复和完整对话分别设计,支持在两个前沿模型提供商间快速迁移,安全探针和守门节点实时审查对话内容,确保产品始终处于合规边界内。
IBM Research Blog2222Coursera 新课程《AI 数据流架构:从原理到实践》教授工程师如何跨 GPU、TPU、Cerebras WSE、Groq LPU 和 IBM Spyre 加速器工作。课程由 IBM 研究院高级研究科学家 Kaoutar El Maghraoui 主讲,通过六门课程和动手实验覆盖执行模型、编译、内存系统、调试和性能建模,强调不同架构如何影响模型性能及编译器优化关键作用。
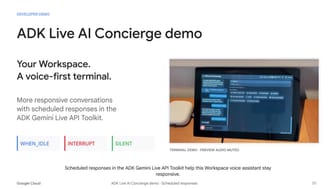
Google Developers Blog使用 ADK 和 Gemini 3.8,通过流式工具和异步函数实现非阻塞语音交互,将销售报告工作流的首次响应时间从 14.4 秒缩短至 1.2 秒,支持零静默、进度更新和并行对话。
 Together AI Blog
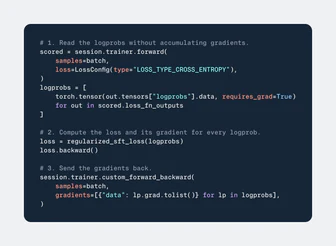
Together AI 推出 Post-Training 服务,支持通过强化学习和监督微调构建定制模型,无需复杂基础设施。该服务提供灵活的训练循环定义能力,并优化底层系统与基础设施以提升模型质量与训练速度。支持 Muse Spark Open、GLM 5.3、Kimi K3 和 Qwen 3.8-27B 等主流开源模型,运行在专属 GPU 资源上,确保高效且数值一致的训练。
NVIDIA BlogNVIDIA RTX Spark 笔记本电脑开始发售,配备 Blackwell RTX 显卡、最高 128GB 联合内存和完整的 NVIDIA AI 平台,起售价 2399 美元,由华硕、戴尔、惠普、联想、微软和微星推出,为便携设备带来强大的本地 AI、内容创作和游戏能力。NVIDIA 在全球举办发布会庆祝,包括柏林活动,创始人黄仁勋惊喜现身。