NVIDIA Newsroom3838
AI如何重塑半导体晶圆厂工作方式——工程师因之加速决策
AI正改变半导体晶圆厂工作方式,工程师因之加速决策。NVIDIA cuDSS库使COMSOL的多物理场仿真加速10倍,Applied Materials的Ginestra平台仿真加速10倍,ACE+平台加速35倍,Siemens的Calibre光刻软件仿真加速17倍。NVIDIA PhysicsNeMo框架让Lam Research能在毫秒级预测等离子体行为,替代耗时数天的全仿真。
NVIDIA Newsroom3838AI正改变半导体晶圆厂工作方式,工程师因之加速决策。NVIDIA cuDSS库使COMSOL的多物理场仿真加速10倍,Applied Materials的Ginestra平台仿真加速10倍,ACE+平台加速35倍,Siemens的Calibre光刻软件仿真加速17倍。NVIDIA PhysicsNeMo框架让Lam Research能在毫秒级预测等离子体行为,替代耗时数天的全仿真。
 PyTorch Blog
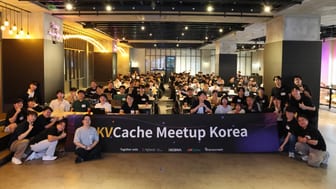
PyTorchKR 与 XCENA 于 2026 年 9 月 30 日联合举办 KVCache Meetup Korea,XCENA、SK hynix、FuriosaAI 和 LMCache 的演讲者分享了 LLM 推理及 KV 缓存优化的成果。
 Ai2 Blog
StateBench 是一个用于测试大语言模型追踪长文档中实体状态变化的基准,包含 R-trivial、非周期、可解和一般有限四个难度等级。研究发现,循环和混合模型在直接训练这些任务时泛化能力远超 Transformer,而 Gemini 3.8 Flash、Claude Opus 5.5 和 GPT-6 Sol 等前沿模型在输入变长时仍难以处理更复杂的状态追踪问题。
NVIDIA NewsroomNVIDIA 与合作伙伴正将物理 AI 和智能体 AI 扩展到全球城市,通过共享计算基础设施支持市政部门、邻近市镇及本地开发者构建服务,无需各组织单独采购和管理资源。
 Hugging Face Blog
Transformers 支持超过 750 模型类型,其测试套件包含 88,000+ CPU 测试和 200,000+ GPU 测试。Hugging Face 发布 Model Integration Contracts (MIC) 标准,包含压缩模型(如 66 MB 权重的 UMT5 固定件)、可运行示例(如 SmolLM 文本生成)和人工审核基线。
 Anthropic Research精选6262
Anthropic 公布可验证推理原型 FlashProve,用 zkSNARK 证明响应确实来自所承诺的模型权重。对 400B 参数的 Llama 4 Maverick(4-bit 量化),单张 H100 生成证明约 110 tokens/秒,每 1,024 token 请求的证明约 19 MB,验证在 24 核 CPU 上约 17 秒。
推荐理由: Anthropic 公开可验证推理原型 FlashProve 的实测数据与 Lean 形式化证明,可与既有 zkML 方案横向比较。
 Codex releases00
GitHub Copilot 0.167.0-alpha.4 发布,提供代码审查、安全漏洞检测和秘密扫描等功能。
 Apple Machine Learning Research
苹果研究人员提出一种跨架构蒸馏配方,将基于Attention的模型蒸馏至Mamba架构,蒸馏后的Mamba模型困惑度达14.01,接近教师模型的13.86,并在下游任务中表现良好。
 LangChain Blog3838
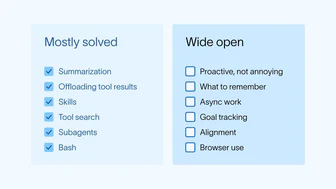
LangChain指出2026年后期智能体上下文工程面临的新挑战,包括如何在不烦人情况下主动通知用户、智能体记忆管理、异步任务处理、目标追踪与对齐、以及浏览器使用等难题。这些挑战涉及智能体在后台运行时如何平衡通知频率、决定记忆内容、协调异步工具与子智能体、分解与迭代目标,以及防止智能体过度优化目标等。
 Databricks Blog
Lakebase Postgres 在 Google Cloud 上正式发布,支持无服务器 Postgres 运行于 Databricks 数据与 AI 平台。
PyTorch Blog3434Ray 宣布加速器特殊兴趣小组(SIG),旨在联合硬件厂商、Ray 贡献者和应用开发者,制定中立的加速器支持路线图。初期聚焦开发测试基础设施、硬件感知能力和网络传输,优先支持共享硬件访问、可复现的开发测试环境及更广泛的 CI 覆盖。
 AWS Machine Learning Blog3838
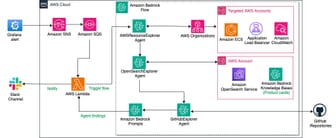
Circle K 通过 Amazon Bedrock 构建自动化事件排查系统,将平均排查时间缩短至 15 分钟以内,降幅 67-75%。该系统利用 Amazon Bedrock Flows 和 AgentCore,通过并行执行的专用智能体自主分析事件,并将结构化摘要实时发送至 Slack,使工程师能立即采取行动,同时避免重复的日志查询、健康检查和运行手册查找工作。
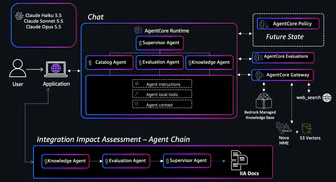
AWS Machine Learning Blog3434工程师使用 Amazon Bedrock AgentCore 平台构建多代理系统,通过 Claude Haiku 5.5、Claude Sonnet 5.5 和 Claude Opus 5.5 模型组合。
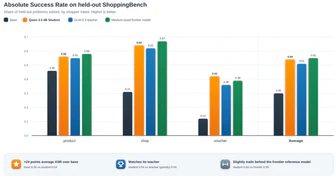
AWS Machine Learning Blog4343使用知识蒸馏在 Amazon SageMaker AI 上微调购物助手,通过序列级知识蒸馏(SeqKD)将前沿模型的行为迁移到小型模型,生成解决任务的推理轨迹并用于监督微调,实现高效低成本推理。SeqKD仅需教师模型的文本输出,无需权重或 logits,适用于无法访问教师模型内部信息的场景,如 API 模型,并可通过基准测试评估学生模型性能。
 Moonshot AI · Hugging Face 新模型
Kimi K3.1 Pro 是 Moonshot AI 开源的多模态智能体模型,参数量 2.8T,激活参数 104B,上下文窗口 1M tokens,在编码、3D 创建、金融研究等领域表现优异。与 Kimi K3 相比,采用 Gated DSA 层提升长文本处理效率,在 Terminal-Bench 4.0 等评测中超越 Claude Fable 5.1 和 GPT-6 Astra 等竞品。
Codex releases00GitHub Copilot 0.167.0-alpha.3 发布,未提及具体更新内容。
Codex releases00GitHub Copilot 0.167.0-alpha.2 发布,该 AI 编码智能体用于任务、项目和自动化工作,提供代码审查、质量分析、安全漏洞检测等功能。
 IBM Research Blog88
IBM Research博客发布2026年11月的Ponder This挑战,要求计算长度为10^10的序列a0,...,a10^10-1,其中ai=(N^i) mod (10^10+19);额外奖励求解长度为10^11的序列ai=13^i mod (10^11+3)。
Databricks Blog5858Databricks Lakebase 通过其基于复制-on-write 的数据库分支功能,将每个 PR 分支的创建时间缩短至秒级,支持峰值约 100 个并发分支,每分支独立读写,兼容标准 Postgres 并支持大型 JSONB/LOB 列,满足 Snorkel AI 在 CI/CD 流程中快速、安全、低成本地测试生产数据的需求。
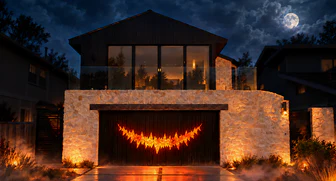
Hugging Face Blog4040MonsterHouse 是一个用 NVIDIA Nemotron Voice Agent、NVIDIA Nemotron ASR、NVIDIA Nemotron 3.5 Bolt E4B 4GB、Magpie TTS Zeroshot 和 Audio2Face-3D 构建的互动投影,能通过语音与访客交流并模仿脾气暴躁的老海盗声音。
AWS Machine Learning Blog3838Worldwide Express 通过 Amazon Bedrock 和多智能体 AI 解决了每月 1500 万美元因货运异常导致的资金冻结问题,其系统包含三个专门处理不同类型账单纠纷的智能体,并在 6 个月内将活跃异常减少 75%,加快了 4 周的回款时间并每年节省 100 万美元。
 Microsoft Research4040
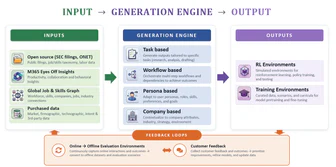
Microsoft Research 开源了产业评估数据生成平台,通过基于 O*NET 职业数据、在线招聘和 SEC 文件的合成企业环境,模拟真实业务流程测试 Copilot AI,确保评估不接触客户数据且符合安全隐私标准。该平台包含自动化查询生成管道和结构化质量框架,支持制药、资本市场和 IT 软件等行业的真实场景测试。
 蚂蚁 inclusionAI · Hugging Face 新模型3838
inclusionAI 发布 ZwZ2-9B GGUF 格式权重,属于 Zooming without Zooming v2 项目,包含语言模型(FP16, Q8_0, Q4_K_M)和视觉编码器及投影器(mmproj,FP16, Q8_0, Q4_K_M),需搭配 llama.cpp Qwen3.5 多模态支持使用,支持 CLI 推理和 Web Chat 部署。
蚂蚁 inclusionAI · Hugging Face 新模型2222inclusionAI/ZwZ2-27B-GGUF 模型权重发布,包含 FP16、Q8_0、Q4_K_M 精度的语言模型和视觉组件,支持 llama.cpp 多模态推理。
Databricks Blog4747Databricks 宣布 Spark Declarative Pipelines Real-Time Mode 正式可用,该模式通过持续流式处理、并行查询阶段和即时数据传递实现毫秒级端到端延迟。
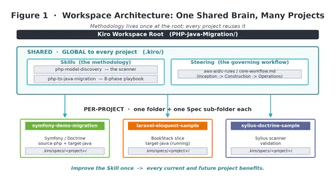
AWS Machine Learning Blog5555Kiro 将 AI 代理与代码库结合,通过可重复的八阶段工作流程将 PHP 应用迁移至 Java,支持开发者交互式审核或 AWS Transform 自动化处理,共享技能文件实现方法论统一。
AWS Machine Learning Blog3434Epsilon 通过 Amazon Nova Act 和 Amazon Bedrock AgentCore Browser Tool 构建了意图驱动型 UI 测试平台,实现自然语言测试用例(如“确认奖励余额可见”)与现有 Playwright 回归测试套件的结合。
Codex releases4545Codex 0.166.0 发布,新增键盘驱动转录选择(支持词、行、页操作)、集成搜索和可配置快捷键,以及 Markdown 在异步问题、选项、答案和转录回复中的一致性渲染。同时支持 GPT-6.1 Terra,并添加 codex queue --resume 功能以恢复卸载线程。
 Amazon Science
 结合知识蒸馏(KD)和 Medusa 框架优化旅行平台 LLM。经过微调、KD 训练及 Medusa 头部改造后,TinyLlama 1.1B 模型在 AI 旅行规划、智能筛选和住宿描述生成等场景中,性能接近 70B 参数 Llama-3.1 教师,成本降低三分之二,速度提升 10-20 倍。
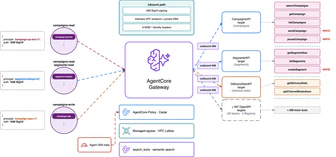
AWS Machine Learning Blog4242MoEngage 通过 Amazon Bedrock AgentCore Gateway 将 400 个内部 API 转换为受权限控制的智能体工具,解决多团队 API 集成难题。该方案无需搭建 MCP 服务器或配置网络,将新 API 上线时间从数天缩短至数小时,同时满足 API 保留在 VPC 内部、身份由服务端控制、工具定义不占用推理上下文窗口的约束。
AWS Machine Learning Blog4242NVIDIA 在 AWS 上推出 120B 参数的 Nemotron 3.5 Super VL 模型,该模型每激活 12B 参数处理一个 token,结合推理和工具使用,支持文本、图像、文档和视频理解。
 vLLM Blog精选同一件事 · 2 家7878
vLLM 宣布在发布当天支持 Mistral Large 4,这是一个 1 万亿参数、每 token 激活 49B 的 MoE 原生多模态模型,采用 MLA 加 DSA 稀疏索引器,并内置 DSpark 投机解码草稿模型。
Hugging Face Blog精选同一件事 · 2 家8585Mistral 发布多模态 MoE 模型 Mistral Large 4(Le Chonk),约 1T 总参数、49B 激活参数,上下文窗口 1M tokens,提供 FP8 与 NVFP4 两个官方版本,另有 Unsloth 和 llama.cpp 团队制作的 GGUF。
推荐理由: 原文给出 1T 总参数、49B 激活的 MoE 多模态模型在网络安全与编码基准上的具体分数,并附本地与端点部署实测吞吐。
Hugging Face BlogHugging Face 发布 Granite Switch 4.1.1,在 4.1 基础上增量更新,保留完全向后兼容性。新增多语言语音转写模型(支持 10 种语言带原生标点)和 Jev 决策指数测试集性能提升的决策适配器。团队通过仅更新适配器未重新计算基础模型,实现快速部署,未来将支持第三方自定义适配器。
Hugging Face Blog5050Hugging Face 发布开源语音识别 AnySpeechRecognizer 和决策模型 AnyDecisionModel,支持 NVIDIA Parakeet 和阿里云 Qwen3-ASR 等引擎,可在苹果平台本地运行。
 ByteDance Seed · Hugging Face 新模型
ByteDance-Seed/GenFirst 训练一个潜在 VAE 并联合一个生成先验,避免通常使端到端训练不稳定的潜在崩溃。该方法的两个阶段计划用于先验和熵权重:第一阶段让先验塑造潜在几何形状,第二阶段将两者权重十倍降低,使解码器恢复细节。
 Google Developers Blog
LiteRT 在 Google Play services 中迎来重大升级,其 GPU 推理速度比传统 GPU 代理器快约 1.4 倍,通过新推出的 CompiledModel API 实现,该 API 由开源 GPU 引擎 ML Drift 驱动
AWS Machine Learning BlogQA Studio 的应用功能组织测试并报告健康指标,团队级用户管理控制访问权限,通过健康评分和趋势图表监控测试覆盖率,五种角色(管理员、团队负责人、编辑、执行者、查看者)实现应用级别的权限管理。
Google Developers Blog5858Agents CLI v1.8.0 通过 eval generate、eval grade 等命令实现 Hill-Climbing 优化 Agent 质量,使用 custom_response_quality 指标对 4 个案例进行 1-5 分评分,发现修改系统提示词为厨师角色导致平均分从 4.0 降至 2.75。该工具支持模型后端实验和自动告警,通过循环迭代提升 Agent 性能。
LangChain BlogOpenWiki 使智能体在需要跨来源连接的问题上准确率比单独搜索高约 5 倍,添加证据图将准确率再提高 27% 并使引用一致性翻倍。