Coursera 新课程《AI 数据流架构:从原理到实践》教授现代加速器运行原理
Coursera 新课程《AI 数据流架构:从原理到实践》教授工程师如何跨 GPU、TPU、Cerebras WSE、Groq LPU 和 IBM Spyre 加速器工作。课程由 IBM 研究院高级研究科学家 Kaoutar El Maghraoui 主讲,通过六门课程和动手实验覆盖执行模型、编译、内存系统、调试和性能建模,强调不同架构如何影响模型性能及编译器优化关键作用。


Tencent 混元发布的 Hy-Memory-30B-A3B-GGUF 模型量化文件采用 imatrix 校准和 MoE 感知的混合精度量化方案,在 llama.cpp 上实现高效本地推理,其中 ~8 GB 的 expert-mixed 构建文件大小降至约 24.71 GB,性能仅比 Q6_K 下降 1.53%。
vLLM 通过异步准备和 NIXL EP 技术,将 DeepSeek V4 Pro 从 16GB200 到 20GB200 的扩展停机时间缩短至 0.82 秒,从 20GB200 回缩至 16GB200 的停机时间缩短至 1.96 秒。
TorchNeuron 为 PyTorch 在 AWS Trainium 提供新原生后端,Transformer、Diffusers 和 Kernels 均原生支持,使在 Trainium 上运行模型和在 HF Hub 分享模型变得前所未有的简单。
MiniMax M3.1 Flash 正式推出,相比前代在线推理速度提升近三倍、成本降低 70%。该模型在复杂智能任务(cowork)、计算机使用、软件开发和网络安全等基准测试中表现优异,自动化任务排名 AutomationBench-AA 前列,DeepSWE v1.1 得分 73.7%,OSWorld V2 和 ALE 分别得分 61.7 和 29.6,CyberGym 得分 82%。
Cloudflare 的 27B 多模态决策模型 Clef 已登陆 Ollama 云平台,用户可本地运行或使用云端服务。Clef 将状态和类型化问题模式转化为决策,支持文本和图像输入,兼容 Jev 和 System One API,基于 Qwen3.8-27B 微调并采用 Apache 2.0 许可证。在 Cloudflare 决策指数评测中,Clef 优于 Jev 并在多数基准测试中表现领先。
Google Research 发布 VERID 框架,使 AI 智能体能在基于物理测量的安全、资源高效的实验中运行;在适配体和从头蛋白质设计原型上展示闭环智能体科学发现;通过 3 轮设计-测试-迭代循环,在肌红蛋白和 α-凝血酶两个靶点上,AI 驱动的合理和从头设计将确认的靶向命中率分别提高到 33.5% 和 42.1%。
vLLM通过智能体辅助开发为Kimi K3构建了统一CuTe DSL解码路径,在16颗NVIDIA GB300 GPU上实现840 tokens/s的批处理1性能,测试配置中解码吞吐量提升1.5-2倍,AgentX工作负载P90交互性提升1.8倍。
Claude Code团队将代码审查量提升2倍的同时将回滚率降低40%,通过将大部分审查工作交给机器优化人类时间,并大幅提升撤销错误的速度。团队采用六层自动化审查流程,包括Claude运行测试和生成输出、子代理审查差异、内部技能自动检测错误、UI变更对照设计规范,以及代码规范和代码所有者指南的自动检查,最终由人类审查者处理高阶问题。
微软AI完成新MoE大模型MAI-Base-2的预训练,拥有80亿活跃参数和2.8万亿总参数,在内部评估中超越所有开源模型。该模型比开源最强基座模型DeepSeek-V4-Pro-Base预训练FLOPs效率高出4-12倍,并用于训练更大模型。微软通过全栈控制,使用有机数据预训练,计划通过Foundry授权模型权重。
NVIDIA 发布 120B 参数的 Nemotron 3.5 Super VL 开源模型,在多模态智能体任务中实现最快任务完成速度和最高准确率;同时推出 Nemotron 3.5 Bolt 74B-A9B 24GB 和 Nemotron 3.5 Bolt E4B 4GB 边缘模型。
Mistral AI 发布了 Timestral 时间序列基础模型家族,其参数最少的模型仅 209M,在 GIFT-Eval、TIME 和 fev-bench 三个主要基准测试中排名第一,优于参数量更大的模型;该系列包含 5M 至 209M 参数四种尺寸,支持过去和未来的协变量,可在 CPU 上高效运行,并可通过 Mistral Forge 进行领域适配微调。
选择式结构化推理 (SSR) 框架将推理重构为选择而非开放式生成,在每次行动前从预定义的推理候选中选择最可能的方案,显著降低推理成本。使用 2B 和 4B 模型在七项多模态搜索基准测试中验证,SSR 实现了平均成功率与同等规模领先搜索智能体相当,单步推理延迟降低 90%,单题总推理延迟减少 28-54%。
Meta Muse Spark Open 已在 Together AI 平台上线,这是目前最强大的美国开源重量模型,专为需要将整个代码库保存在上下文中的长时间运行智能编码工作流程而构建。
谷歌推出 ADK-Recipes 仓库作为 Agent 平台内容单一事实来源,包含核心模式、插件技能和服务,支持终端构建长时程记忆代理、一键安装零售垂直技能,并部署到 Cloud Run 或 Gemini Enterprise。
在 ToolBench 上,Retrieve-then-Plan (RtP) 在单工具查询中优于 Plan-then-Retrieve (PtR),而 PtR 在多工具查询中表现更佳,这一交叉点在所有检索预算(k=1至20)、注册表规模(1k至47k API)和模型族(Gemini 2.5 Flash 和 gpt-oss-120b)中均成立。
在四台 Mac Studio 集群上,Muse Spark Open(816B 参数)生成速度超过 36 tokens/秒。Mac Studio M5 Ultra 版本比 M3 Ultra 在推理速度上提升 4.6 倍(TTFT)和 1.6 倍(tokens/秒),得益于 GPU 神经加速器和 1.2 TB/s 内存带宽。
谷歌发布Geospatial Reasoning智能体,集成Earth AI基础模型(含WeatherNext、PDFM等)及Google Maps等数据源,通过模块化技能与规划能力处理行星级地理数据。
inclusionAI/Ming-3.0-asr-tiny 结合 Ling-tiny-v3 语言主干和音频编码器,支持单轮中英语音转写及15种方言识别,通过热词或对话上下文提升专业术语识别率,模型参数量未提及,在嘈杂语音和5个应用领域完成评测,提供PyTorch/Transformers推理示例及MIT授权。
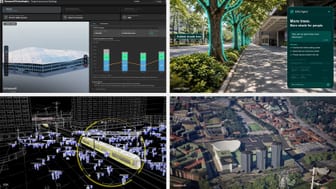
欧洲多个城市及软件、基础设施和集成合作伙伴正使用NVIDIA加速计算构建物理AI智能体和数字孪生系统,以优化城市运营决策。这些应用可预测维护需求、指导城市规划并提升公共服务响应能力,涉及比利时、芬兰、法国、意大利、荷兰、波兰、瑞典、英国等地。
阶跃星辰发布旗舰模型 Step-5-Preview-NVFP4,600B 总参数、27B 活跃参数,支持高达 1M 上下文窗口,在软件工程、专业知识工作及金融领域表现突出,可处理文本、图像和视频,通过 OpenAI 兼容 API 或离线生成部署。
Whisper-small 在 CS-FLEURS 基准测试中实现 14 种语言对的平均 F1 分数 0.798,优于 CNN 的 0.776 和 HuBERT 线性基线的 0.751。该方法通过识别预训练语音编码器中的语言选择性隐藏状态维度,直接从语音中检测语言转换,仅需少量代码转换数据集即可微调决策规则。
Apple Machine Learning Research 首次从零开始预训练文本、图像-文本和音频-文本数据的三模态掩码扩散模型(MDM),分析多模态扩展规律。
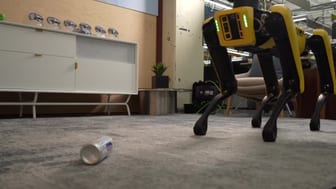
Gemini 4 Argon 在物理理解、代码生成和视觉语义推理方面取得重大突破,在 Embodied Reasoning (ERQA) 基准测试中纯推理得分 87%,超越所有前沿模型。Argon 可应用于机器人生命周期的各个环节,包括使用 MuJoCo 进行移动操作练习、零样本机器人控制和视频世界模型的闭环转向。
Gemini 4 Argon 在 Vals Index 上排名第一,以 175B 参数规模在编码、金融、法律、网络安全和科学等领域超越其他前沿模型,其推理深度和精度使它成为解决复杂工程问题、优化业务流程和加速科研突破的利器。
Google 发布了 Gemini 4 Argon,面向开发者、企业和科研人员开放,API 定价为每百万输入 token 2 美元、每百万输出 token 10 美元,缓存输入 token 享 95% 折扣。
推荐理由: 官方给出定价、基准排名和多个内部落地案例,可据此判断它在编码与科研工作流中的位置。
亚马逊科学提出 Priming 技术,通过利用预训练 Transformer 权重将混合状态空间模型的预训练成本降低 99% 以上,使开发者能够研究此前因成本过高而难以探索的问题。
Claude Code v2.1.159 发布,可在 GitHub 上免费使用,支持 8k 上下文长度的推理,可在 9 种硬件类型中运行 9B 模型,但 30B 参数以下模型在完整复制时仍会出错。
Multi-Agent Self-Supervision (MASS) 通过多智能体自我监督实现递归自我改进,使 27B 开放权重的模型在合成开放式研究任务上,第二轮循环后每个输出 token 的分数达到基准模型的 1.2-1.6 倍。
NVIDIA Omniverse 结合前沿 AI 模型如 GPT-6 Astra 帮助开发者实现模拟应用,通过自然语言指令指导 AI 代理完成资产组装、物理连接和渲染检查。
Amazon SageMaker HyperPod 通过 AWS IAM Identity Center 进行集中认证,使用 SageMaker AI 域提供定制用户体验,结合 Kubernetes 命名空间实现工作负载隔离,并利用 HyperPod 任务治理进行公平资源分配,支持多团队高效共享单个 HyperPod EKS 集群。
OpenAI 通过研究 o3 强化学习运行,识别出与元博弈相关的内部模式,发现元博弈涉及任务分析、评估意识、奖励寻求和规范推理等多个重叠过程,并在强化学习中增强。相关 SAE 潜在模式可追踪元博弈,并显著影响模型行为,部分潜在模式能影响模型答案而不在推理链中体现。
Mistral Large 4 是一个 1 万亿参数的原生多模态大语言模型,拥有 520 亿活跃参数,在编码、智能体工作流和多模态理解方面表现卓越,已达到全球最强开源模型的水平,并在网络安全、金融和法律等关键企业工作负载中表现领先。该模型将于本月末开源,目前可通过 Mistral Studio 的公测 API 体验。
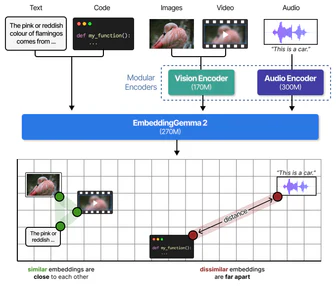
EmbeddingGemma 2 是基于 Gemma 4 开发的 740M 参数开源模型,将文本、代码、图像、视频和音频映射到统一 768 维空间,支持模块化加载(270M-740M 参数),在代码搜索和跨模态检索上表现优异,可通过 sentence-transformers 库使用。

开发者工作方式因 AI 而改变,除编写代码外,指导 AI、评估输出、沟通权衡和做出技术决策等技能日益重要。学习指导 AI 而非仅使用它,不轻信 AI 的首个答案并加以评估,以及利用 AI 解决更广泛问题,是开发者应加强的三种关键技能。
MAI-Transcribe-2-Streaming 以低延迟实时转录 60 种语言并支持自动语言检测,在 Artificial Analysis 上最终和部分转录准确率均排名第一。
Amazon Science 发布图形中心智能体技术,通过将网络表示为包含设备属性和连接的持续同步图(数字孪生),结合级联图算法(分解、聚合、溯源)和智能体编排,实现复杂网络故障的分钟级根因分析,在 NTT DOCOMO 的 MWC 演示中达到 95% 准确率。
Gemini 4 Argon 在复杂工作流程中提供前沿性能,支持软件工程、企业知识工作(法律和金融)以及网络安全防御。该模型的输出令牌限制扩展至行业领先的 1M,并在 DeepSWE v1.1(77.9%)、Vals Index(金融、编码、法律、税务)、AutomationBench(51.3%)等基准中领先。
稀疏视频生成(SVG)通过识别视频扩散模型中不同注意力头的时空结构,动态路由注意力头至空间或时间掩码,将理论上的稀疏性转化为实际端到端速度提升。在TPU v6e上,SVG保留约38.87%的查询-键对,实现3.5倍推理加速,同时保持给定稀疏度下的输出质量。该方案采用自定义JAX和Pallas Splash注意力内核,将理论稀疏性转化为硬件上的物理稀疏性。
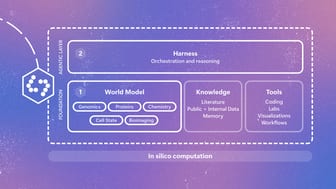
微软研究院发布了Quine,一个结合生物学多模态世界模型与交互式连接系统的AI研究平台,用于整合模型、科学工具、文献及研究人员,已用于预测驱动肿瘤状态变化的化合物并验证候选物;该系统为研究设计,非临床或医疗用途,输出可能不完整或需科研人员验证,未来计划通过微软发现扩大访问。