Apple Machine Learning Research3434
计划或检索优先?工具发现架构的规模研究
在 ToolBench 上,Retrieve-then-Plan (RtP) 在单工具查询中优于 Plan-then-Retrieve (PtR),而 PtR 在多工具查询中表现更佳,这一交叉点在所有检索预算(k=1至20)、注册表规模(1k至47k API)和模型族(Gemini 2.5 Flash 和 gpt-oss-120b)中均成立。
Apple Machine Learning Research3434在 ToolBench 上,Retrieve-then-Plan (RtP) 在单工具查询中优于 Plan-then-Retrieve (PtR),而 PtR 在多工具查询中表现更佳,这一交叉点在所有检索预算(k=1至20)、注册表规模(1k至47k API)和模型族(Gemini 2.5 Flash 和 gpt-oss-120b)中均成立。
 Google Developers Blog
评估 AI 智能体不能仅凭感觉检查,因为智能体可能陷入重试循环或产生幻觉回答却仍看似正常,导致云费用和 token 使用量激增。应建立可重复的评估流程,从定义关键用户旅程(CUJ)开始,使用模拟用户测试,并采用单元测试、确定性指标、LLM 作为裁判的评分标准和集成测试等多层检查。结合手动审查的跟踪记录与自动化验证,可在开发早期检测到隐性回归,并随着智能体能力增长扩展评估框架。
 Claude · YouTube
Claude Code 的云会话在云端虚拟机运行,支持离线持续、手机启动及并行处理。适用于 Pro、Max、Team 计划及企业高级或 Chat + Claude Code 座位用户,计入计划限制且无额外计算费用。
 Mistral AI · Hugging Face 新模型
Mistral AI 发布 Timestral-28M 时间序列基础模型,含 2800 万参数,采用基于 patch 的 Transformer 架构,上下文长度达 32,768 时间步,单次前向预测范围 1024 时间步,在 GIFT-Eval、TIME 和 fev-bench 评测中实现零样本预测的最优精度,模型已开源并采用 Modified MIT 许可证。
 LangChain Blog
LangChain Deep Agents 通过中间件管理上下文窗口,防止不必要信息进入并过滤已有内容。它采用卸载(将大工具结果和用户消息保存到文件)、摘要(压缩旧消息)、技能(按需加载)、子代理(分离噪声工作)和长期记忆(跨会话保存学习)等技术。这些技术通过在模型调用和工具调用等关键节点插入中间件实现,无需用户编写代码即可使用。
Mistral AI · Hugging Face 新模型Mistral AI 发布 Timestral-5M 时间序列基础模型,5M 参数版本支持零样本预测,上下文长度达 32,768 时间步,单次前向预测可覆盖 1,024 时间步,输出 21 个分位数。在 GIFT-Eval、TIME 和 fev-bench 评测中,Timestral-209M 实现零样本预测最先进精度,所有 Timestral 模型在其参数规模下均优于其他模型。
 OpenAI News4545
Third Moment Research 运行 10,000 个智能体 36+ 小时,其 AI 实验室使用 GPT-6 Astra 和 GPT-6.1 Sol、Codex 及 Daybreak 模型构建专注于长期任务并随使用改进的智能体。
 NVIDIA Blog
欧洲多个城市及软件、基础设施和集成合作伙伴正使用NVIDIA加速计算构建物理AI智能体和数字孪生系统,以优化城市运营决策。这些应用可预测维护需求、指导城市规划并提升公共服务响应能力,涉及比利时、芬兰、法国、意大利、荷兰、波兰、瑞典、英国等地。
Apple Machine Learning Research4040Apple Machine Learning Research 首次从零开始预训练文本、图像-文本和音频-文本数据的三模态掩码扩散模型(MDM),分析多模态扩展规律。
 IBM Research Blog5858
IBM Research 使用开源智能体工厂优化量子纠错硬件,高级综合评估实现 52 倍加速,成本约 26 美元;同等预算下闭源前沿模型配置成本 299 美元(11.5 倍更高)但加速 204 倍,开源配置以更小面积实现硬件优化;该智能体工厂通过协调器分配任务给并行工作智能体,结合代码修改与硬件效果评估,探索多种架构可能性。
 Cursor Changelog
Origin 应用市场今日开放公测,集成 Cloudflare、Linear、Sentry 等 20+ 工具支持部署、CI/CD、代码审查、安全、监控和项目管理,团队可提交应用上架。
Google Developers BlogGemini 4 Argon 在 11 小时内无人工干预运行中,通过分析 205,000 行代码的 ADK Python 仓库,提出了 6 项优化建议,最终 2 项被采纳并上线,将内存会话准备时间缩短约 40%,冷包导入速度提升 21%。该模型在优化过程中遵循了仓库的维护者指南,并运行了全部 16,892 个单元测试。
 GitHub Blog · AI & ML
GitHub Copilot 可通过自定义指令、代理技能、自定义代理和模型上下文协议(MCP)服务器等方式,让用户向 Copilot 传达项目规则、封装可重复流程、提供专业指导以及连接外部工具,从而提升协作效率。自定义指令定义代码规范,代理技能封装重复性任务,自定义代理处理复杂工作,MCP 服务器扩展 Copilot 功能。
 Anthropic Research
Claude Code v2.1.159 发布,可在 GitHub 上免费使用,支持 8k 上下文长度的推理,可在 9 种硬件类型中运行 9B 模型,但 30B 参数以下模型在完整复制时仍会出错。
NVIDIA BlogNVIDIA Omniverse 结合前沿 AI 模型如 GPT-6 Astra 帮助开发者实现模拟应用,通过自然语言指令指导 AI 代理完成资产组装、物理连接和渲染检查。
 AWS Machine Learning Blog
AgentCore 支付让 AI 代理能按需付费,Incarna 用它让代理逐个请求向 BlockRun 付费获取模型推理,BlockRun 为 90 多个模型提供按需计费推理服务。AgentCore 支付通过托管钱包、原生协议处理、基础设施层支出治理和可审计结算,将添加 x402 支持的工作量从数月缩短至数天。
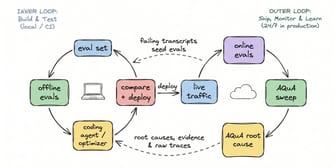
Google Developers BlogAQuA 运行在生产代理旁边,通过五阶段流程(采样、审查、聚类、验证、跟踪)分析生产轨迹,将常见问题聚类并生成实际/预期发现,帮助团队持续监控和改进代理质量。它使用开发者编写的目标文件和自定义指标来指导审查过程,并支持与 Gemini 平台的 AutoRaters 集成。
Anthropic ResearchAnthropic 推出可选漏洞发现服务 OSS Scanner,用 Claude Mythos 等大模型扫描开源代码,提供免费安全审计,但输出未经人工审核。该服务已向 48 个项目披露 97 个高危漏洞,其中 88% 符合 CVD 标准,收到 PostgreSQL、OpenSSL 等项目积极反馈。
 Claude Blog
Anthropic 使用 Claude Managed Agents (beta) 构建了一个 Agent 自动化参考实现,该实现按计划读取 Slack 和 GitHub 仓库等自定义来源,追踪自上次运行以来的变更,并将所需信息(例如发布到 Slack)进行发布。
AWS Machine Learning BlogAWS 提出自动化价值模型,重新定义智能体自动化商业案例。传统 RPA 投资回报模型忽略智能体自动化在异常处理、决策质量、流程适应性和价值实现方面的价值。企业需考虑释放工时的再部署价值或现金成本降低,以及异常修正成本,才能构建可信的商业案例。
 Mistral AI
Mistral Large 4 是一个 1 万亿参数的原生多模态大语言模型,拥有 520 亿活跃参数,在编码、智能体工作流和多模态理解方面表现卓越,已达到全球最强开源模型的水平,并在网络安全、金融和法律等关键企业工作负载中表现领先。该模型将于本月末开源,目前可通过 Mistral Studio 的公测 API 体验。
Cursor ChangelogCursor iOS 应用现支持查看和回复用户电脑上运行的本地智能体,默认开启(企业组织除外)。用户下载应用登录后,其账户电脑自动显示,经桌面端应用配对授权即可远程管理。远程控制仅连接智能体,不移动其运行位置,需保持电脑开机联网。
 Google Research
Google 研究发布新报告《开放与涌现的智能体隐私与安全问题:语境视角》,分析自主智能体面临的基础隐私与安全挑战,需系统、模型、用户及生态层面协同防御。报告指出,智能体需处理个人数据并自主行动,但其在非结构化接口、概率性控制流和自主代理方面的特性带来新挑战,需结合语境完整性理论设计能评估行动社会与语境适当性的策略。
LangChain BlogLangChain 为其开源编码代理 Open SWE 开发了模型路由器,通过分析任务类型和复杂度将请求分发至不同成本、速度和智能平衡的模型(GLM-5.3-Flash、GPT-5.6 Sol、GPT-6 Astra),将每线程中位数成本降低 64% 而不影响质量。
 LangChain Deep Agents releases3232
LangChain Deep Agents 0.7.21 发布,新增 `FilesystemMiddleware` 可在后端存储 blobs 功能。更新 urllib3 依赖至 2.8.0,并提高依赖版本最低要求。
 Microsoft Research
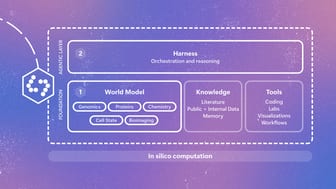
微软研究院发布了Quine,一个结合生物学多模态世界模型与交互式连接系统的AI研究平台,用于整合模型、科学工具、文献及研究人员,已用于预测驱动肿瘤状态变化的化合物并验证候选物;该系统为研究设计,非临床或医疗用途,输出可能不完整或需科研人员验证,未来计划通过微软发现扩大访问。
 Ollama Blog
Ollama 0.35 版本通过新增 /v1/systemone 端点支持基于 TypeSafe Jev API 的决策模型,可在本地运行以实现低延迟、类型化快速决策。
 Claude.dev Blog
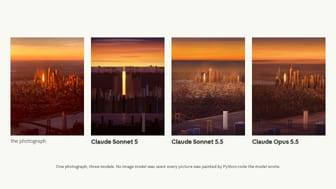
Claude Sonnet 5.5 是 Claude 5.5 家族继 Opus 5.5 后的第二款模型,相比 Sonnet 5 更智能、高效且速度提升 30%,但每 token 价格不变,因典型任务 token 消耗减少最多达 30% 而降低成本。
 Google DeepMind
 发布 Gemini 3.8 Flash TTS 和 Gemini 3.8 Flash-Lite TTS,支持从零创建自定义角色声音并直接控制场景对话。
Cursor ChangelogCursor 推出 Rollouts 和 Security Review 两个代码部署安全 Bot,Rollouts 通过监控部署过程报告环境健康状态,Security Review 在每个拉取请求中报告可利用漏洞,两者均已上线 Teams 和企业版计划。
 Claude 应用发布说明
Anthropic 发布 Claude Opus 5.5,该模型性能达到 Claude Fable 5.1 水平,运行成本比 Opus 5 低 40%。
Cursor ChangelogCursor今日推出Projects功能,支持处理大型工作体如功能开发、迁移或完整应用,可跨月维护上下文并自动分配给数千个子智能体执行重复任务。该项目在云端独立运行,通过共享文件同步代码库知识与工作偏好,协调智能体负责规划与任务分配。功能目前处于Beta阶段,今日开始向所有用户逐步开放。
 OpenAI Agents SDK releases1212
OpenAI Agents SDK v0.22.2 发布,新增对当前图像生成工具选项的支持,修复了 sandbox 模块中的文件 API 符号链接竞态问题及 sessions 模块中的压缩响应链重置问题,并更新了 v0.22.1 的行为说明文档。
Ollama Blog5858Ollama 的 Pro、Max 和 Team 计划现采用透明按 token 定价,每月包含使用额度。Pro 计划每月 20 美元(含 60 美元额度)、Max 100 美元(含 300 美元额度)、Team 500 美元(含 1000 美元共享额度)。免费计划提供少量起始模型额度,可付费按需扩展。
 智谱 Z.ai · Hugging Face 新模型
智谱 GLM-5.3-BF16 相较于 GLM-5.2 在 Z.ai Code Bench 上编码能力提升 50%,并在 Terminal Bench 3.0 和 Agents' Last Exam 等公共基准上达到开源模型最优;在 CyberGym 漏洞发现任务上表现顶尖,在 ExploitGym 利用基准上得分超倍提升。
LangChain BlogLangSmith Bring Your Own Cloud (BYOC) 已在 AWS 上正式提供,为企业提供可在其 AWS 账户和 VPC 中运行的托管 LangSmith 部署。
 Microsoft AI News
微软推出 MAI-Thinking-1 推理模型,35B 活性参数、~1T 总参数的稀疏专家混合模型,在 SWE-Bench Pro 上与 Claude Opus 4.6 并列,AIME 2025/26 分数达 97.0%/94.5%。该模型未使用第三方模型蒸馏,采用清洁、可追溯的企业级数据训练,并通过 Hill-Climbing 机制持续优化能力。
 MiniMax · Hugging Face 新模型
MiniMax Music 3 支持5分钟完整歌曲生成,结合8B Global LLM和0.6B Local LLM,通过歌词和音乐描述生成结构连贯、音质稳定的歌曲。模型采用连续隐藏状态合成系统,输出32 kHz/16位立体声WAV音频,支持通过[Verse]等标签和结构化描述实现精细控制。基于SGLang-Omni部署,输入歌词和描述即可生成音乐,无需离散tokenizer解码。
LangChain BlogStripe 在一周内基于 Deep Agents 构建了公司级 AI 助手 Kai,该平台预装 Stripe 上下文并整合 1000 余项技能,通过虚拟文件系统和沙箱执行机制实现生产级部署,员工可通过单会话界面访问内部数据仓库、Slack 和 Google 套件完成数据合成、文档起草等任务。
 Berkeley AI Research
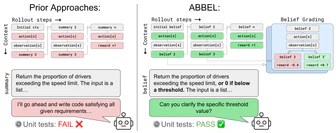
ABBEL框架通过自然语言信念状态替代完整交互历史作为智能体的工作上下文,并利用信念评分机制监督每个信念状态的内容,在协作代码生成任务上使模型性能接近完整上下文模型,同时将峰值上下文token长度减少约75%,训练步骤减少50%。