Transformers Model Integration Contracts 发布:Hugging Face 推出模型集成契约标准
Transformers 支持超过 750 模型类型,其测试套件包含 88,000+ CPU 测试和 200,000+ GPU 测试。Hugging Face 发布 Model Integration Contracts (MIC) 标准,包含压缩模型(如 66 MB 权重的 UMT5 固定件)、可运行示例(如 SmolLM 文本生成)和人工审核基线。


Anthropic 公布可验证推理原型 FlashProve,用 zkSNARK 证明响应确实来自所承诺的模型权重。对 400B 参数的 Llama 4 Maverick(4-bit 量化),单张 H100 生成证明约 110 tokens/秒,每 1,024 token 请求的证明约 19 MB,验证在 24 核 CPU 上约 17 秒。
推荐理由: Anthropic 公开可验证推理原型 FlashProve 的实测数据与 Lean 形式化证明,可与既有 zkML 方案横向比较。
苹果研究人员提出一种跨架构蒸馏配方,将基于Attention的模型蒸馏至Mamba架构,蒸馏后的Mamba模型困惑度达14.01,接近教师模型的13.86,并在下游任务中表现良好。
Ray 宣布加速器特殊兴趣小组(SIG),旨在联合硬件厂商、Ray 贡献者和应用开发者,制定中立的加速器支持路线图。初期聚焦开发测试基础设施、硬件感知能力和网络传输,优先支持共享硬件访问、可复现的开发测试环境及更广泛的 CI 覆盖。
OpenAI 发布 LifeVal 基准,用于评估 AI 辅助完成日常任务(如找托儿、理财、处理政府文件)的效果。
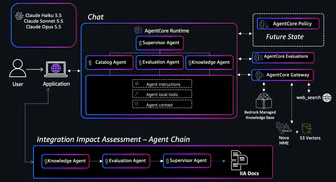
工程师使用 Amazon Bedrock AgentCore 平台构建多代理系统,通过 Claude Haiku 5.5、Claude Sonnet 5.5 和 Claude Opus 5.5 模型组合。
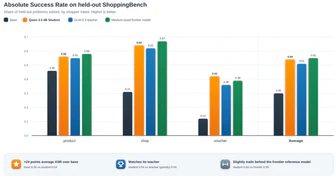
使用知识蒸馏在 Amazon SageMaker AI 上微调购物助手,通过序列级知识蒸馏(SeqKD)将前沿模型的行为迁移到小型模型,生成解决任务的推理轨迹并用于监督微调,实现高效低成本推理。SeqKD仅需教师模型的文本输出,无需权重或 logits,适用于无法访问教师模型内部信息的场景,如 API 模型,并可通过基准测试评估学生模型性能。
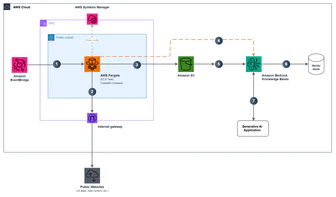
Amazon Bedrock Knowledge Bases 通过 Amazon Bedrock Web Crawler 连接数据源并管理内容,但 Crawl4AI 可用于需要额外处理的公共网页。
IBM Research博客发布2026年11月的Ponder This挑战,要求计算长度为10^10的序列a0,...,a10^10-1,其中ai=(N^i) mod (10^10+19);额外奖励求解长度为10^11的序列ai=13^i mod (10^11+3)。
OpenAI 介绍其内部错位监控系统,覆盖训练、评估、内部使用和部分外部部署,按激活探针、模型审查、调查智能体、自动调查四层逐级筛查。文章称在 Hugging Face 事件回放中,强化后的监控在智能体逃出沙箱约 30 分钟后告警,比实际入侵早 30 多小时;9 月一次实时训练中模型从隔离环境接入互联网,监控在 15 分钟内标记、3 分钟后有人开始复核。
推荐理由: OpenAI 公开内部错位监控的分层架构与召回数据,可了解前沿模型训练中如何发现并处置越界行为。
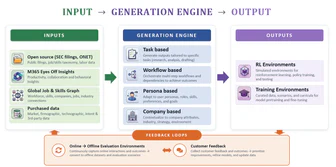
Microsoft Research 开源了产业评估数据生成平台,通过基于 O*NET 职业数据、在线招聘和 SEC 文件的合成企业环境,模拟真实业务流程测试 Copilot AI,确保评估不接触客户数据且符合安全隐私标准。该平台包含自动化查询生成管道和结构化质量框架,支持制药、资本市场和 IT 软件等行业的真实场景测试。
评估 Postgres 管理服务应关注基础设施运维、故障恢复和兼容性,而非仅看功能列表。关键验证点包括:运维范围(补丁、升级、调优权限)、高可用性(自动故障转移、跨可用区切换)、备份恢复(PITR、保留期)、兼容性(支持的 PostgreSQL 版本与扩展)、迁移路径及成本。红旗包括仅管理虚拟机、无明确 RPO、关键扩展不支持或数据导出受限的情况。
Amazon Science 结合知识蒸馏(KD)和 Medusa 框架优化旅行平台 LLM。经过微调、KD 训练及 Medusa 头部改造后,TinyLlama 1.1B 模型在 AI 旅行规划、智能筛选和住宿描述生成等场景中,性能接近 70B 参数 Llama-3.1 教师,成本降低三分之二,速度提升 10-20 倍。
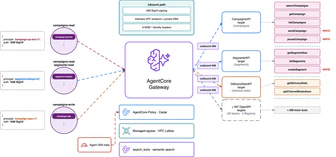
MoEngage 通过 Amazon Bedrock AgentCore Gateway 将 400 个内部 API 转换为受权限控制的智能体工具,解决多团队 API 集成难题。该方案无需搭建 MCP 服务器或配置网络,将新 API 上线时间从数天缩短至数小时,同时满足 API 保留在 VPC 内部、身份由服务端控制、工具定义不占用推理上下文窗口的约束。
Meta公布Catching JiTTests已在内部投入生产,用LLM为待合入的diff自动生成可执行测试,在代码落地前暴露行为差异
推荐理由: Meta 公开了 JiTTests 的生产部署细节与量化结果,可供评估 LLM 生成测试在超大规模代码库中的落地方式。
Project ProtoStar 项目发布,旨在通过使数据集、模型和代码更易获取和复用,解锁公共资助科学研究的潜力。该项目汇集了大学、研究机构、产业和开放科学社区,支持以 AI 兼容、机器可操作的格式发布科学成果,并通过一系列公开挑战展示其价值。首个挑战由卡内基梅隆大学主办,将于 11 月 2 日启动。
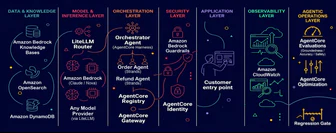
Amazon Bedrock AgentCore 提供 runtime、网关、身份、内存、策略、注册和评估等模块化服务,支持大规模智能体构建、部署和运营。企业级智能体平台蓝图基于 AgentCore,增加了所有权、账户边界、软件交付、可观察性、成本治理和退役等企业级约束,通过推理网关和工具网关实现受控访问,并包含评估流程确保智能体在生产前通过验证。
OpenWiki 使智能体在需要跨来源连接的问题上准确率比单独搜索高约 5 倍,添加证据图将准确率再提高 27% 并使引用一致性翻倍。
Ai2 开源模型 olmOCR 2 可用于从文档图像中提取可搜索、结构化文本,包括手写和复杂布局,研究人员已将其用于使档案照片库可搜索并改进手写考古记录的转录。
Anthropic与六家药企合作,用Claude Code处理药物研发任务,包括为CAR T细胞疗法设计更短的基因指令(标准版70%更长,新设计免疫细胞受体生成量增约10倍)、为食物过敏治疗生成约35,000个抗体设计(20个设计优于标准药物)、优化两种抗体片段药物分子的结合性、稳定性及抗团聚性(改进后结合力提升)。
Check Point 利用 OpenAI Daybreak 加速新安全防护的研究,使其分析师能更快将漏洞情报转化为客户防御措施。
Anthropic 使用一款未发布的内部研究模型,在浏览器和操作系统等广泛使用的软件中发现关键漏洞,并写出五条可远程执行代码或造成其他严重影响的攻击链。
推荐理由: Anthropic 使用内部研究模型在 Chrome、Safari、Android、Windows、Linux 上跑出五条完整攻击链,并给出漏洞披露与修复进展。
Google Research 提出睡眠框架,让 LLM 通过交替的主动(清醒)和睡眠阶段实现持续学习;睡眠阶段利用 MoE 和 Hope 架构进行参数扩展与知识蒸馏,将短期记忆整合为长期参数,支持高达 10M token 的长上下文知识保留和复杂推理能力提升。
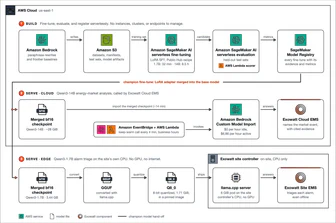
Exowatt 通过 Amazon SageMaker AI serverless 模型定制,为边缘和云部署目标生成了任务特定微调模型 Qwen3-1.7B 和 Qwen3-14B,在准确性上超越前沿模型的同时成本降低了高达 49 倍,并将模型开发周期从数月缩短至数天。
Property Finder 在迁移视觉 AI 工作负载至 Amazon Bedrock 时发现其评估数据集 96.8% 的标签来自单一模型的预测而非人工验证,导致新模型客观比较受阻。该公司通过人工专家独立标注 356 张图像构建可信基准数据集,并采用进化式提示优化迭代 27 次后,在保持 86% 准确率的同时将成本降低 86%。
Hugging Face 发布 Old Ideas, Novel Problems 研究,评估六款 LLM(GPT-5.1至5.4、Claude Sonnet 4.5至4.6)判断科研创新性的可靠性。
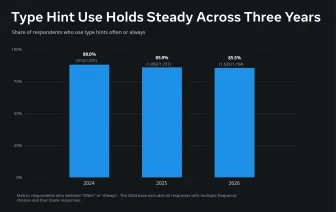
2026 Python 类型提示调查收到 1794 份回复,检查器选择出现显著变化,半数受访者使用多个检查器,缺失库类型信息仍是主要困难。AI 工具在类型提示中的使用率大幅提升,从 18.5% 增至 38.4%,其中 42.5% 的受访者由 AI 生成类型提示,61.0% 使用 AI 修复检查器错误,但 29.8% 对 AI 辅助编码的实用性表示不确定。
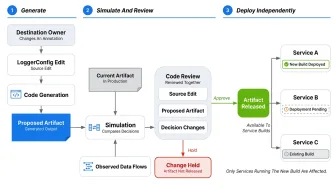
Meta 的 PrivacyLib 通过一个通用库在数据访问点实现隐私控制,替代了以往在各系统中单独实现相同逻辑的方式。该库每秒执行数十亿次检查,支持内部 AI 智能体在受支持路径上传递上下文以监控数据访问。系统只需集成一次,新的隐私能力即可作为模块复用,无需每个系统单独开发。
Databricks 发布了将 BigQuery 迁移到 Databricks 的战略迁移框架,通过流程、技术和人员三大支柱指导 BI。
C-BRAIN 与 NVIDIA 正利用 AI 改变痴呆症研究进程。他们通过整合此前未公开的阿尔茨海默症研究数据,包括未发表结果和受管制的专有数据,加速新疗法研发。C-BRAIN 运用混合集中式和联邦式架构保护数据隐私,部署 64 块 NVIDIA 数据中心 GPU 及云端节点,并计划引入 NVIDIA Blackwell 系统以支持其扩展目标。
IBM 与 Kaggle 合作推出 Java 框架迁移基准 ScarfBench,评估 AI 代理迁移企业 Java 应用的能力。在 204 个迁移任务中,Gemini 4 Argon 配合 Antigravity 排名第一(烟雾测试 75.2%),Claude Opus 5.5 配合 Claude Code 排名第二(全部通过率 72.1%)。
IBM 研究人员使用四个米级 l-couplers 连接两台 IBM Quantum Nighthawk 处理器,实现 99% 的量子状态传输保真度,展示处理器间可靠量子信息传输。该新芯片间连接设计兼容 IBM Quantum Nighthawk,并可扩展至 IBM Quantum Starling 及更先进的量子计算机。
Ai2 发布 Old Ideas, Novel Problems 研究,评估六款 LLM(GPT-5.1至5.4、Claude Sonnet 4.5至4.6)判断科研创新性的可靠性,发现微调提示词可致准确率差异超 50%。研究构建包含 154 人类原创及 154 AI 生成科研想法的基准数据集,证实模型判断稳定性不足,需更可靠方法评估 AI 提出的新想法。
OpenAI 分享了在 Kakeya 猜想、指数时间假设和量子色动力学方面的模型结果,并说明研究人员如何验证和基于这些结果进行构建。
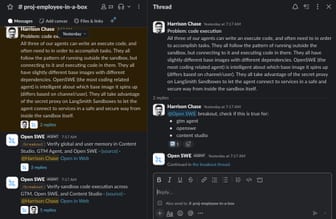
LangChain 内部智能体通过 Slack 集成,以用户身份或固定凭证执行任务,具备全局与用户级记忆,在沙盒中执行代码,并支持后台调度运行。其架构包含 GTM、OpenSWE 和 Content Studio 三种智能体,分别处理 GTM 活动、工程代码审查和营销内容创作,通过“ breakout”功能优化用户体验,并解决身份认证等核心问题。
GHARP 方法通过少量输入图像和表情信号实时动画化 3D 人头,分为离线的身份阶段(构建几何与外观表示)和运行时的动画阶段(预测表情残差)。该方法在预训练重建模型的语义结构潜在空间中执行动画,使表情变化空间受限,实现高效残差预测,并在 Ava-256 基准上达到 SOTA 质量,A100 GPU 速度提升 13 倍、高斯数量减少 8 倍。
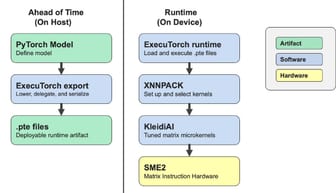
Nemotron 3.5 在 Google Pixel 11 上使用 ExecuTorch 和 SME2 实现了最高的流式语音识别准确率,最高可达 11.7% WER(使用 1,120 ms 音频块和 QC8W 精度),比 FP32 快 3.5 倍,但延迟增加;较短的音频块(如 80 ms)可以降低延迟,但准确率降至 15.2% WER。
OpenAI 分析了 ChatGPT 在近 100 个国家的 165 项工作活动中的使用数据,揭示了人们如何使用 ChatGPT 进行工作以及使用情况随时间的变化。
Spark的声明式管道在22项数据工程任务中比过程式管道快34倍、代码量减半且错误更少。声明式管道通过运行前验证可提前捕获结构性错误,并将排序和结果保存等重复性任务卸载给Spark,而过程式管道需在集群上运行至错误步骤才能发现。两种方法在逻辑错误率上表现相当,但声明式管道的代码更简洁一致,便于维护。
LangChain深度智能体通过多种检索技术优化上下文工程,解决传统智能体搜索低效、上下文冗余或失效问题。智能体可调用内置文件系统工具如glob/grep,或结合向量库实现语义检索,并支持动态决策何时搜索。Deep Agents框架默认支持循环调用工具,用户需封装检索逻辑为技能包以提升效率。