蚂蚁 inclusionAI · Hugging Face 新模型5858
inclusionAI/Qwen3.8-Flash-Next-singprobe 发布:基于 Qwen/Qwen3.8-Flash-Next 的流式安全探针
SingProbe 是一个基于 Qwen/Qwen3.8-Flash-Next 的流式安全探针,通过复用基础模型的隐藏状态在生成时每一步评分查询意图、响应不安全性和幻觉风险,解码时开销不到 0.5%。
蚂蚁 inclusionAI · Hugging Face 新模型5858SingProbe 是一个基于 Qwen/Qwen3.8-Flash-Next 的流式安全探针,通过复用基础模型的隐藏状态在生成时每一步评分查询意图、响应不安全性和幻觉风险,解码时开销不到 0.5%。
蚂蚁 inclusionAI · Hugging Face 新模型5858inclusionAI 发布基于 GLM-5.3-Flash 的轻量级流式安全探针 SingProbe,通过复用基础模型的隐藏状态实时评分查询意图、响应不安全性和幻觉风险。
 Codex releases00
Rust v0.165.0-alpha.1.2 发布,包含 143 个主要提交。
 Sakana AI
2026年,Sakana AI 发布了 Sakana Chat、Sakana Marlin、Sakana Fugu、Sakana Translate 等产品,从研发公司转向产品交付阶段,其 GTM 团队于 2026 年 9 月正式启动。
蚂蚁 inclusionAI · Hugging Face 新模型3838inclusionAI/Ling-3.0-flash-Sante-fp8 发布 FP8量化版本,保留124B参数(5.1B/Token)与BF16性能,降低内存并提升部署效率,支持医疗推理、研究及工具辅助工作流,需专业人工审核。在Healthbench、ReDisQA等基准上表现稳定,通过块状FP8量化(128×128块)实现高效推理。
 OpenAI News
OpenAI 分享了在 Kakeya 猜想、指数时间假设和量子色动力学方面的模型结果,并说明研究人员如何验证和基于这些结果进行构建。
OpenAI NewsOpenAI 推出 GPT-6.1 Terra,提供大规模快速且强大的计算机使用体验。
 OpenAI Deployment Safety5858
GPT-6.1 Terra 使用与 GPT-6 Astra 相同的数据和训练方式。在生物和化学领域被评估为高能力,因 Multimodal Troubleshooting Virology 跨越了指示阈值。
Codex releases1010GitHub Copilot rust-v0.165.0-alpha.2 发布,版本号 0.165.0-alpha.2。
蚂蚁 inclusionAI · Hugging Face 新模型1010inclusionAI 发布 LBS-27B 大语言模型,参数规模为 27B,但未提供 README 内容和具体基准分数,当前未部署任何推理提供商。
蚂蚁 inclusionAI · Hugging Face 新模型5858inclusionAI/Ling-3.1-flash-base 发布,560B 总参数、25B 活跃参数的稀疏 MoE 架构大模型,采用混合线性注意力机制(63 KDA + 9 Gated MLA),在 47 个跨八个领域的基准测试中表现优异,支持持续预训练、领域适应和后训练研究,模型使用 FP8 精度训练,BF16 精度发布,遵循 MIT 许可证。
 腾讯混元 · Hugging Face 新模型精选7171
腾讯混元在 Hugging Face 发布 Hy-Nomas 的 BF16 Diffusers 格式蒸馏权重,该视频世界生成模型支持通过文本指令和相机控制进行多轮自由交互,逐段生成同一世界。
推荐理由: 官方放出蒸馏版 BF16 Diffusers 权重和配套基准,读者可据此判断多轮交互式世界生成的实际用法与门槛。
OpenAI NewsOpenAI 加强了前沿模型训练和评估的隔离措施,包括离线环境和高性能红队演练。
腾讯混元 · Hugging Face 新模型腾讯混元发布 WeVisOne-VL-2B 模型,基于 Qwen3-VL 构建,集成 9.5M 参数像素解码器,支持目标级感知(开放词汇目标检测、指向定位、计数、指向和 OCR)与像素级感知(指向分割和可提示 alpha 摩擦),适用于视觉定位、指向、计数、OCR 定位、指向分割和图像摩擦等研究任务。
腾讯混元 · Hugging Face 新模型腾讯混元发布 WeVisOne-VL-4B 模型,基于 Qwen3-VL 构建,集成 9.6M 参数像素解码器,支持目标级感知(开放词汇目标检测、指向定位、计数、指向和 OCR)与像素级感知(指向分割和可提示 alpha 摩擦),适用于视觉定位、指向、计数、OCR 定位、指向分割和图像摩擦等研究任务。
 vLLM Blog5858
vLLM 在 NVIDIA Blackwell、Rubin 和 AMD MI350 系列显卡上为 MiniMax-M3.1-Flash 提供零日支持,在智能体工作负载上表现优异。
 AWS Machine Learning Blog
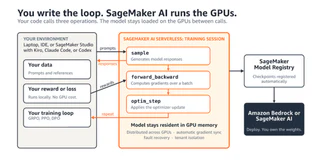
SageMaker AI 推出无 GPU 管理的模型定制功能,用户可通过训练会话控制后训练逻辑,无需管理底层基础设施。支持 SFT、DPO、RLVR、RLAIF、多轮 RL 等技术,并可选择 LoRA 或全量微调。
 Hugging Face Blog
Hugging Face发布IBM Granite时间序列模型集成预测方案,结合四款Granite模型(PatchTST-FM-r1、PatchTST-FM-r2、FlowState-r1.1、TTM-r3)提供无微调的集成预测。
腾讯混元 · Hugging Face 新模型精选7272腾讯混元发布 Hy-SimulMT 实时同声传译模型,支持中英双向语音到语音翻译,并具备实时声音克隆能力。在 RealSI 长音频评测中,其 StreamLAAL 约为 3 秒,为对比系统中最低,GEMBA 分数超过所比较的开源模型和五个商业 API 中的四个。
推荐理由: 官方给出实时同传的延迟与质量对比数据,并开放 GGUF 权重和推理部署脚本,可据此评估落地方式。
腾讯混元 · Hugging Face 新模型精选7373腾讯混元发布 Hy-SimulMT 实时同声传译模型,支持中英双向语音到语音翻译,并可在说话过程中持续输出译文文本与语音,同时通过实时声音克隆保留说话人音色。在 RealSI 长音频评测中,其 StreamLAAL 约为 3 秒,为对比系统中最低,GEMBA 分数高于所比较的开源模型和五个商业 API 中的四个。
推荐理由: 官方给出实时同传的延迟与质量对比,并开放模型权重和推理部署脚本,可据此评估落地方式。
腾讯混元 · Hugging Face 新模型精选7373腾讯混元发布并开源 Hy-SimulMT-30B-A3B 系列实时同传模型,支持中英双向语音到语音翻译和实时声音克隆,同时输出译文文本与语音。在 RealSI 长音频评测中 StreamLAAL 约 3 秒,为对比系统中最低,GEMBA 分数超过所比开源模型和 5 个商业 API 中的 4 个。
推荐理由: 官方给出实时同传的延迟与质量对比,并开放模型权重和推理部署工具,可据此判断落地条件。
腾讯混元 · Hugging Face 新模型精选7474腾讯混元发布 Hy-SimulMT-30B-A3B 实时同声传译模型,支持中英双向语音到语音翻译并实时克隆说话人音色,已在 Hugging Face 开源多个版本。
推荐理由: 官方给出与开源模型、商业 API 及专业同传译员的对比数据,可据此判断实时同传的质量与延迟取舍。
腾讯混元 · Hugging Face 新模型精选7272腾讯混元发布并开源实时同声传译模型 Hy-SimulMT-30B-A3B,支持中英双向语音到语音翻译,可在说话过程中持续输出译文文本与语音,并支持实时声音克隆。
推荐理由: 官方给出实时同传的延迟与质量对比,并开放多个量化版本和推理部署脚本,可据此评估落地成本。
腾讯混元 · Hugging Face 新模型精选7575腾讯混元发布并开源 Hy-SimulMT-30B-A3B,支持中英双向语音到语音实时同声传译,边接收音频边输出译文文本和语音,并支持实时声音克隆。在 RealSI 长音频评测中,其 StreamLAAL 约为 3 秒,为对比系统中最低,GEMBA 分数高于所比较的开源模型和五个商业 API 中的四个。
推荐理由: 原文给出中英双向同传的延迟与质量对比数据,并附开源权重和部署方式,可据此判断实时语音翻译的可用程度。
 PyTorch Blog
TorchTitan 新增对 Muse Spark Open、Muse Glimmer、Qwen3-VL、Qwen3.5、Kimi K2.7、Kimi K3 和 DeepSeek-V4 等最新 SOTA 模型的原生 PyTorch 支持。
Hugging Face Blog精选7878NVIDIA 发布预训练关系型基础模型 Kumo Relational,可直接在企业数据库上做预测,无需任务特定训练、特征工程或表展平。模型在 15 个数据库的 41 个任务上超过监督式关系深度学习和专家特征工程梯度提升树,在 SAP SALT 基准上 MRR 比 AutoGluon 集成高 8%。
推荐理由: 原文给出预训练关系模型在 41 个任务上的对比结果与开源入口,读者可据此判断它能否替代现有 XGBoost 流水线。
Hugging Face Blog5858IBM 发布了 Granite Speech 5.0 系列的三款模型,granite-speech-5.0-2b 在 390,000 小时数据上训练,支持 6 种语言互译及 2。
蚂蚁 inclusionAI · Hugging Face 新模型3535inclusionAI 发布 Ling-3.0-tiny 的 UBTree 技术微调版本 Ling-3.0-tiny-UBTree-B16,参数量 183.1M,结合五层 DFlash 主干和 bigram 选择器,在 GSM8K、MATH-500 等基准上实现 2.6-3.5 倍速度提升。该模型需与目标模型配合使用,UBTree 适配 SGLang 的开源版本尚未发布。
Hugging Face Blog5858NVIDIA 发布多变量时序预测模型 Kumo Forecast(原 NV-Tesseract Forecasting),以 MOMENT-1-large 为骨干,约 3.4 亿参数编码器加可训练预测头,编码器与嵌入层权重冻结。
 NVIDIA Blog精选6262
NVIDIA 扩展其开放模型家族,覆盖语言、机器人、生物和量子计算,包括新的 Nemotron 3.5 Super VL 与 Nemotron 3.5 Bolt。
推荐理由: NVIDIA 一次性铺开语言、机器人、生物、量子四条线的开放模型,读者可据此判断其开源生态的覆盖范围。
 Mistral AI5050
Mistral 与 NVIDIA 合作将 AI 模型与 NVIDIA 加速计算和物理建模工具整合,加速工程模拟并实现闭环 AI 驱动设计。合作将推出公共基准和开放数据集,标准化物理和智能体 AI 在计算机辅助工程中的评估,并利用 NVIDIA Omniverse 进行 3D 模拟和资源创建。
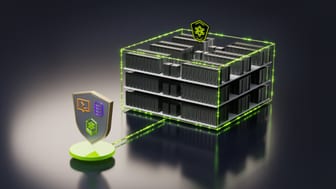
NVIDIA Blog5555NVIDIA Confidential Computing 通过硬件根隔离和加密认证保护模型和数据执行,新增 Confidential Bare Metal 部署选项,使前沿模型构建者能在第三方基础设施上运行敏感工作负载并保留模型数据控制权。
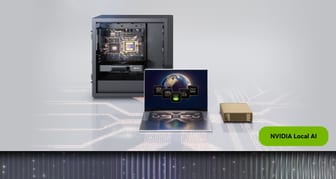
NVIDIA BlogNVIDIA 在 GTC Berlin 上展示了其本地 AI 硬件全阵容,RTX Spark 已上线支持 Windows PC 上的个人智能体,DGX Spark 支持开发者构建和扩展 Linux 应用,DGX Station 则为 Linux 企业团队运行前沿工作负载,Windows 版将于 12 月推出。
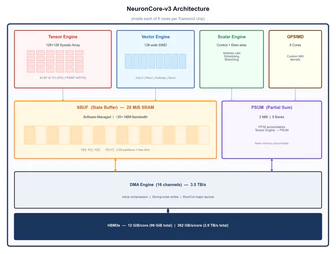
AWS Machine Learning Blog3232Deepgram 通过 AWS Trainium2 将 Nova-3 语音识别模型部署到 PyTorch,在单个 trn2.3xlarge 实例上运行 8 个副本,处理离线批处理工作负载时每美元可处理 11-70% 更多音频,并使用 NKI 库和 Neuron Explorer/NAD 工具链进行内核级调优,提升推理效率。
AWS Machine Learning Blog5858TwelveLabs 的 Pegasus 1.5 视频语言模型现已在 Amazon Bedrock 上提供,可将长视频转换为结构化、带时间戳的元数据,支持基于用户定义标准分析整个视频并返回匹配片段的 JSON 数据,分析时长扩展至每请求两小时,无需预索引且数据保留在 AWS 边界内。
AWS Machine Learning Blog3131Amazon SageMaker JumpStart 上线以来已集成 100 多个来自 30 家提供商的新模型,涵盖 Qwen 3.8-27B、Cosmos3 系列等。
AWS Machine Learning Blog5858Amazon Bedrock 现在支持所有 Anthropic Claude 模型的结构化输出,包括 bedrock-runtime 和 bedrock-mantle 端点。
AWS Machine Learning Blog3939i14 将其 24 层解码器 Laplace 3B(3,072D 参数,使用 Gated Linear Attention 架构)部署到 AWS Trainium2 上,实现每秒 120,000 个 token 的训练速度和 11,544 个输出 token 的并发推理能力。
OpenAI News4242Terminal X 的 Eval Agent 使用 GPT-6.1 评分达 88.6%,基于 54 条标准评分,能比其他方案多发现 25% 的基金使命偏差。
 Databricks Blog
Databricks 将 RFD4-Proteina 模型集成到 Genesis Workbench,支持在 AI 运行时环境中执行,并与研究数据和工作流程连接。开发者可通过 Genie Code 和 NVIDIA BioNeMo Agent Toolkit 技能构建和调整管道,利用 serverless NVIDIA GPU 计算进行蛋白质设计。