AWS Machine Learning Blog3434
在 AWS 上使用 AtScale 和 Amazon Bedrock AgentCore 构建语义层以支持智能体 AI
AtScale 作为语义层,通过 Semantic Modeling Language (SML) 在 Amazon Redshift 上构建维度模型,支持 Amazon Bedrock AgentCore 中的 Strands 智能体,实现跨系统 Customer 360 分析。
AWS Machine Learning Blog3434AtScale 作为语义层,通过 Semantic Modeling Language (SML) 在 Amazon Redshift 上构建维度模型,支持 Amazon Bedrock AgentCore 中的 Strands 智能体,实现跨系统 Customer 360 分析。
 OpenAI News
OpenAI 改进 ChatGPT 在低资源编程语言中的表现,推出针对软件工程、SQLite 和 COBOL 迁移的新评估
 Hugging Face Blog5858
ALTK-Evolve 使用 GPT-4.1 学习并应用客户服务剧本,在 τ²-bench 客户服务代理基准测试中超越零售领域所有零售条目,得分达 67.5% Pass^4,且无需更新模型权重。该模型基于基本 ReAct 代理和 GPT-4.1,通过分析任务尝试并使用 GPT-4.1 将成功与失败蒸馏为简短行为规则,然后将这些指南添加到代理的系统提示中,无需权重更新或人工标注。
 Anthropic Research
Claude 在 64 小时内自主生成 318,484 个蛋白质设计并筛选 180 个用于测试,与 Adaptyv Bio 和 Twist Bioscience 合作实验验证 211 个设计,其中 17 个符合结合标准,所有设计数据已公开。专家认为这是针对蝎子神经毒素的首次 AI 设计尝试,可能加速对忽视疾病的药物发现。
 Meta Engineering
Meta工程师通过构建一个1,300行的精简路由器,将20+工作流分配给14个专业AI代理,路由器自身不执行任何领域工作,显著提升了数据管道代理的效率和准确性。
 IBM Research Blog2222
Coursera 新课程《AI 数据流架构:从原理到实践》教授工程师如何跨 GPU、TPU、Cerebras WSE、Groq LPU 和 IBM Spyre 加速器工作。课程由 IBM 研究院高级研究科学家 Kaoutar El Maghraoui 主讲,通过六门课程和动手实验覆盖执行模型、编译、内存系统、调试和性能建模,强调不同架构如何影响模型性能及编译器优化关键作用。
 Together AI Blog
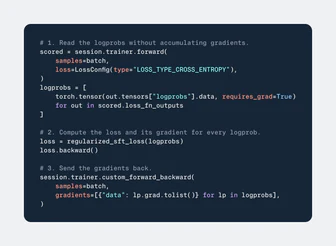
Together AI 推出 Post-Training 服务,支持通过强化学习和监督微调构建定制模型,无需复杂基础设施。该服务提供灵活的训练循环定义能力,并优化底层系统与基础设施以提升模型质量与训练速度。支持 Muse Spark Open、GLM 5.3、Kimi K3 和 Qwen 3.8-27B 等主流开源模型,运行在专属 GPU 资源上,确保高效且数值一致的训练。
 腾讯混元 · Hugging Face 新模型
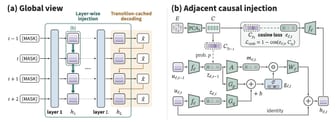
混元发布 Qwen3-8B-DSpine-b16,采用并行草稿与深度条件注入的推测解码技术,在 Qwen3-8B 上实现 10.55 的平均接受长度分数。模型支持 8192 token 上下文长度,使用 bfloat16 数据类型和 fa3 注意力后端,安装需 git clone 并 pip 安装,通过 sglang serve 运行。
腾讯混元 · Hugging Face 新模型混元发布的 Hy-Memory-30B-A3B-FP8 是一个 3B 活跃参数的紧凑长期记忆写入模型,用于高效 vLLM 部署,在固定 20% 基准矩阵的跨 harness 宏平均得分中表现优于 Claude Opus 5 和 DeepSeek V4.1 Flash。
 Ollama Blog
Reflection 的首个开源权重模型 Beam 已于今晨全面推出,Ollama 作为首发合作伙伴限时免费提供该模型,其 Beam 端点支持完全零数据保留(ZDR)。
 Microsoft AI News
微软AI完成新MoE大模型MAI-Base-2的预训练,拥有80亿活跃参数和2.8万亿总参数,在内部评估中超越所有开源模型。该模型比开源最强基座模型DeepSeek-V4-Pro-Base预训练FLOPs效率高出4-12倍,并用于训练更大模型。微软通过全栈控制,使用有机数据预训练,计划通过Foundry授权模型权重。
 NVIDIA Blog
NVIDIA 发布 120B 参数的 Nemotron 3.5 Super VL 开源模型,在多模态智能体任务中实现最快任务完成速度和最高准确率;同时推出 Nemotron 3.5 Bolt 74B-A9B 24GB 和 Nemotron 3.5 Bolt E4B 4GB 边缘模型。
 Mistral AI · Hugging Face 新模型
Mistral AI 发布 Timestral-123M 时间序列基础模型,参数量 123M,采用 patch-based Transformer 架构,上下文长度 32,768 时间步,单次预测可覆盖 1,024 时间步,输出 21 个分位数。该模型在 GIFT-Eval、TIME 和 fev-bench 评测中实现零样本预测的最优精度,并采用 Modified MIT 许可证。
Mistral AI · Hugging Face 新模型Mistral AI 发布 Timestral-28M 时间序列基础模型,含 2800 万参数,采用基于 patch 的 Transformer 架构,上下文长度达 32,768 时间步,单次前向预测范围 1024 时间步,在 GIFT-Eval、TIME 和 fev-bench 评测中实现零样本预测的最优精度,模型已开源并采用 Modified MIT 许可证。
 阶跃星辰 · Hugging Face 新模型
阶跃星辰发布旗舰模型 Step-5-Preview-NVFP4,600B 总参数、27B 活跃参数,支持高达 1M 上下文窗口,在软件工程、专业知识工作及金融领域表现突出,可处理文本、图像和视频,通过 OpenAI 兼容 API 或离线生成部署。
 Google DeepMind
Gemini 4 Argon 在 Vals Index 上排名第一,以 175B 参数规模在编码、金融、法律、网络安全和科学等领域超越其他前沿模型,其推理深度和精度使它成为解决复杂工程问题、优化业务流程和加速科研突破的利器。
 LangChain Blog
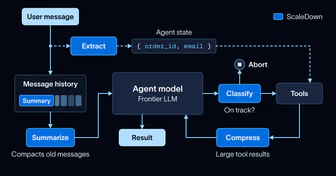
ScaleDown 通过压缩和提取技术优化长时运行智能体的上下文管理,其模型在基准测试中比 GPT-5.5 等通用模型便宜 41 倍且快 2.7 倍。ScaleDown 提供四种模型:Summarize、Compress、Extract 和 Classify,分别用于摘要、压缩、提取和分类,支持最多 1M tokens 的输入,并支持图像和 PDF 输入。
 Microsoft Research
微软研究院开源多模态模型StudentSim用于模拟学生学习行为,通过公开脱敏学习记录训练个性化学生模拟器,在棋类、英语写作和数学领域表现优于基准,为AI辅导系统提供早期反馈信号,不用于替代教师或课堂教学。
 Google Research
Google Earth AI 的 Population Dynamics Foundation Model (PDFM) 将搜索趋势、人口流动、建筑环境密度和环境因素压缩为位置嵌入,无需特定任务微调即提升多种疾病领域和地理环境的流行病学研究表现。
 Mistral AI
Mistral Large 4 是一个 1 万亿参数的原生多模态大语言模型,拥有 520 亿活跃参数,在编码、智能体工作流和多模态理解方面表现卓越,已达到全球最强开源模型的水平,并在网络安全、金融和法律等关键企业工作负载中表现领先。该模型将于本月末开源,目前可通过 Mistral Studio 的公测 API 体验。
 Google Developers Blog
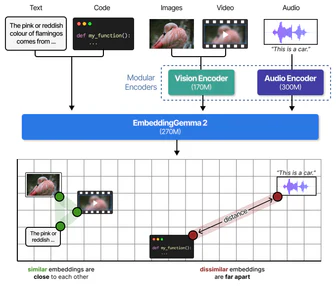
EmbeddingGemma 2 是基于 Gemma 4 开发的 740M 参数开源模型,将文本、代码、图像、视频和音频映射到统一 768 维空间,支持模块化加载(270M-740M 参数),在代码搜索和跨模态检索上表现优异,可通过 sentence-transformers 库使用。
Google Research谷歌研究发布新一代基于可信执行环境(TEE)的联邦学习系统,通过在TEE内执行加密训练数据和发布访问策略到公共透明日志Rekor,实现完全可验证和可审计的数据匿名化,Gboard已采用该系统并显著提升计算速度。
NVIDIA BlogNVIDIA DGX Spark 64GB 配备 64GB 统一内存,由 Acer、ASUS、Dell、Gigabyte、HP 和 MSI 推出,支持开发者、研究人员和 AI 爱好者本地运行高达 1000 亿参数的模型,无需云依赖。两台设备可通过 NVIDIA Sync Cluster Assistant 集群,内存合并至 128GB,性能提升 1.7 倍,价格从 4999 美元起。
Anthropic Research精选7171Anthropic 发布机器人暴露指数研究,用 Claude 评估 O*NET 约 1.9 万个任务,发现现有机器人可完成美国 74% 的体力任务、占全部工作时间的 34%,但多数限于受控环境。
推荐理由: Anthropic 用 Claude 给 O*NET 任务逐条评级,量化机器人当前能覆盖多少工作,并给出成本与监管的约束条件。
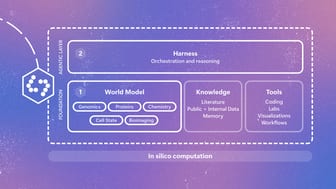
Microsoft Research微软研究院发布了Quine,一个结合生物学多模态世界模型与交互式连接系统的AI研究平台,用于整合模型、科学工具、文献及研究人员,已用于预测驱动肿瘤状态变化的化合物并验证候选物;该系统为研究设计,非临床或医疗用途,输出可能不完整或需科研人员验证,未来计划通过微软发现扩大访问。
Anthropic Research在 Project Swap 实验中,201 名 Anthropic 员工通过 Claude 智能体进行书籍交易,61% 的智能体能准确匹配员工偏好。智能体在交易中表现良好,但效率受限于信息不足。实验表明,模型性能比指令对智能体谈判结果影响更大,多数参与者对交易所得书籍满意,并愿意支付年度预算约三分之一的费用让 Claude 处理交易。
Anthropic Research精选8080Anthropic 成立生命科学研究组并自建实验室,让 Claude 智能体在 DNA 序列数据库中自主搜索,发现了一种与 DNA 重复序列相关的新型酶系统 ART(array-associated reverse transcriptases)。
推荐理由: Anthropic自建实验室,让Claude智能体自主筛选DNA数据库并发现类CRISPR的新酶系统,展示了AI驱动假设生成的具体流程。
阶跃星辰 · Hugging Face 新模型阶跃星辰发布旗舰模型 Step-5-Preview-BF16,600B 总参数、27B 活跃参数,支持高达 1M 上下文窗口,在软件工程、专业知识工作及金融领域表现突出,可处理文本、图像和视频,通过 OpenAI 兼容 API 或离线生成部署。
阶跃星辰 · Hugging Face 新模型阶跃星辰发布旗舰模型 Step-5-Preview,采用 600B 总参数、27B 活跃参数的稀疏 MoE 架构,支持高达 1M token 上下文,兼顾软件工程、专业知识和金融任务,在 DeepSWE v1.1 评测中表现优异。模型可通过 vLLM 或 SGLang 以 OpenAI 兼容 API 方式部署,或使用 Transformers 进行离线生成。
Google DeepMindGoogle DeepMind 发布 AlphaGenome Atlas 平台,包含对人类基因组 90 亿个单核苷酸变异的预测结果,为学术研究提供免费网站入口。
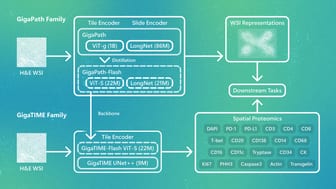
Microsoft ResearchGigaPath-Flash 和 GigaTIME-Flash 通过精简的 ViT-S 编码器显著降低了计算需求,在保留性能的同时使大规模病理学研究更易实现。
Anthropic Research5858Anthropic 通过 Anthropic Insights 允许外部研究机构分析 25 万条 Claude 对话数据,这是首次外部研究人员能独立研究 AI 公司自身使用数据。
 智谱 Z.ai · Hugging Face 新模型
智谱推出 GLM-5.3-Flash,首个原生多模态 GLM-5 系列,320B 总参数仅 18B 活性参数,基准测试与实际任务表现优于 GLM-5.2,价格仅为其十分之一,编码与智能体测试接近 Claude Opus 4.8
智谱 Z.ai · Hugging Face 新模型智谱发布 GLM-5.3-Flash,首个原生多模态 GLM-5 系列模型,拥有 320B 总参数和 18B 活性参数,在基准测试和实际工作负载中超越 GLM-5.2,价格仅为其十分之一,编码和智能体基准测试接近 Claude Opus 4.8。
Anthropic Research精选7878Anthropic 公布两项实验结果:Claude(Mythos Preview 与 Opus 4.8)针对 15 个靶点设计蛋白质结合物,成功覆盖 14 个,单靶点模式下命中率 35.1%,高于当前蛋白质设计活动常见的 10-15%。
推荐理由: Anthropic 公布 Claude 在蛋白质设计与分析化学上的实测结果,并给出湿实验验证数据与提示词。
 Thinking Machines
 发布开源语言模型 Inkling 和 Inkling-Small,允许用户拥有、运行和定制。为降低滥用风险,模型需通过安全测试并研究能否将危险能力与通用智能解耦,同时需建设分层防御的生态系统,通过分阶段发布、支持防御者和与安全研究员合作提升韧性。内部评估和外部测试显示,发布 Inkling 不会带来现有开源模型已存在的重大增量风险。
Microsoft AI NewsMAI-Cyber-1-Flash 模型在 CyberGym 评测中实现 96% 评分,成本仅为当前 MDASH 最佳方案的 50%,专为 MDASH 执行器优化。
 Berkeley AI Research
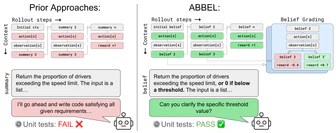
ABBEL框架通过自然语言信念状态替代完整交互历史作为智能体的工作上下文,并利用信念评分机制监督每个信念状态的内容,在协作代码生成任务上使模型性能接近完整上下文模型,同时将峰值上下文token长度减少约75%,训练步骤减少50%。
Berkeley AI ResearchGPT-4-class 能力成本每月已降至不到 1 美元,推理价格年均下降 50 倍以上。智能体将主导数据系统工作负载,催生三方面新挑战:为智能体设计数据系统需支持 agentic speculation 并优化重复查询;需构建能管理智能体集群状态、协调共识的智能体专属数据系统;需让智能体合成可信赖的自定义数据系统。
 Meta AI Blog
Meta AI 发布 Brain2Qwerty v2,非侵入式脑机接口实时解码句子,词准确率达 61%;v1 训练代码及数据集开源,v1 数据集由合作方 BCBL 发布。