AWS Machine Learning Blog2828
Amazon Bedrock 在印度推出 Kimi K3 推理服务
Amazon Bedrock 现在支持在印度境内对 Kimi K3 进行推理,满足严格的数据本地化需求。客户 Ultrahuman 通过 API 调用该服务,使 AI 健康助手能处理每日超 14,000 次对话,同时将健康数据保留在 AWS 内部,成本降低 80%,多轮对话速度提升 85%。
AWS Machine Learning Blog2828Amazon Bedrock 现在支持在印度境内对 Kimi K3 进行推理,满足严格的数据本地化需求。客户 Ultrahuman 通过 API 调用该服务,使 AI 健康助手能处理每日超 14,000 次对话,同时将健康数据保留在 AWS 内部,成本降低 80%,多轮对话速度提升 85%。
AWS Machine Learning Blog3434使用 EDB Postgres AI 在 Amazon Bedrock AgentCore 上运行 Strands Agents,通过查询语义层回答客户 360 (C360) 问题。
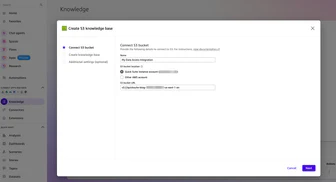
AWS Machine Learning Blog3232Amazon Quick 通过连接 Amazon S3 和创建知识库整合结构化与非结构化数据,用户可使用单一对话式 AI 代理查询。该解决方案包含数据层(存储在 S3 的非结构化内容和作为语义数据集的结构化数据)、工作空间层(将数据类型整合到单一工作空间)和代理层(自定义聊天代理链接到工作空间并返回组合响应)。
 PyTorch Blog
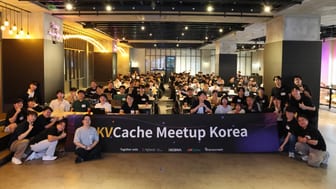
PyTorchKR 与 XCENA 于 2026 年 9 月 30 日联合举办 KVCache Meetup Korea,XCENA、SK hynix、FuriosaAI 和 LMCache 的演讲者分享了 LLM 推理及 KV 缓存优化的成果。
 Ai2 Blog
StateBench 是一个用于测试大语言模型追踪长文档中实体状态变化的基准,包含 R-trivial、非周期、可解和一般有限四个难度等级。研究发现,循环和混合模型在直接训练这些任务时泛化能力远超 Transformer,而 Gemini 3.8 Flash、Claude Opus 5.5 和 GPT-6 Sol 等前沿模型在输入变长时仍难以处理更复杂的状态追踪问题。
 NVIDIA Newsroom
NVIDIA 与合作伙伴正将物理 AI 和智能体 AI 扩展到全球城市,通过共享计算基础设施支持市政部门、邻近市镇及本地开发者构建服务,无需各组织单独采购和管理资源。
PyTorch Blog3434Ray 宣布加速器特殊兴趣小组(SIG),旨在联合硬件厂商、Ray 贡献者和应用开发者,制定中立的加速器支持路线图。初期聚焦开发测试基础设施、硬件感知能力和网络传输,优先支持共享硬件访问、可复现的开发测试环境及更广泛的 CI 覆盖。
 Google AI Blog6262
Google 回顾 2026 年 10 月 AI 更新,Gemini 4 Argon 作为前沿推理模型已在 Google AI Studio、Gemini API
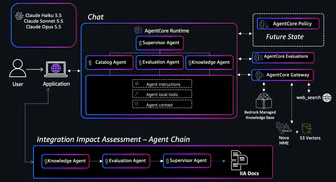
AWS Machine Learning Blog3434工程师使用 Amazon Bedrock AgentCore 平台构建多代理系统,通过 Claude Haiku 5.5、Claude Sonnet 5.5 和 Claude Opus 5.5 模型组合。
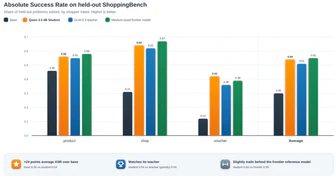
AWS Machine Learning Blog4343使用知识蒸馏在 Amazon SageMaker AI 上微调购物助手,通过序列级知识蒸馏(SeqKD)将前沿模型的行为迁移到小型模型,生成解决任务的推理轨迹并用于监督微调,实现高效低成本推理。SeqKD仅需教师模型的文本输出,无需权重或 logits,适用于无法访问教师模型内部信息的场景,如 API 模型,并可通过基准测试评估学生模型性能。
 Moonshot AI · Hugging Face 新模型
Kimi K3.1 Pro 是 Moonshot AI 开源的多模态智能体模型,参数量 2.8T,激活参数 104B,上下文窗口 1M tokens,在编码、3D 创建、金融研究等领域表现优异。与 Kimi K3 相比,采用 Gated DSA 层提升长文本处理效率,在 Terminal-Bench 4.0 等评测中超越 Claude Fable 5.1 和 GPT-6 Astra 等竞品。
 蚂蚁 inclusionAI · Hugging Face 新模型3838
inclusionAI 发布 ZwZ2-9B GGUF 格式权重,属于 Zooming without Zooming v2 项目,包含语言模型(FP16, Q8_0, Q4_K_M)和视觉编码器及投影器(mmproj,FP16, Q8_0, Q4_K_M),需搭配 llama.cpp Qwen3.5 多模态支持使用,支持 CLI 推理和 Web Chat 部署。
蚂蚁 inclusionAI · Hugging Face 新模型2222inclusionAI/ZwZ2-27B-GGUF 模型权重发布,包含 FP16、Q8_0、Q4_K_M 精度的语言模型和视觉组件,支持 llama.cpp 多模态推理。
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI/ZwZ2-4B-GGUF模型权重发布,该模型为Zooming without Zooming v2的一部分,分为语言模型(FP16, Q8_0, Q4_K_M)和视觉编码器及投影器(mmproj,FP16, Q8_0, Q4_K_M),提供多种精度组合,需配合lla.cpp(支持Qwen3.5多模态)使用。
 Databricks Blog4747
Databricks 宣布 Spark Declarative Pipelines Real-Time Mode 正式可用,该模式通过持续流式处理、并行查询阶段和即时数据传递实现毫秒级端到端延迟。
 Codex releases4545
Codex 0.166.0 发布,新增键盘驱动转录选择(支持词、行、页操作)、集成搜索和可配置快捷键,以及 Markdown 在异步问题、选项、答案和转录回复中的一致性渲染。同时支持 GPT-6.1 Terra,并添加 codex queue --resume 功能以恢复卸载线程。
 Amazon Science
 结合知识蒸馏(KD)和 Medusa 框架优化旅行平台 LLM。经过微调、KD 训练及 Medusa 头部改造后,TinyLlama 1.1B 模型在 AI 旅行规划、智能筛选和住宿描述生成等场景中,性能接近 70B 参数 Llama-3.1 教师,成本降低三分之二,速度提升 10-20 倍。
AWS Machine Learning Blog4242NVIDIA 在 AWS 上推出 120B 参数的 Nemotron 3.5 Super VL 模型,该模型每激活 12B 参数处理一个 token,结合推理和工具使用,支持文本、图像、文档和视频理解。
 vLLM Blog精选同一件事 · 2 家7878
vLLM 宣布在发布当天支持 Mistral Large 4,这是一个 1 万亿参数、每 token 激活 49B 的 MoE 原生多模态模型,采用 MLA 加 DSA 稀疏索引器,并内置 DSpark 投机解码草稿模型。
 Hugging Face Blog精选同一件事 · 2 家8585
Mistral 发布多模态 MoE 模型 Mistral Large 4(Le Chonk),约 1T 总参数、49B 激活参数,上下文窗口 1M tokens,提供 FP8 与 NVFP4 两个官方版本,另有 Unsloth 和 llama.cpp 团队制作的 GGUF。
推荐理由: 原文给出 1T 总参数、49B 激活的 MoE 多模态模型在网络安全与编码基准上的具体分数,并附本地与端点部署实测吞吐。
 ByteDance Seed · Hugging Face 新模型
ByteDance-Seed/GenFirst 训练一个潜在 VAE 并联合一个生成先验,避免通常使端到端训练不稳定的潜在崩溃。该方法的两个阶段计划用于先验和熵权重:第一阶段让先验塑造潜在几何形状,第二阶段将两者权重十倍降低,使解码器恢复细节。
 LangChain Blog
OpenWiki 使智能体在需要跨来源连接的问题上准确率比单独搜索高约 5 倍,添加证据图将准确率再提高 27% 并使引用一致性翻倍。
PyTorch Blog5858PyTorch® 2.15 发布,默认采用重写的 NCCL 后端,支持故障记录和回滚;torch.distributed 新增 NIXL 后端的单边传输;FSDP2 和流水线并行优化内存通信控制。
 Meta Engineering
Meta Andromeda 下一代广告检索引擎通过模型-系统协同设计,在检索层实现近排名级模型性能,单卡单秒处理超过 10 亿广告,系统吞吐量达 1000 亿次/秒,较 2024 年版本提升 100 倍,并为广告主带来 2.4% 的转化率增长。
 Google Developers Blog3434
Google 发布对话式商务工作原型 HappyDelivery,基于 LangGraph 和 Gemini 在 GCP 上实现;Ingress 层通过 GKE/Cloud Run 和 Cloud Pub/Sub 处理来自 WhatsApp 的输入
Hugging Face Blog精选7676Liquid AI 发布 LFM3 新一代 Liquid Foundation Models,以 LFM3-1.7B-Base 为共享骨干派生六个 2B 级模型,覆盖文本、视觉、音频、全模态和决策,全部在 Hugging Face 开放权重。
推荐理由: Liquid AI 用同一 2B 级骨干派生六个模态模型,并给出单卡微调与端侧部署路径,可据此判断小模型专用化路线。
 Google Research5858
Google Research 提出睡眠框架,让 LLM 通过交替的主动(清醒)和睡眠阶段实现持续学习;睡眠阶段利用 MoE 和 Hope 架构进行参数扩展与知识蒸馏,将短期记忆整合为长期参数,支持高达 10M token 的长上下文知识保留和复杂推理能力提升。
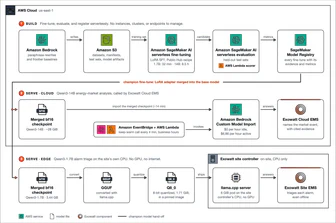
AWS Machine Learning Blog3434Exowatt 通过 Amazon SageMaker AI serverless 模型定制,为边缘和云部署目标生成了任务特定微调模型 Qwen3-1.7B 和 Qwen3-14B,在准确性上超越前沿模型的同时成本降低了高达 49 倍,并将模型开发周期从数月缩短至数天。
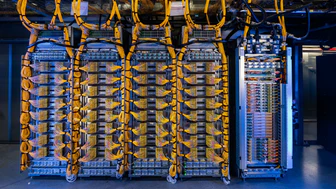
NVIDIA Newsroom5858NVIDIA Vera Rubin NVL72 和 NVIDIA Vera CPU 现已在 Oracle Cloud Infrastructure (OCI) 上正式提供,计划引入 HGX Rubin NVL8 系统以帮助组织加速前沿模型训练、提高推理效率并扩展智能体工作负载。
 Google DeepMind精选8484
Google DeepMind 发布世界模型 Genie 4,可实时生成带原生音频的交互式模拟世界,并以文本提示实时改变天气、镜头和场景元素。Genie 4 首次原生生成环境音与人声对话,角色可实时对话并响应场景事件;Gemini 3.8 Flash 在循环中充当引导智能体,把目标拆成步骤并逐帧校验。
推荐理由: 官方披露了原生音频、实时文本操控与 Gemini 引导推理三项能力,可据此判断世界模型在机器人与内容预演中的位置。
 IBM Research Blog3838
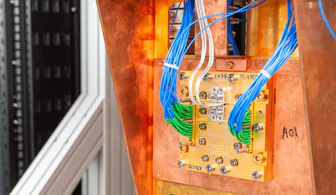
IBM 研究人员使用四个米级 l-couplers 连接两台 IBM Quantum Nighthawk 处理器,实现 99% 的量子状态传输保真度,展示处理器间可靠量子信息传输。该新芯片间连接设计兼容 IBM Quantum Nighthawk,并可扩展至 IBM Quantum Starling 及更先进的量子计算机。
蚂蚁 inclusionAI · Hugging Face 新模型5858inclusionAI/Ling-3.1-flash-1019 发布,560B 参数量,25B 活跃参数/Token,1M 上下文窗口,推理能力提升,AA-Briefcase 分数 1524 Elo,AutomationBench-AA 68%,Artificial Analysis Intelligence Index v4.3.2 44 分。支持 SGLang 和 vLLM 推理。
蚂蚁 inclusionAI · Hugging Face 新模型3838inclusionAI/Ling-3.0-flash-Sante-fp8 发布 FP8量化版本,保留124B参数(5.1B/Token)与BF16性能,降低内存并提升部署效率,支持医疗推理、研究及工具辅助工作流,需专业人工审核。在Healthbench、ReDisQA等基准上表现稳定,通过块状FP8量化(128×128块)实现高效推理。
 LangChain Deep Agents releases
LangChain Deep Agents 的 deepagents-code==0.2.2 版本发布,包含安全与性能改进。新增 GPT-6.1 Terra 支持、选中文本输入至聊天、插件更新检测等功能;修复项目 .env 文件设置信任值、终端 UI 链接限制、Git 选项限制等 Bug;通过重用父进程上下文、优化服务器启动流程、精简转录渲染等提升性能,推荐尽快升级。
Databricks Blog2222Databricks Free Edition 允许师生免费在浏览器中运行完整数据或 AI 课程,无需云合同或许可证管理,适用于全球学生和教育工作者。该平台提供协作笔记本、Spark、Delta Lake、Lakeflow、Databricks SQL、Genie 代码助手等功能,支持从入门编程到 AI 项目的各类课程,技能直接应用于行业标准工具,无生产环境与教学沙箱的转换成本。
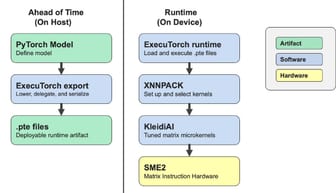
PyTorch Blog3434Nemotron 3.5 在 Google Pixel 11 上使用 ExecuTorch 和 SME2 实现了最高的流式语音识别准确率,最高可达 11.7% WER(使用 1,120 ms 音频块和 QC8W 精度),比 FP32 快 3.5 倍,但延迟增加;较短的音频块(如 80 ms)可以降低延迟,但准确率降至 15.2% WER。
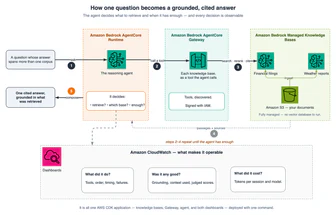
AWS Machine Learning Blog4848使用 AWS CDK 在 Amazon Bedrock 管理知识库上构建企业级智能检索,通过 AgentCore 提供的推理代理和 AgenticRetrieveStream API 实现多轮规划和工具驱动检索,返回带引用的答案。该方案部署包含 Amazon S3 语料库、知识库和推理代理的 CDK 应用,支持语义路由和多次检索,并内置 Amazon CloudWatch 监控和评估功能。
蚂蚁 inclusionAI · Hugging Face 新模型5858inclusionAI/Ling-3.1-flash-base 发布,560B 总参数、25B 活跃参数的稀疏 MoE 架构大模型,采用混合线性注意力机制(63 KDA + 9 Gated MLA),在 47 个跨八个领域的基准测试中表现优异,支持持续预训练、领域适应和后训练研究,模型使用 FP8 精度训练,BF16 精度发布,遵循 MIT 许可证。
 腾讯混元 · Hugging Face 新模型精选7171
腾讯混元在 Hugging Face 发布 Hy-Nomas 的 BF16 Diffusers 格式蒸馏权重,该视频世界生成模型支持通过文本指令和相机控制进行多轮自由交互,逐段生成同一世界。
推荐理由: 官方放出蒸馏版 BF16 Diffusers 权重和配套基准,读者可据此判断多轮交互式世界生成的实际用法与门槛。
AWS Machine Learning Blog5858Amazon SageMaker AI 通过多轮强化学习(MTRL)训练模型执行序列任务,用户无需提供正确轨迹,只需定义结果评分。以 Wordle 游戏为例,将 GPT-OSS-20B 模型的解决率从 61% 提升至 84%(默认推理力度),成本约 339 美元。