跳到正文
实时
10月8日周四
  1. AWS Machine Learning Blog

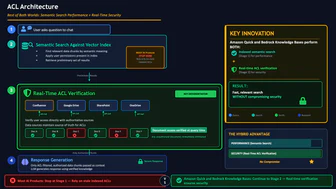
    Amazon Quick 和 Amazon Bedrock Knowledge Bases 如何通过实时 ACL 执行重新思考 RAG 访问控制

    Amazon Quick 和 Amazon Bedrock Knowledge Bases 通过实时访问控制列表 (ACL) 执行解决 RAG 访问控制难题,在查询时直接与权威源验证权限,避免依赖可能过时或错误映射的 ACL 数据。该系统采用两阶段架构:第一阶段进行预检索过滤,第二阶段实时调用数据源 API 验证候选文档,在性能与安全间取得平衡,确保 AI 响应始终符合最新权限要求。

  2. Anthropic Newsroom

    Anthropic 推出网络安全使命计划,聚焦关键基础设施与开源软件安全

    Anthropic 发布网络安全使命计划,通过前沿模型、现场工程师和威胁研究支持防御者。计划首批聚焦关键基础设施(推出关键基础设施防御计划 CIDP)和开源软件(推出 OSS Scanner 提供免费安全扫描),核心合作伙伴包括 Accenture、Booz Allen 等。该计划旨在应对 AI 被恶意利用的风险,并缓解防御者资源短缺问题。

10月7日周三
  1. AWS Machine Learning Blog

    Qlik 如何在 Amazon Bedrock 上构建企业级可信 AI

    Qlik Answers 通过整合企业数据源,让员工能以自然语言获得可信答案,自 2026 年 2 月正式发布以来已实现日均使用。该系统采用分层架构,通过路由层将问题分发至知识库、实时分析、文档等不同来源,并利用 Amazon Bedrock 的基础模型生成答案,同时应用 Guardrails 进行内容过滤和事实核查。

  2. AWS Machine Learning Blog

    AWS 设计六周计划帮助非技术人员构建 AI 原型以缩小 AI 知识与能力差距

    AWS 设计六周计划帮助非技术人员构建 AI 原型以缩小 AI 知识与能力差距。四名无工程背景的客户面专业人员通过该计划,六周内开发出获得第一名的 WealthWise 多智能体 AI 金融咨询工具。该计划采用结对导师制和 Amazon Bedrock 等生产级工具,参与者需遵循五项原则:优先学习而非获胜、每日例会、从最小可行产品(MVP)开始迭代、主动寻求指导、保持趣味性。

  3. OpenAI Alignment Blog

    OpenAI 研究语言模型中的元博弈潜在模式

    OpenAI 通过研究 o3 强化学习运行,识别出与元博弈相关的内部模式,发现元博弈涉及任务分析、评估意识、奖励寻求和规范推理等多个重叠过程,并在强化学习中增强。相关 SAE 潜在模式可追踪元博弈,并显著影响模型行为,部分潜在模式能影响模型答案而不在推理链中体现。

  4. Claude 应用发布说明

    Anthropic 发布 Claude Haiku 5.5,Max 和 Team 计划获月度 API 信用额度

    Anthropic 发布了 Claude Haiku 5.5,这是其最便宜、最快且功能最强的微模型,专为高容量、成本敏感型任务设计。Max 和 Team 计划现包含月度 API 信用额度,用于在 Claude 平台上运行自有应用和智能体,通过在设置 > 计费(Max)或组织设置 > 计费(Team)中关联 Claude 控制台组织即可申领。

  5. Microsoft Research

    Microsoft Research 主持人 Chad Atalla 与 Jennifer Neville 对话:AI 的错误与失败教训

    Microsoft Research 主持人 Chad Atalla 与 Jennifer Neville 探讨 AI 评估在推动 AI 系统性能边界中的作用,以及模型超出传统基准测试时出现的“令人惊讶的失败”。Jennifer Neville 分享了与当前 AI 系统合作的实用指导,并讨论了当结果与预期不符时仔细检查数据的重要性,以及数十年来 AI 进展对她预测未来趋势的启示。

  6. Microsoft Research65

    Agent Lightning 通过其现有的框架训练代理

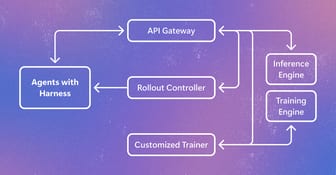
    Microsoft Research 的 10 月 7 日技术概述介绍了重建的 Agent Lightning v1.0:约 3,500 行控制平面代码、以 Kubernetes 作业方式运行的智能体,以及一个让现有 harness 参与强化学习的 LLM 代理。据报告,其 Qwen3.5-9B 编码流水线使用约 6,000 个样本,将 SWE-bench Verified Pass@1 从 41.8% 提升至 56.4%。

    推荐理由: 编辑观点:训练环境应当与部署的智能体相似。在采用之前先检查已发布的工作流;这些结果描述的是作者的编码实验,运行训练仍然需要算力和基础设施。这是一篇技术概述,并非声称该框架于今日首次发布。

  7. Liquid AI58

    Liquid AI 发布了用于边缘设备的开放权重决策模型

    Liquid AI 在 Hugging Face 上发布了 d1-3B 和实验性 d1-omni-600M。这些模型在单次前向传播中选择答案,而不是生成 token 序列。d1-3B 接受文本和图像;较小的实验模型还支持文本和音频输入。该公司报告 d1-3B 在 RTX 4090 上为 8 毫秒,在 Jetson Orin Nano 上为 50 毫秒。

    推荐理由: 编辑观点:受限选择或路由任务可能不需要完整的聊天模型。请在你自己的答案选项和硬件上评估这些模型;延迟数据为发布方的测量值,较小的检查点明确为实验性。

  8. vLLM engineering42

    vLLM 解释了 DeepSeek-V4.1-Flash 的 5.3× 吞吐量提升

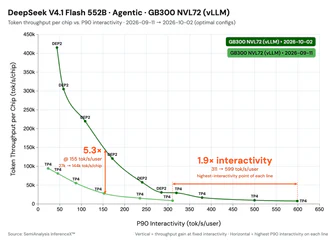
    Inferact 和 vLLM 团队在经过三周的优化后,报告称在 150-tokens-per-second 的限制下,低并发服务的速度提高了 1.9×,吞吐量提高了 5.3×。这些更改结合了滑动窗口注意力的有界重放、CUDA 图和融合内核。他们的帖子解释了缓存重建和跳过提示词预填充的某些部分如何减少服务工作量。

    推荐理由: 编辑要点:仅凭模型基准测试无法描述服务成本。这份工程分析有助于识别缓存和内核瓶颈;所报告的收益适用于其基准测试条件,而非每一次部署。

  9. OpenAI News

    GPT-6为ChatGPT带来互动答案

    OpenAI宣布了一项结合GPT-6和智能UI的ChatGPT推广计划:在对话中生成视觉解释、交互式比较和小工具。可用性取决于计划和时间表。

    推荐理由: 编辑要点:互动答案可能改变团队呈现信息的方式。此公告涉及ChatGPT;它不会宣布Work或Codex所使用的模型的变更。

  10. Anthropic75

    Claude Haiku 5.5 针对快速、高容量的 AI 工作负载

    Anthropic 发布了 Haiku 5.5,用于摘要、分类和代理子任务。对于最多 100,000 个 token 的提示词,其公布的 API 价格为每百万输入 token 0.10 美元,每百万输出 token 0.50 美元;更大的提示词有单独的价格层级。此次发布还将 Sonnet 5.5 的缓存读取价格减半至每百万 token 0.10 美元。这些是 10 月 8 日核实的出版商列出的价格。

    推荐理由: 编辑观点:工作负载路由与模型选择同样重要。在将每个请求发送给更昂贵的模型之前,先在较小的模型上测试常规任务;供应商的评估并不能为你的应用确立结果。

  11. LangChain55

    Deep Agents 仅在读取相关技能时才加载工具

    LangChain 更新了 Deep Agents,增加了三个控件:将工具绑定到技能、在第一次模型调用之前固定请求的技能,以及在运行线程期间重新加载技能库。绑定的工具架构在需要之前保持在上下文之外;支持对话中途工具的模型可以保留缓存的提示词前缀。

    推荐理由: 编辑要点:对于大型技能库,应将指令和工具一起加载,而不是在启动时暴露所有工具。请检查你的模型是否支持对话中途更改工具;重新加载已更改的技能仍会修改系统提示,并可能使其缓存失效。

10月6日周二
  1. LangChain Deep Agents releases35

    LangChain Deep Agents 0.1.81 发布

    LangChain Deep Agents 0.1.81 发布,支持发现 marketplace 插件、在运行时打开 effort selector、显示成本明细,新增 `--no-tracing` 选项和显式追踪状态指示器。修复了并发写入本地线程、钩子执行上下文变更时的失败问题,改进了服务器端模型目录和交互式模型元数据处理。

  2. Mistral AI

    Mistral AI 推出 Mistral Large 4 公测版

    Mistral Large 4 是一个 1 万亿参数的原生多模态大语言模型,拥有 520 亿活跃参数,在编码、智能体工作流和多模态理解方面表现卓越,已达到全球最强开源模型的水平,并在网络安全、金融和法律等关键企业工作负载中表现领先。该模型将于本月末开源,目前可通过 Mistral Studio 的公测 API 体验。

  3. Claude.dev Blog

    Claude Code 云会话:云会话领域指南

    Claude Code 云会话在独立虚拟机上运行,每个任务获得克隆到新分支的代码库,互不干扰。用户可通过 claude.ai/code、移动应用、桌面应用、终端或 Slack 启动,支持浏览器、移动应用和桌面应用追踪。Pro、Max、Team 或 Enterprise 计划用户免费使用,无需额外费用,且与 Claude Code 其他使用限额共享。

  4. Google Developers Blog

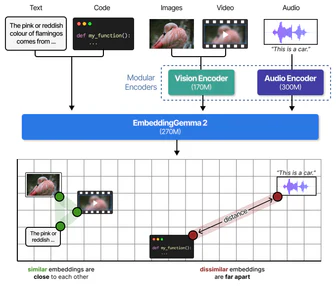
    EmbeddingGemma 2开发者指南

    EmbeddingGemma 2 是基于 Gemma 4 开发的 740M 参数开源模型,将文本、代码、图像、视频和音频映射到统一 768 维空间,支持模块化加载(270M-740M 参数),在代码搜索和跨模态检索上表现优异,可通过 sentence-transformers 库使用。

  5. Google Research

    Google 研究探讨智能体隐私与安全问题中的开放与涌现挑战:从语境角度出发

    Google 研究发布新报告《开放与涌现的智能体隐私与安全问题:语境视角》,分析自主智能体面临的基础隐私与安全挑战,需系统、模型、用户及生态层面协同防御。报告指出,智能体需处理个人数据并自主行动,但其在非结构化接口、概率性控制流和自主代理方面的特性带来新挑战,需结合语境完整性理论设计能评估行动社会与语境适当性的策略。

10月5日周一