IT之家 · AI6565
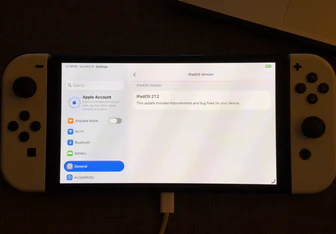
开发者在任天堂 Switch 上成功运行 iPadOS 27 并启用液态玻璃效果
开发者 brunostjohn 成功将 iPadOS 27.2 原生移植至任天堂 Switch 并启用 Liquid Glass 效果,直接在 Switch 的 NVIDIA Tegra X1 芯片上运行,部分场景可达 60 FPS,但 GPU 驱动仍需修复,硬件兼容性完成约 90%。
IT之家 · AI6565开发者 brunostjohn 成功将 iPadOS 27.2 原生移植至任天堂 Switch 并启用 Liquid Glass 效果,直接在 Switch 的 NVIDIA Tegra X1 芯片上运行,部分场景可达 60 FPS,但 GPU 驱动仍需修复,硬件兼容性完成约 90%。
 Hacker News · AI 热帖6565
使用 Claude Code 或 Codex 从终端工作时,用户常因任务多线程处理导致脑力耗竭。作者通过将工作组织成类似优先队列的方式,在 git 中管理任务,每项任务为 markdown 文件,状态为 git 快照。AI 智能体按循环处理新任务、运行测试和浏览器检查,但无法做决策,需用户在“所有者收件箱”中处理,并通过 Claude 工具单页查看任务,完成后再关闭,实现一次处理一项任务。
 Simon Willison6565
Claude Code 或 Codex 生成的 PR 描述过于冗长,但隐藏在 HTML details/summary 元素中可优化阅读体验。将模型名和努力程度作为 summary,例如“Claude Opus 5.5 Medium”,读者可快速获取核心信息。GitHub Markdown 支持此功能,点击展开箭头查看完整内容,使 PR 不再显得杂乱。
llama-modchip 发布了一组 ggml/llama.cpp 内核补丁与量化转码工具,将 284.33B 的 DeepSeek-V4-Flash 压缩到 56.56 GiB(1.71 bpw),可在 64 GB 内存的纯 CPU 机器上运行,256K 上下文下峰值内存 57.61 GiB 且无需 swap。
推荐理由: 项目给出了在 64 GB 内存上运行 284B MoE 的量化方案与内核补丁,并附各硬件实测数据,可据此判断纯 CPU 部署的可行边界。
 量子位4242
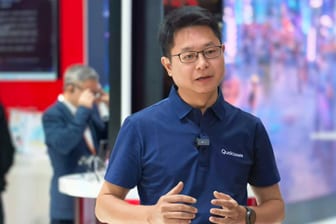
高通在第九届进博会展出端侧MoE智能体,推动终端侧AI从单点应用走向智能体体验。MoE技术通过混合专家模块提升端侧模型智能水平,在20亿至30亿参数规模下实现更高复杂度任务完成度。高通与Infris AI、江波龙、阶跃星辰合作优化模型、推理、存储和芯片平台,展示终端侧AI生态协同的系统性方案。
 The Decoder5858
安德烈·卡帕西在周末使用 Claude 的 Opus 5.5 模型构建了 HackerTube 视频平台,该平台通过过滤 20 年 Hacker News 的 4300 万条评论并提炼成 6454 个视频,提供了比 YouTube 更好的推荐体验。
IT之家 · AI6565任天堂《塞尔达传说:时之笛》重制版于 11 月 5 日登陆 Switch 2 后,开发者已成功在越狱版 PS5 和 iPhone 上运行。PS5 版本基于 EglantinePS5 项目,12.40 固件下帧率约 15-20 FPS,但存在内存不足和渲染问题,补丁由 Claude 编写。
 GitHub Blog · AI & ML3838
GitHub Copilot 在 canvases 上支持跨设备会话连续性,让用户在云沙箱中执行任务,通过 Copilot 应用隔离仓库编辑,用存储指令和共享记忆的项目知识提升效率,并可选择 Copilot Fusion 模型匹配工作需求。
 Claude · YouTube4242
Salesforce 将 Claude Code 扩展至数千名工程师,使有效产出翻倍且每行代码的 Bug 数减少。该公司工程领导与斯坦福研究人员共同构建的“有效产出”评分体系衡量 AI 编码 ROI,并通过智能体成熟度曲线引导工程师从简单提示词过渡到全自主智能体。
 O'Reilly Radar5858
Claude Code 通过 CLAUDE.md 指令、技能、子代理和钩子提供对代码实现过程的详细控制,钩子可解释拒绝操作或返回编译或策略失败,但外部生命周期控制仍需其他层。
 Browser Use
Claude Code v2.1.159 发布,支持 8k 上下文窗口,在 SWE-bench Verified 上表现优异; Anthropic 推出 Browser Use 开源库,让 AI 智能体通过 Chrome DevTools Protocol 控制浏览器,提供 Browser Use Cloud 和 Browser Use Agents 服务。
 Databricks Blog
Databricks 应用用户量从几人到数千后,如何使应用快速响应且高可用。设计阶段需确定性能(如 p95 延迟)和可扩展性(如峰值用户数)目标,并规划架构以分离状态和依赖。推荐使用 AppKit 框架,将重计算任务移至 Databricks Sandbox,通过水平扩展(增加实例)和垂直扩展(提升计算规格)应对负载增长。
 NVIDIA Technical Blog5555
NVIDIA DSX OS 可配置、认证和操作 Kubernetes GPU 集群,解决单个 GPU 性能低下导致分布式训练任务缓慢的问题。该系统通过在节点替换、驱动程序修补等集群生命周期各阶段进行性能监控,确保集群稳定性。
 LangChain Blog
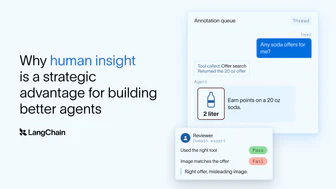
LangChain 探索人类反馈三原则提升智能体开发:专家判断定义质量标准,完整上下文评估,将反馈转化为可复用数据;通过 agent trace 记录用户交互与模型行为,人工标注评分并附理由,用于校准自动化评估器、改进评估标准与构建黄金数据集,形成专家知识可复用资产。
 IBM Research Blog3838
HRL 实验室开发出采用先进算法的惯性测量单元(IMU),提供不间断的 GPS 替代方案。其 MEMS 惯性传感器尺寸如汤罐,精度接近 GPS,并解决长期困扰的偏差漂移问题,通过 AutoCal 自动校准系统持续修正误差,实现无限导航支持。该 IMU 采用 ASIC 和先进封装技术优化成本与尺寸,适用于无人机等轻型载体。
IT之家 · AILichii模拟器已可通过电脑运行《塞尔达传说:时之笛》重制版,但帧率在15-30 FPS间波动且存在画面异常。原生移植版本尚仅能运行开场部分。
量子位353511月10日,上海将举办「源点 ORIGIN:Data + AI 技术实践巡展」,分享 Data Agent 落地完整链路。蚂蚁密算、合合信息等5位专家将介绍本体、知识引擎、Harness 工程及可信智能体实践。活动免费,面向对 Data Agent 落地感兴趣的开发者。
IT之家 · AI6565网友用 Claude Code 成功越狱 NordicTrack 跑步机,绕开 iFIT 订阅墙,将设备大屏幕改造成可自由使用的流媒体界面。改造过程约一天半完成,项目已公开至 GitHub,集成 Netflix、Crunchyroll 等应用,Netflix 启动时间缩短至约 21 秒,但最高仅支持标清画质且可能影响保修。
IT之家 · AI6565TVPort 开源项目基于 nxnative 工具包和 Claude Opus 5.5,让 Apple TV 4K 原生运行 Switch 游戏《超级马力欧:奥德赛》,实现 60FPS 运行,偶有轻微卡顿。项目需用户自行提取游戏数据,使用改装 Switch,并非面向普通用户方案。
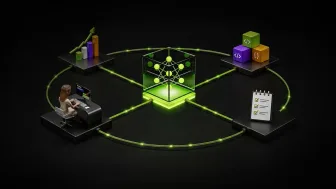
NVIDIA Technical Blog6565NVIDIA 开发了 AI Factory Operations Agent 智能体来简化 DGX SuperPOD 内部运营,通过单一界面自动关联计算、网络、硬件和调度问题,帮助 SRE 识别训练性能下降原因。该智能体可处理多仪表盘数据,提升运营效率。
Claude · YouTube在 Claude 中创建和共享文档、追踪器和仪表板,让团队从聊天界面协作编辑;可设置从查看者到编辑者的访问权限,并区分评论者和贡献者角色;支持通过 Claude 自动执行评论内容或样式的更新。
 AWS Machine Learning Blog精选6060
AWS 团队以开源多智能体数据分析方案 Deep Insight 为参考实现,把生产级 AI 智能体的上下文工程拆成四层:多智能体架构隔离上下文、用提示词限制输出、把重内容外置到文件系统、用验证智能体与兜底机制把关。
推荐理由: AWS 团队把上下文工程拆成四层,并给出开源参考实现中的具体代码与 token 节省数据,可直接对照改造自家 Agent。
NVIDIA Technical Blog6565NVIDIA NeMo 可将生产中的智能体失败转化为优先级问题,并生成定制化评估,帮助改进提示词、工具、模型、内存、技能及代码。当为特定领域构建智能体时,通用的基准分数可能无法解释其失败原因,例如智能体可能选择错误工具、遵循错误工作流分支、遗漏相关上下文或使用不必要的高成本模型。
O'Reilly Radar6565AI 是否让软件开发更快?交付速度不是生产力,而是价值产出与成本的比值。由于软件交付物无标准化,代码行数和 PR 数等指标不可靠,且估算不准确,测量交付速度需比较团队自身前后表现。通过随机对照试验,交替进行使用 AI 和未使用 AI 的任务,可减少其他流程改进的干扰,从而更准确地评估 AI 对交付速度的实际影响。
IT之家 · AI3838开源项目 Megler 在 Windows 10 Mobile 15063 及更高版本上运行 Android 应用,无需子系统。
 OpenHands Blog精选7171
OpenHands与Snowflake AI Research合作,让开发者用现有的OpenHands Agent harness直接进行强化学习后训练,无需在训练框架中重建harness。
推荐理由: 原文给出了用现有 Agent harness 直接做 RL 后训练的具体配置方式和代码定位实验,读者可据此判断训练与部署能否共用一套 harness。
 Google Developers Blog5858
TypeSafe 的 Jev 分类器可路由任务至最经济的 Gemini 模型,50 题测试显示其准确率达 96%,优于 93.8% 的 Python 正则启发式方法;设置推理模型 MaxOutputTokens 限制并不能节省成本,反而可能中断复杂任务推理。
 NVIDIA Newsroom3838
AI正改变半导体晶圆厂工作方式,工程师因之加速决策。NVIDIA cuDSS库使COMSOL的多物理场仿真加速10倍,Applied Materials的Ginestra平台仿真加速10倍,ACE+平台加速35倍,Siemens的Calibre光刻软件仿真加速17倍。NVIDIA PhysicsNeMo框架让Lam Research能在毫秒级预测等离子体行为,替代耗时数天的全仿真。
IT之家 · AI6565B站UP主“御坂10297号”成功将华为MateBook E Go 2023刷入iOS 16系统,实现超大屏iPhone体验。该过程由阿里通义Qwen3.8-Flash(Next)本地模型完成,目前尚无驱动,后续将逐步修复并开源。
IT之家 · AI3535德国培训机构 Dein Bildungsurlaub 推出"GTA6"开放世界游戏进修课程,获政府认可可作为带薪教育休假,学员需探索、分析开放世界游戏并运用AI工具,课程费用120欧元,3天6小时,首批班级已报满。
 PyTorch Blog
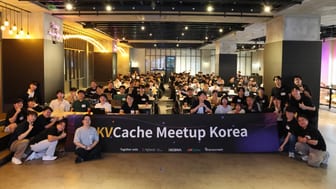
PyTorchKR 与 XCENA 于 2026 年 9 月 30 日联合举办 KVCache Meetup Korea,XCENA、SK hynix、FuriosaAI 和 LMCache 的演讲者分享了 LLM 推理及 KV 缓存优化的成果。
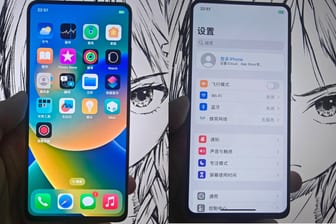
IT之家 · AI6565开发者“你说喜欢是装的”为小米 REDMI K20 Pro 手机刷入苹果 iOS 16.5 测试固件包,支持双系统与数据持久化,需清除安卓数据并替换 TWRP Recovery,可通过正常启动或 Root 权限下的 Magisk 模块切换系统,但开发者强调该方案为测试版本,存在变砖风险。
NVIDIA Technical Blog6565NVIDIA Attribution 可帮助用户定位分布式 AI 工作负载中的初始故障点,通过分析 NCCL 错误、调度器状态变化和下游消息等级联症状,揭示异常发生源头而非仅报告停止位置。该工具适用于诊断 GPU 或网络 fabric 事件引发的跨节点问题,通过可视化分析数千条消息链路追溯问题根源。
NVIDIA Technical Blog6565NVIDIA 推出自动化工作负载恢复功能,通过 NCCL 超时、GPU 节点响应中断或慢节点等故障的快速可靠恢复,保障分布式 AI 训练稳定运行。
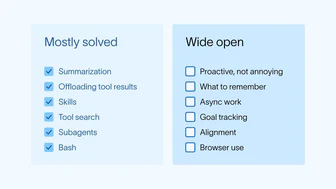
LangChain Blog3838LangChain指出2026年后期智能体上下文工程面临的新挑战,包括如何在不烦人情况下主动通知用户、智能体记忆管理、异步任务处理、目标追踪与对齐、以及浏览器使用等难题。这些挑战涉及智能体在后台运行时如何平衡通知频率、决定记忆内容、协调异步工具与子智能体、分解与迭代目标,以及防止智能体过度优化目标等。
NVIDIA Technical Blog6565NVIDIA AI 集群运行时 (AICR) 解决了在 Kubernetes 上配置和优化 NVIDIA Vera Rubin GPU 硬件的复杂性,确保驱动程序、内核、运行时、网络、操作员和调度器协同工作,并根据硬件和工作负载进行优化,避免因微小不匹配导致工作负载无法运行或性能受限。
O'Reilly Radar6565在《周一早上的特工》节目中,AI分析师被要求定义美式橄榄球战术“Tush Push”,团队通过共享数据字典确定了“四分卫跑动进攻且码数少于等于一码”的定义。
O'Reilly Radar6565Claude Code 提供目标、时间、主动三种循环触发方式及手动循环模式,通过 /goal、/loop、/schedule 等指令实现任务迭代,目标循环需定义成功标准如 90 分以上 Lighthouse 评分。
IT之家 · AI6565用户 Infinite-Zombie5875 改造 2009 款索尼 NW-X1060 Walkman 跑通 ESP-NOW 通信,保留原装 Marvell 无线芯片,实现低侵入式改装。项目通过逆向解析固件收发链路,添加 ESP-NOW 动作帧接口和原生 C 语言 API,演示了跨设备联动的水族画面同步。
Databricks Blog5858Databricks Lakebase 通过其基于复制-on-write 的数据库分支功能,将每个 PR 分支的创建时间缩短至秒级,支持峰值约 100 个并发分支,每分支独立读写,兼容标准 Postgres 并支持大型 JSONB/LOB 列,满足 Snorkel AI 在 CI/CD 流程中快速、安全、低成本地测试生产数据的需求。