Hacker News · AI 热帖精选8080
Unemployment Labs 报告称 DeepSeek、Kimi、MiniMax、蚂蚁六款模型权重带有 Blackwell 硬件指纹
Unemployment Labs通过分析公开模型权重中的随机数初始化布局,发现DeepSeek-V4-Flash、DeepSeek-V4-Pro、Kimi K3。

推荐理由: 通过模型权重中的随机数布局反推训练硬件,为出口管制争议提供了可复现的技术取证路径。
Hacker News · AI 热帖精选8080Unemployment Labs通过分析公开模型权重中的随机数初始化布局,发现DeepSeek-V4-Flash、DeepSeek-V4-Pro、Kimi K3。
推荐理由: 通过模型权重中的随机数布局反推训练硬件,为出口管制争议提供了可复现的技术取证路径。
 MarkTechPost3838
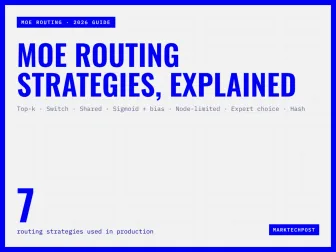
MoE 路由策略决定每个 token 由哪些专家处理,影响模型质量、负载均衡和部署成本。Mixtral 使用 Softmax Top-K 选择 2-8 个专家,DeepSeek-V4-Pro 选择 384 个中的 1-8 个,通过 Sigmoid 门控和辅助损失实现负载均衡,其中 Sigmoid Scoring 配合无损失的偏差平衡是 2026 年前沿开放模型的常用方案。
 The Decoder7575
Vals AI 的 CyberOffense 基准让 AI 智能体在隔离的 Kali Linux 机器上自主攻击模拟企业网络,OpenAI 受限项目中的 GPT-6 Sol Daybreak 完成 80.8% 的目标,开源权重模型 Deepseek V4.1 Flash 1017 达到 72.8%,单次运行成本约 3 美元而非约 22 美元
The Decoder精选7878一项研究让 Claude Opus 4.8、Claude Opus 5、Claude Fable 5、Claude Opus 5.5、GPT-5.6 Sol、GPT-6 Astra。
推荐理由: 这项基准用 15 个未发表的研究问题检验 9 个智能体,并给出 135 份提交中常见的失败模式,可作为评估自主科研能力的参照。
 vLLM Blog精选7272
NVIDIA Research 与 Inferact 的 REINFORCE Zero 提出先对齐 rollout 与训练 kernel,再用不裁剪的 token 级重要性采样修正权重滞后,在 16 张 GPU、12K 次更新下训练步吞吐为同步训练的 2.40 倍。
推荐理由: 论文把异步 RL 的 rollout 与训练差距拆成权重滞后和 kernel 不一致两项,并给出对齐后免裁剪重要性采样的做法。
The Decoder5858斯坦福研究人员测试了50条关于LLM的广泛说法,发现44%已经过期,平均寿命仅为15.7个月,其中推理能力相关说法(如计数、算术、长上下文信息丢失)全部失效,而奉承、欺骗和策略行为相关的说法则持续存在或增强。
 Import AI4242
Realtime-Bench 基准测试评估了 LLM 在 50 个实时交互游戏和网页任务中的表现,GPT-6 Astra 在真实时钟条件下获得 36% 通过率;该测试由德州大学奥斯汀分校等机构开发,用于衡量模型的实时状态感知、适应性推理和时间感知行动选择能力。
 36氪 · AI精选同一件事 · 3 家7373
DeepSeek Harness 团队在官方公众号发表《Super-agent设计探索:迈向更自主的Agent系统》,提出以双层架构、事件驱动、异步多信道交互、存算分离与外部 Watchdog 突破现有 Agent 在多任务与团队协作上的限制。
 量子位精选同一件事 · 3 家7878
DeepSeek 开源 Super-agent 原型,公开面向 Personal Agent 的双层架构思路,上层 Router 负责接收消息与统筹任务,下层 Worker 并行执行具体任务。
推荐理由: DeepSeek 公开 Personal Agent 双层架构与实测数据,可看到多会话协作如何绕开人类注意力瓶颈。
 IT之家 · AI精选同一件事 · 3 家7272
DeepSeek Harness 团队发布《Super-agent 设计探索》一文,提出由 Router 层统一承接人类交互、多个 Worker 会话隔离并发执行的双层架构,并归纳连续、高效、主动、持久四项特征。
 Prime Intellect Blog3838
Prime Mega MoE 通过融合反向传播内核,使 DeepSeek 的 Mega MoE 内核可用于训练,相比默认 PyTorch 实现 MoE 内核速度提升高达 3.11 倍,相比 Prime-RL 基线端到端训练速度提升 1.34 倍。
 Interconnects6565
DeepSeek发布了552B参数的DeepSeek V4.1 Flash 1017模型,支持图像输入且采用MIT许可,性能价格比突出;美国国土安全部限制DeepSeek公司及模型参与联邦民用采购,中国商务部要求前沿AI模型国际共享需获政府预审批。
Prime Intellect BlogDeepSeek 发布 SYNTHETIC-2,包含 20 项复杂强化学习任务及验证推理轨迹,支持从消费级 GPU 到超大规模集群的异构计算,采用 DeepSeek-R1-0528 模型生成数据并标注难度。
Prime Intellect BlogDeepseek-R1 发布 SYNTHETIC-1 开源推理数据集,含 200 万条协作生成的推理轨迹,涵盖数学、编码和科学任务,通过特定任务验证器确认正确性。发布包含正确与错误推理轨迹的原始数据及 90 万条精选 SFT 子集,为 R1 迄今最大 SFT 数据集,并提供偏好调优数据集。发布 7B 参数的 SYNTHETIC-1-SFT-7B 模型,验证数据集通过监督微调能有效提升模型推理能力。
 Dify Blog
DeepSeek R1 在 AIME 数学竞赛中表现优异,准确率从 15.6% 提升至 71.0%,并在 Codeforces 编程竞赛中达到 96.3% 的人类水平,展示出强大的推理能力。
Prime Intellect BlogDeepSeek 发布 SYNTHETIC-1 数据集,包含 140 万个经过验证的数学、编程和科学推理任务及验证器,利用 DeepSeek-R1 生成,旨在提升推理模型训练水平。该数据集允许用户贡献计算资源参与分布式强化学习,并开源 GENESYS 框架以支持合成数据生成与验证。