Hugging Face Daily Papers
Test-Time Baking (TTB) 发布:用于高效渲染解码器仅大视图合成模型的策略
Test-Time Baking (TTB) 策略通过将交叉视图注意力中的全局场景信息烘焙到轻量级 MLP,在保持 Test-Time Training 效率的同时提升了大视图合成模型(LVSMs)新视角解码的保真度,在多个基准测试中实现了高达 23 倍的渲染速度提升且质量与当前最优技术相当。
Hugging Face Daily PapersTest-Time Baking (TTB) 策略通过将交叉视图注意力中的全局场景信息烘焙到轻量级 MLP,在保持 Test-Time Training 效率的同时提升了大视图合成模型(LVSMs)新视角解码的保真度,在多个基准测试中实现了高达 23 倍的渲染速度提升且质量与当前最优技术相当。
Hugging Face Daily PapersOpen Vision Banana (OVB) 开源了 Open Vision Banana 的数据、权重、代码和实现细节,其基于 4B 和 9B 参数的开权重大模型及 2.1M-3.8M 训练对,在 Cityscapes 上超越 Vision Banana 实现 73.9 vs 69.9 mIoU 的零样本性能,并可与最先进的仿射不变深度估计器媲美。
Hugging Face Daily PapersBirdDreams 联合生成视角视频和鸟瞰视频(BEV),使场景布局成为预测未来的部分,通过 BEV 提供车辆位置和运动的俯视图,减少遮挡,而视角视频保留场景细节。在 PhysicalAI-AV 和 nuScenes 上,BirdDreams 比先前的驾驶世界模型更忠实地遵循输入的自身轨迹,并生成更合理的自身运动,无需 HD 地图或车辆状态输入。
 Latent Space
ArtCraft 公司开源了 AI 构建、基于 Rust 的 Photoshop 替代品 PhotoCraft,该软件与 Photoshop 功能相似度达 60%(GitHub 数据为 46% 专业准备度),并计划开源 Adobe Acrobat 的克隆版 PdfCraft。
 OpenRouter Blog
当 RAG 应用在文档中存在正确信息却给出错误答案时,通常是因为检索环节出错。向量搜索虽能找到相关主题的片段,但常因近似匹配而失效,例如在询问 Growth 计划时错误地调用了 Enterprise 计划的桶限制。
 Google Developers Blog
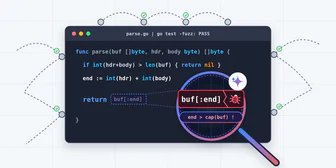
Gemini 4 Argon 将 Go 代码的 panic 路径转化为 Z3 约束规则,配合 Z3 检查触发条件,配合 go test 重放触发字节,在 1 分钟内定位 3 个植入的解析器 Bug 并发现 3 个 skill-lint 潜在 Bug。该流程比 go test -fuzz 更高效,能找到模糊测试遗漏的边界检查错误。
 PyTorch Blog5050
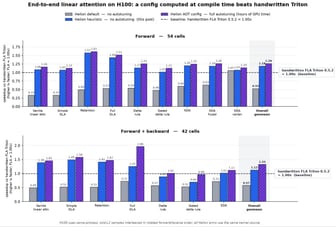
Helion 通过编译时启发式算法分析内核 IR 和数据流,无需慢速自动调优即可选择快速设置,将内核分类为矩阵乘法、归约或逐点操作,并选择块大小、warp 和阶段,实现近乎自动调优的速度。
 AWS Machine Learning Blog5858
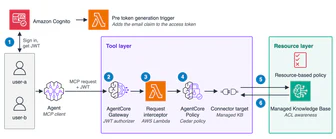
Amazon Bedrock Managed Knowledge Base 通过在 AgentCore Gateway 工具层注入用户上下文并验证 JWT,结合知识库的 ACL 意识功能,实现企业 AI 代理的细粒度访问控制。
 量子位
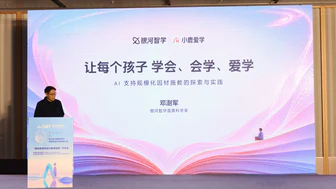
银河智学发布AI教育产品小鹿爱学,采用豆包大模型与自研智能学习引擎双核架构,通过分析学生作答记录实现学情诊断,并开发学情诊断、能力测评、学习难度匹配和任务规划功能。学生端智能体推荐学习任务并说明依据,教师端智能体提炼学生表现供个性化指导参考。产品已服务超500所学校,覆盖24省,通过人机共育模式支持教师调整教学策略。
PyTorch BlogEUROPA联盟在JUPITER超级计算机上使用PyTorch和TorchTitan成功训练了参数量达951.9B的MoE模型,将单GPU的吞吐量从90提升至约1,300 tokens/s,使用了384个NVIDIA GH200 GPU。
Hugging Face Daily Papers6565One Table Benchmark 测试了 46 种模型在 56 个数据集上的表格生成、插补和预测能力,发现这些任务共享条件信息但保真度和目标交互不同,固定模型在效用和保真度间存在权衡,冻结的基础模型在预测和数值插补方面表现突出,表明统一表格模型有潜力提升分类重建和联合采样。
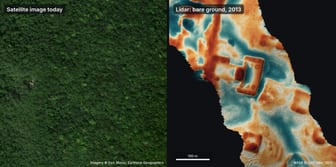
Gemini、ChatGPT、Claude 和 Grok 等智能体通过分析 NASA LiDAR 数据在墨西哥发现未被官方记录的玛雅遗址,耗时不到 72 小时完成从灵感到政府正式回复的全过程。该遗址位于丛林中的山顶,包含广场、金字塔和庭院等结构,智能体通过图像分析识别并提交报告给墨西哥国家人类学与历史研究所 INAH,后者确认该地点尚未注册(后经查证该遗址已由人类学家绘制)。
OpenRouter Blog在 OpenRouter 上运行相同任务,对比 GPT-6.1 Sol 在 60 项合成任务中通过 180/180 次测试,DeepSeek 成本最低通过 157/180 次,但与公开排名相关性低(Spearman 相关系数 0.109)。需检查任务重复次数、答案数量和账单验证。
Hugging Face Daily Papers6565MACaQ 是一种 MXFP4 W4A4 的后训练量化方法,通过在线激活变换和 Hessian 感知细化独立量化每个线性层,在语言和扩散模型中减少成本同时保持准确性。MACaQ 在 Qwen3-32B 上 vLLM 实现仅增加 2.3% 的端到端开销,比 DuQuant++ 和 MR-GPTQ 的困惑度更低,并在 11 倍更短的量化时间内达到 Llama-3-8B 的最佳困惑度。
 Apple Machine Learning Research
状态空间模型(SSMs)在情境学习和精确检索任务上落后于 Transformer,其门控机制导致其先学习记忆解决方案,延迟或阻止正确情境学习解决方案的收敛,但门控机制对改善长序列泛化有益。
 Hugging Face Blog3838
Hugging Face 博客介绍了多向量嵌入模型的 Token Pooling 感知训练方法,通过 HierarchicalTokenPooling 将相似 token 嵌入合并以压缩存储。
 蚂蚁 inclusionAI · Hugging Face 新模型
inclusionAI 发布了 ZoomGain-4B 大语言模型,在 ZoomGainBench 上取得 61.08 分,并在多个细粒度感知和通用感知基准测试中表现优异;模型基于从全局图像细节中挖掘的全局到局部视觉感知差距构建监督,支持英文和中文问答,可通过 Hugging Face 下载。
Hugging Face Daily PapersdNaViT 是一种离散原生分辨率视觉 Transformer,通过分组乘法量化(grouped product quantization)和双分支目标,在视觉理解、生成和编辑任务中匹配或超越特定基线。它在 12 个视觉理解基准、4 个生成基准和一个图像编辑基准上表现优异,证明离散词汇可以作为通用视觉表示
OpenRouter Blog在 OpenRouter 上测试,fp8、fp4 与 fp16 在 240 个评分任务中未发现精度差异,所有六种端点得分在 98.3% 至 99.2% 之间。低精度通常更便宜,但 fp8 比 fp16 更贵的情况有 7 模型,4-bit 比 8-bit 更贵的情况有 7 模型。fp4 端点在 40 个无工作流乘法任务中表现最差,但差距可能由偶然性导致。
 The Decoder
英伟达的GR00T 2 AI模型通过分析人类视频动作,无需远程操控即可让机器人学习新任务,在400,000小时视频数据上训练,实验室测试成功率为10-80%,配合GPT-6 Astra可实现97%的玩具模型组装成功率,但触觉处理和语言模型延迟仍是挑战。
 Meta Engineering
Meta 开源 Triton Low-Level Extensions (TLX) 编译器,通过引入显式 warp-group 和 cluster 级别编排提升 GPU 性能,支持 RecSys 训练/推理及 LLM 预训练,在 NVIDIA 和 AMD GPU 上实现超越独立库的端到端性能提升。
Hugging Face Daily PapersFrontier3DBench 统一评估了 145 项任务中代码智能体在对象、场景和交互式 3D 世界创建上的能力,GPT-6.1-sol 在对象和场景层表现最佳,总得分 66.02/100,但所有配置在对象和场景任务中参考重建得分均低于文本驱动生成。生成世界在局部机制上平均 83.08/100,但在运动清除和状态化工作流上仅分别为 20.82 和 30.26,显示协调活动完成仍是核心瓶颈。
Hugging Face Daily Papers6565Reframe 通过证据感知强化学习和观察门控策略蒸馏,在 14 个图像和视频基准测试中提升具身视觉智能体的工具使用表现,优于 Mix-RL 和基础 MOPD 方法。其两阶段框架 GD-GRPO 和 OG-MOPD 分别通过随机移除原始视觉输入和从修复后的观察中恢复蒸馏,互补地促进模型依赖工具返回的观察结果。
量子位蚂蚁灵波开源触觉预训练模型 LingBot-Touch,将不同触觉传感器信号统一编码为触觉Token,使机器人动作模型成功率提升。LingBot-Touch-Tiny 参数量约 532万,预训练数据 4983小时、约 13.3亿帧,支持多种灵巧手和动作模型,成功率平均提升 15-25%。
e-means 在 25 轮训练内达到低于 Lloyd 算法的测试损失,仅需 1.2 至 3 轮。与最先进的 Flash-KMeans 相比,GPU 端端速度提升 10-45 倍,CPU 端端速度提升 8-15 倍。e-means 通过指数移动平均更新、自动超参数调整、改进初始化和死簇复活策略,实现了速度和损失的双重优化。
Claude Fable 5.2 可以一键从侄子的一组画作中生成完整游戏,包含 175 张图像和 140 个音频片段。生成的动作游戏包含 18 个角色、12 个关卡及剧情,支持 4 人联机,通过 Claude Code 和 Opus 4.8 实现。
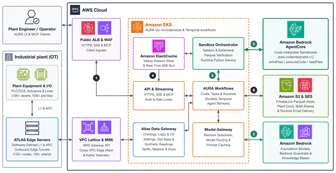
AWS Machine Learning Blog3838CrossnoKaye 通过其 ATLAS 平台和 AURA 智能体,在 Amazon Bedrock AgentCore 上实现工业物理 AI,将生产提效 11-17% 并降低能耗 21%。AURA 利用 AgentCore 的代码解释器能力,在隔离微 VM 中运行 Python 工作负载以验证数值计算,同时通过边缘集群和云优化系统实现闭环控制。
 Epoch AI
Nvidia GB300 相比 H100 在智能体推理任务上的能力提升达 25 倍,远超 8 位 FLOP/s 的 2.5 倍增长。IPI 指数通过比较芯片在多种输出速度要求下能同时处理的请求数量来衡量推理能力,GB300 设为基准值 1,得分为 1 的芯片能同等条件下服务两倍用户。IPI 版本 1 结合四款代表性模型结果,采用 GB300 当作参考基准。
 Berkeley AI Research2222
BAIR团队在2026年11月9日至12日于德克萨斯州奥斯汀举行的机器人学习会议(CoRL)上展示多项研究成果,包括33篇主会论文、4个突破性海报、10场口头报告和7场专题演讲,其中教授Negar Mehr将发表早期职业主题演讲。会议涵盖机器人视觉语言行动模型、具身智能体、细粒度操作对齐、后见之明奖励编辑等议题。
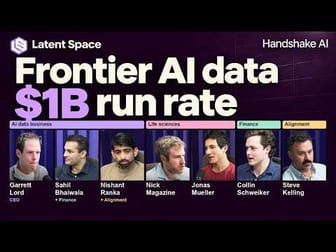
Latent Space5858Frontier Labs 的 AI 训练业务一年内营收达 10 亿美元。Handshake AI 展示了其在金融、生物和编码领域的智能体评估环境,包括银行邮件处理、脑肿瘤组织图像识别和文件访问模拟任务。VIALS 作为生物领域基准,测试模型对科学图像的理解能力。
Hugging Face Daily Papers3434P²-MOPD通过将每个学生模块表示为其自身可学习权重与冻结专家任务向量(专家减去基础模型)的加权求和,联合训练权重和混合系数α,使专家成为参数先验,显著加速多教师策略蒸馏。
Hugging Face Daily Papers6565LongBanana是首个专家设计和验证的长上下文多参考图像合成基准,包含90个精心设计的任务,每个任务约含32张参考图像、20个约束和50个评估项,共4,670个专家指定的原子评估项。
 MarkTechPost3838
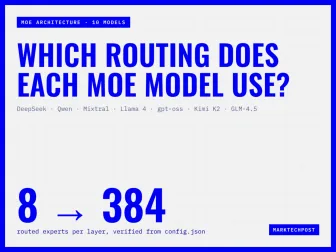
DeepSeek-V4-Pro、Qwen3.6-35B-A3B 等十款开源 MoE 模型在专家计数(8B-384B)、top-k(1-8)、共享专家(7/10 模型保留)、评分函数(Sigmoid/sqrtsoftplus)和负载均衡(Aux loss/bias)等五个方面存在差异。
Hugging Face Daily Papers6565VisSearch-Bench 评估了 16 个多模态模型在 204 项人类编写的视觉搜索任务上的表现,这些任务要求整合视觉上下文与外部信息,结果显示最佳系统仅完全解决了 26.47% 的任务。该基准涵盖集合式视觉搜索、序列式视觉搜索等 7 个主要领域,通过准确率与过程分评估任务完成度与推理步骤的正确性。
 Baseten Labs6565
研究表明,策略内自我蒸馏(OPSD)在特定场景下可能仍有价值,但不应投入更多研究资源。OPSD 通过学生模型自身生成的带上下文提示的输出进行训练,但研究表明这种密集的监督可能引入偏差,尤其对训练好的模型效果更差。
 NVIDIA Newsroom3838
NVIDIA的开源Aerial和Sionna软件使全球开发者采用量增长10倍、下载量超100万次,被8000多个研究机构使用,支持目标语义通信使机器人任务完成时间缩短52.6%、AI接收器在干扰环境下提升60%上行吞吐量、需求预测系统降低45.6% RAN功耗、GPU加速模拟将仿真时间从3小时压缩至10-20分钟。
Hugging Face Blog5858Hugging Face 发布 ToyBlocks 框架,为机器人学习与评估提供受控的模拟环境。该框架支持自动生成任务与训练演示,并包含衡量机器人行为随时间变化的指标,旨在研究模型如何随更多训练数据改进,以及如何结合高级推理与精确物理控制。
 Artificial Analysis Articles6565
VIALS-AA 对 19 模型进行测试,发现 38.3% 的工具调用用于查看图像,47.3% 用于图像准备或测量,而 GPT-6 Astra 和 GPT-6.1 Sol 的图像测量调用率仅为 5-6%,Claude Opus 5.5 和 Claude Sonnet 5.5 则为 25-27%。
Hugging Face Daily Papers6565SLA 模型通过持续预训练和后训练,将预训练的 VLA 策略与冻结的 3D 感知模型进行空间对齐,使用特征依赖门控和概率状态 dropout 提升跨不同机器人数据的空间理解能力,同时保留推理架构。
Hugging Face Daily PapersWeLM-Image 是一个集成多模态理解的统一图像基础模型,支持文本到图像生成、指令引导编辑和多参考合成。