Ai2 Blog4040
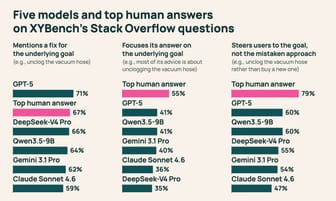
XYBench:解决提问背后问题的基准测试
XYBench 发布,包含 8K+ 问题测试 AI 助手如何应对基于误解的请求;Claude Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B 和 DeepSeek-V4 Pro 在测试中常聚焦原错误方法而非用户实际目标。
Ai2 Blog4040XYBench 发布,包含 8K+ 问题测试 AI 助手如何应对基于误解的请求;Claude Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B 和 DeepSeek-V4 Pro 在测试中常聚焦原错误方法而非用户实际目标。
 Hugging Face Daily Papers6565
Ropedia Xperience 2 包含 1,589 个已发布的度量级 3D 扫描和 4,230 个 74 任务的视点中心记录(131 小时),每个捕获可被重新用于机器人学习,场景转化为物理交互模拟环境,人体运动重定向为全身机器人轨迹,通过虚拟远程操作和自动长时程轨迹生成获取额外机器人行为,该联合捕获被提议为物理 AI 数据收集的黄金标准。
 O'Reilly Radar
自我进化智能体可以通过经验改变未来任务处理方式,其改进主要发生在模型周围的 harness 中,如指令、上下文、工具和软件。评估改进效果需检查智能体是否使用正确信息、采取正确行动并满足用户需求,例如在餐厅规划任务中验证预算和饮食要求。智能体可自主回顾任务、识别重复错误、提出改进方案并测试效果,但需设定可修改的 harness 模块范围,如上下文管理、智能体循环、工具使用等。
Hugging Face Daily PapersEmbodied First Exam 发布,包含 35 套、47 个机器人上的 1,156 个任务,评估编码智能体在物理世界约束下的控制能力,GPT-6 Astra in Codex 在标准设置下 456 个核心任务中成功率 34%。
Hugging Face Daily PapersWorld In-Context Learning (WICL) 方法通过冻结模型,在模拟器中演练任务并将反馈写入上下文而非权重,使机器人能从单一演示中学习操作技能。RoboScript 实现了 WICL,在 RoboTwin 2.0 的 50 项任务上,单次演示无梯度更新即可达到 83.4% 成功率,超越最强训练策略 20 余点,并支持跨视觉分布泛化、通过反思改进、基础模型扩展及跨平台记忆迁移。
Hugging Face Daily PapersLingBot-Touch 是一个触觉基础模型,学习跨不同触觉传感器(压阻式、磁性、视觉触觉)的统一、可扩展表示,产出可即插即用的触觉 token,持续增强扩散策略和视觉语言行动(VLA)模型(如 π_{0.5} 和 LingBot-VLA)的灵巧操作能力。实验表明,该触觉表示在模拟和真实机器人部署中显著提升复杂操作任务表现,同时保持强计算效率。
Hugging Face Daily PapersWorldFoundry 提供开源基础设施,用于可复现地推理和评估跨视频、3D/4D、具身行动和交互系统的生成世界模型,包含可追溯证据和基准,收录 270 个模型条目、74 个基准和 62 个注册指标。
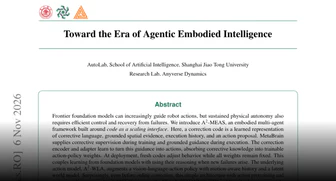
Hugging Face Daily PapersA2-MEAS 框架通过学习校正码和具身视觉语言行动模型提升机器人控制与故障恢复,在 50 任务 BEHAVIOR 2026 公开子集上达到 0.5755 Q-score 并实现 45.40% 任务成功率,12 项真实机器人任务平均成功率 57.92%。该框架采用动作预训练和任务专业化,训练吞吐量达 427.1 样本/秒,系统将开源模型、训练脚本及基础设施。
 NVIDIA Technical Blog6565
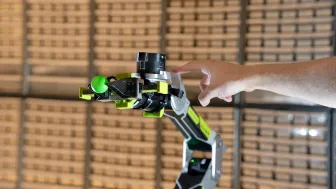
NVIDIA Holoscan 5 通过持续计算逆动力学实现重力补偿,使机器人手臂在操作时仅需提供支撑重量的扭矩。该技术支持通过示教学习、物体操作或人机协作的机器人应用,依赖重力补偿回路构建。
Hugging Face Daily Papers2424物理AI应通过终身认知共生体增强人类智能,该共生体通过感知、情境保留和主动协助来弥补认知差距,需要嵌入式治理。大型基础模型和个人智能体已能独立完成多步任务,但人类仍会遗忘知识、忽略信息、缺乏历史参考,因为能提供帮助的机器处于情境之外。
 IT之家 · AI6767
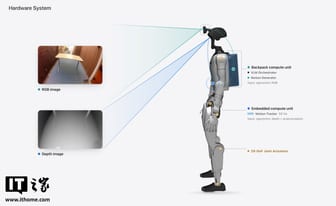
苹果研究团队披露人形机器人自主控制系统 HALO,在 6 个真实环境中 360 次单项任务测试平均成功率 91%;系统调用千问模型在宇树 G1 上验证,长序列复合任务单一场景 10 次测试 3 种组合平均成功率 70%,最复杂任务成功率 50%。
Hugging Face Daily Papers5252Open-HumanScale 是首个支持具身基础模型 egocentric pretraining 扩展至 50,000 小时的开源方案,其核心数据集 Open-HumanScale-50K 包含 50,000 小时密集标注的人手动作和自然语言 egocentric 视频数据。
O'Reilly RadarCommon Fabric 的 CEO Alex Komoroske 在与 Tim O’Reilly 的对话中阐述了其共鸣计算宣言的核心理念,该宣言提出五项原则:私有、专注、多元、适应和利他,旨在创造能滋养而非消耗用户的科技体验。
Hugging Face Daily Papers3838REA 将深思熟虑和反应性策略统一在单一运行时中,通过异步协调,在模拟和真实机器人任务中实现了高成功率并减少了控制开销。在 60 个 LIBERO-Pro 任务上的 3,000 个测试片段中,REA 达到 95.9% 的成功率,并击败了其自身策略库中的最佳单智能体基线(94.7%),同时将控制步骤减少 25%,控制时间减少 17%。
Hugging Face Daily Papers3434OSWAM 通过使用结构化想象标记初始化扩散过程,并将未来条件特权信息蒸馏到单个去噪步骤中,实现了自动驾驶和具身控制中的实时高质量行动生成。该模型仅需一步扩散即可生成高质量行动,比需要数十步的去噪过程直接策略世界行动模型(WAM)快约 3 倍,在 NVIDIA RTX 5090 GPU 上实现低至 40ms 的延迟,支持实时编译推理。
Hugging Face Daily Papers5858Wizard解耦角色动画、场景操控和游戏逻辑与视觉生成,通过结构化视觉代理让智能体控制关节骨骼和场景几何,实现24 FPS的实时交互,零样本泛化到未见场景、角色和动作。团队构建了50.3小时对齐的代理-视频对,包含750场景和178个角色,支持角色自适应遮罩、因果适应和少步蒸馏技术。
 Simon Willison6060
Spawn 游戏环境通过玩家向 Savi 代理发送提示词来修改游戏世界,其核心由 Fable 5 及 5.1 模型驱动,每月 AI token 花费超 300 万美元。
Hugging Face Daily Papers6565Sensorimotor Alignment (S²) 指标发现具身智能体的视觉与运动表征对齐程度与其任务成功率正相关,验证了柏拉图表征假说在机器人领域的适用性。在模拟与真实机器人测试中,高 S² 的模型(如 Vision-Language-Action 和 World Action Models)表现更优,且能解释 VLA 模型忽略指令而依赖视觉特征的现象,可作为低成本离线代理指标。
 量子位
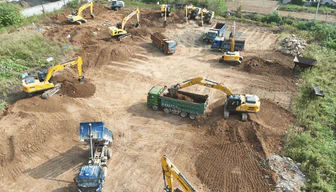
威卡移动控制发布具身智能赋能工程机械高质量数据集,包含3600万帧、12类典型作业场景,已上线Hugging Face。该数据集通过“视觉、激光、位姿、力馈、手柄输入”五大维度同步对齐采集,覆盖多品牌挖掘机机型,旨在解决具身智能行业数据稀缺痛点,推动工程机械智能化与少人化。
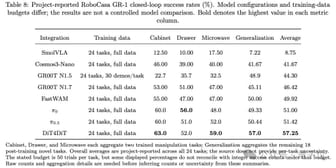
量子位逐际动力发布 FluxVLA Engine V2 技术报告,通过统一配置、模块解耦和系统优化,实现模型训练、评测与部署全链路复用,支持14种主流策略接入,推理路径频率提升2.31–9.64倍,在ALOHA、双臂Franka等6款真机验证闭环执行,在线强化学习使SmolVLA成功率提升10.0–15.4个百分点。
Hugging Face Daily PapersPDRVLA通过集成轻量级物理动态模块改进机器人行动生成,该模块在物理世界模型监督下预测未来视觉特征,避免在线视频生成带来的延迟。PDRVLA在四个模拟基准上取得99.3%(LIBERO)、89.9%(LIBERO-Plus)、93.6%(RoboTwin~2.0)和81.5%(SimplerEnv)的成功率。
Hugging Face Daily Papers4747RynnUnify是一个16B参数的统一具身模型,整合了视觉规划、物理推理和机器人控制,在长时程具身任务上达到最先进水平。它通过交替的视频-语言推理实现强大的具身理解与长时程视觉规划,并开发了智能体扩展和世界动作扩展,分别通过强化学习选择性地使用视频预测推理未观察状态和交互结果,以及将理解和预测能力转化为机器人控制。
Hugging Face Daily PapersFRED框架通过自蒸馏和时序条件提升世界行动模型的未来视频表示能力,在真实世界操作场景中持续优于竞争模型,在长时程和域外任务上实现零样本泛化的大幅增益,将人类视频技能迁移成功率从19.4%提升至50.0%。
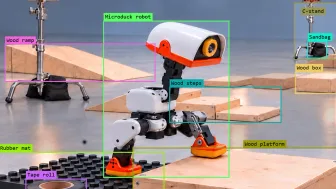
NVIDIA Technical Blog5555NVIDIA 开发 AI 智能体让 Microduck 在模拟环境中学会行走。模型通过感知环境、维持平衡和调整动作来导航障碍路线。该技术结合了资产创建、物理模拟和训练评估等阶段。
IT之家 · AI米哈游联合清华北大等高校发布开源 GameScaling 游戏模型,覆盖 0.8B 至 27B 参数规模。该系列 8 个模型基于 Qwen3.5 视觉语言模型继续预训练,训练数据涉及《我的世界》《毁灭战士》等游戏。模型接收游戏画面及操作记录生成后续指令,支持实时游戏交互,4 种参数规模各有 S1、S3 两个版本,采用 Apache 2.0 许可证。
Hugging Face Daily Papers6565研究通过在数据规模、多样性和模型大小三个维度上进行持续预训练(CPT),提升了虚拟世界中的具身智能体学习能力,但在远距离世界泛化上存在局限。研究测试了涵盖 0.8B 至 27B 参数、50 至 1600 小时数据预算、五种数据混合的 120 种配置,发现数据量增加提升内部表现,多样性改善相关世界迁移,模型规模提升数据效率但远距离泛化更差。
量子位6565生数科技Motubrain团队开启2.0训练全流程直播,持续半个月展示具身模型训练过程。直播涵盖预训练、后训练、Agent任务执行和RSI探索四个环节,向公众开放模型从训练到能力迭代的过程。此举旨在提升Physical AI研发透明度,分享规模化训练、跨任务泛化等研究经验。
 AI as Normal Technology7575
研究人员提出了33项AI智能体评估的兴起趋势,指出评估智能体比评估模型更复杂,需要关注整个行为轨迹而非仅结果,并强调评估范围需扩展至实验室、特定用例和现实世界,同时呼吁更多跨学科评估者参与并确保其独立性。
 Meta Engineering
Meta 使用 AI 智能体参与工程流程构建 Forum 应用,将 AI 视为工程过程的参与者而非辅助工具。该实验以生产就绪成果而非代码量衡量成功,通过 Human-On-The-Loop 模式让 AI 自主执行计划、实施、测试和验证,工程师负责设定目标、监督和验收。
 Baseten Blog
MetaInfer 技能工具箱通过仅用知识构建自定义推理引擎,在单流解码速度上使 Qwen-3.6-35B-A3B 模型比 vLLM 0.25.1 快 90%,TTFT 提升 2.33 倍。该框架无需模型微调或专用适配器,通过定义约束和优化目标,使 LLM 可针对特定部署实现高度优化的推理引擎。
 Anthropic Research精选7171
Anthropic 发布机器人暴露指数研究,用 Claude 评估 O*NET 约 1.9 万个任务,发现现有机器人可完成美国 74% 的体力任务、占全部工作时间的 34%,但多数限于受控环境。
推荐理由: Anthropic 用 Claude 给 O*NET 任务逐条评级,量化机器人当前能覆盖多少工作,并给出成本与监管的约束条件。
 Microsoft Research
将物理 AI 推理卸载到边缘或云 GPU 可显著提升机器人任务成功率、支持更大模型并延长电池寿命。在移动操作任务中,卸载推理使机器人响应速度和准确性提升,电池续航增加,成本降低。Microsoft Research 开发了基于 Kubernetes 的工具集,支持在机器人、边缘设备和云端进行分布式推理部署。
 Prime Intellect Blog
True Agents Model the World 预训练方法使 LLM 能以高精度模拟环境。在 forth-lang 环境中,RLHF 结合 SFT 的方法使模型工具调用更智能,alpha=0.05 时 lookup_doc 使用率显著提升但早期即下降,alpha=1.0 时奖励提升更稳定。
Prime Intellect BlogDeepSeek 发布 SYNTHETIC-2,包含 20 项复杂强化学习任务及验证推理轨迹,支持从消费级 GPU 到超大规模集群的异构计算,采用 DeepSeek-R1-0528 模型生成数据并标注难度。