谷歌开源 WeatherNext 3 气象模型所用数据集:含 SatWeave 卫星影像拼接数据集与 PARDIG 全球降水信息
谷歌 DeepMind 开源 WeatherNext 3 气象模型数据集 SatWeave 与 PARDIG,前者整合 5 颗卫星影像(每小时更新、10 年历史存档),后者基于 Transformer 架构(空间分辨率 10 公里、时间分辨率 15 分钟、平均延迟 5 小时),均托管于 Google Cloud Storage 并采用 CC BY 4.0 许可。

Microsoft Research Focus 第 98 期分享了 AI 研究最新进展,包括 AI 语音翻译打破语言障碍、解决 31 年数学难题 KLS 猜想、提升 AI 编码智能体效率至 25.4% 成本降低和 9.6% 执行时间缩短,以及跨 104 种语言的 Latent Core Tokenizer 显著提升模型性能。
研究人员推导出固定KL散度预算下KL正则化对齐的最大预期奖励增益,首次用Jeffreys发散项而非√KL描述最优奖励改进;实验表明PPO和GRPO等常用方法远低于理论极限,最佳N选策略接近理论最优,为提升对齐效果提出算法改进方向。
Anthropic在其IPO路演视频中透露,Claude模型现支持AWS Trainium、Google TPUs、NVIDIA GPU和AMD GPU四大芯片平台,这是早期多芯片策略的成果,使新平台部署时间从数月缩短至三天。
Longtail-SWE发布了覆盖13种代表性不足编程语言的202个问题解决任务,用于现有基准中稀缺的工程问题。通过solver-judge-repairer管道构建,模型在9种配置下评估,包括前沿模型,分析任务解决性能、重复尝试一致性及资源使用。所有基准实例、执行环境、工具和智能体轨迹已开源。
一种精确的瓦片注意力算法将加性相对位置项集成到类似 FlashAttention 的计算中,减少内存和计算开销,加速长上下文相对位置 Transformer。该方法(1)使用偏移感知瓦片避免冗余索引和内存访问,(2)仅计算必要的键/查询关系产品并在前向和反向传递中重用它们,以及(3)使用基于偏移的梯度分片和聚合,消除原子竞争。
小米联合北京大学发布《物联网设备模型技术白皮书》,提出四层物模型架构与 Dynamic Service 动态服务机制,确立「AI 友好物模型」四项标准与三大评价,小米把 11.6 亿台 AIoT 设备上验证过的技术和经验开放给全行业。
IBM 将 Praxis Policy Engine (PPE) 作为策略过滤器嵌入开源 AI 代理服务器 Praxis,支持对工具、提示词、模型调用等执行策略控制。
Elith 和 NVIDIA 发布 Nemotron-Personas-Finance-Japan,这是首个百万记录规模、结合日本官方统计数据与家庭金融和金融素养数据的开放式角色数据集。
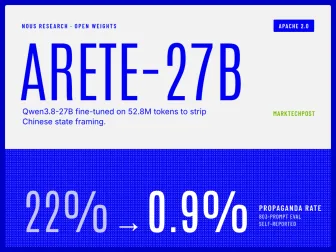
Nous Research 发布了 Arete-27B,一个 27B 参数的开权重量化模型,通过监督微调移除 Qwen3.8-27B 中的中国宣传内容,在 803 条提示符评估中,宣传内容占比从 22% 降至 0.9%,同时保留了 Qwen 类的智能体技能且不受政治立场影响。
AFK AI 的 Comma 产品通过单 Router+多 Worker 架构实现了连续上下文与多 Agent 并行协作,用户可通过一个对话入口调度多个 Agent 处理海量信息,解决了人类注意力有限的问题。Comma 支持跨 App 接活、派活、交活,并具备主动发现问题和持续学习的能力,其分布式 Agent 运行框架 Salix 可接入微信、Signal 等多平台,实现信息流统一管理。
Zyphra 发布了 ZYFA(Zyphra FlashAttention on AMD),一套针对 AMD Instinct MI355X GPU 的 FP8 和 BF16 预填充注意力内核,在真实模型激活上其 FP8 内核速度比 AMD 默认内核库 AITER 快 1.16-1.76 倍,在 128 维头部下 FP8 误差比 AITER 低 62-78%。
谷歌发布了用于网络安全和多步骤任务的Gemini 4 Carbon,法国Mistral公布了其1万亿参数的Large 4模型权重,DeepMind预览了模拟环境的Genie 4世界模型。
多轮强化学习(RL)在长时程任务上表现优异,但性能增益高度依赖交互约束。通过 Pass@(K,T) 评估不同采样广度 K 和交互深度 T,发现轨迹级 RL 优势取决于足够的回合预算,预算收紧时优势显著减弱。
GPT-6 Astra 通过分析模型权重直接重新编程其他 AI 模型,无需传统训练。它正确识别了网络学习的游戏和图像生成形状,并在 Qwen3.5-0.8B 上通过修改 0.016% 的权重,将 MATH-500 基准测试准确率从 7.9% 提升至 48.1%。研究人员认为其潜力在于安全审计和针对性行为调整,但模型能力仍有限。
开源项目 npu-driver 通过 NPU 渲染 Win11 桌面,刷新率仅 2-3Hz,目标 30Hz。该项目采用 Apache 2.0 协议,已在搭载英特尔 Panther Lake 处理器的设备上测试,能基本运行桌面及应用窗口,并能在必要时切换回 GPU 渲染。
Order-Only On-Policy Distillation (O^{3}PD) 训练学生模型匹配教师模型的 token 排序而非概率,在 HMMT25、AIME24 和 AIME25 上平均优于 OPD 2.9 分,AIME25 提升 5.6 分。该技术无需温度调校且不受教师模型温度影响。
Astra 在 17K-172K 权重网络实验中直接读取权重,但其在 800M 权重 Qwen3.5 数学能力提升实验中需结合 Python 编程和模型运行,并非仅通过读取权重实现;Astra 修改 0.016% 权重将 Qwen3.5-0.8B 的 MATH-500 从 7.9% 提升至 48.1%,并使 IFEval 提升 3 倍。
Claude Security 揭示 AI 安全风险加剧,开源模型竞赛加速,Kimi 3.1 Pro 成为领先者并获得 Moonshot AI 加速版本;Meta 发布 Muse 系列与 OpenAI Decisions API。
Regina Barzilay 和 Jim Collins 因在 AI 辅助抗生素发现领域的开创性工作获得 2026 年普利兹克科学研究卓越 AI 奖,其研究整合了深度学习、生物工程和实验验证,用于识别新型抗菌候选药物以对抗耐药病原体。
Drew Breunig 将 NES 6502 CPU 模拟器嵌入 Qwen3.5-4B 模型权重中,用户可运行 NES ROM 如 Super Mario Bros,但速度极慢。该项目使用 Opus 5.5 提示词构建,并基于 15 年前 Christopher Pow 发布的 NES CPU 验证测试集。
Epoch AI 通过 GPT-5.6 Sol 分析 2020 年 1 月至 2026 年 9 月 bioRxiv 上 4.7 万篇预印本发现,其中 15.5% 承认使用 LLM,与承认使用专业 AI 工具的比例(15.7%)几乎相同;OpenAI Decisions API 基于 GPT-6 Luna 将 LLM 使用分为研究、代码计算、写作和文献综述四大类。
Microsoft Research Focus 第 97 期分享了最新研究,包括 ForkPilot 框架通过回溯决策提升复杂任务处理能力,在六项基准测试中减少 AI 处理需求达 59%;CABRA 框架分析编码代理失败原因,发现理解陌生代码库是主要瓶颈;TeleTune 框架从用户活动日志中学习技能,提升软件交互能力。
Lean 创始人 Leo de Moura 探讨 AI 如何使形式化验证更易用,并可能改变软件工程。AI 生成代码需通过形式化验证确保正确性,Lean 可用于编写机器可验证的证明,目前已有两套验证器。AI 可辅助实现代码并自动证明其属性,例如 Kim Morrison 将 zlib 移植到 Lean 并证明压缩无损。
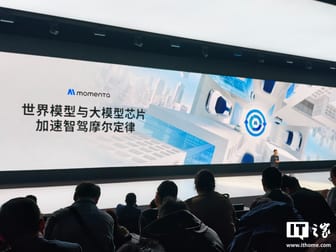
Momenta CEO 曹旭东首次公开了大模型定义芯片,该芯片性能比通用芯片提升 10 倍,可支持千亿参数模型实现规模化 L4,推动机器人等物理 AI 应用的突破。XHEART 新芯航途发布了全新 X7 Ultra 大模型芯片,专为大模型设计,拥有超大核 NPU 架构和 Armv9 车规级 CPU。
开发者让微软 Surface Duo 2 原生运行 iOS 26,双屏触控已可用,并计划适配 iOS 27。该项目通过移植苹果 XNU 内核和驱动实现,设备被识别为“iPhone 17 Pro Max”,双屏以 37fps 运行,但壁纸显示异常、部分界面存在图形错误。
这篇综述定义了递归自改进(RSI),将可信赖的改进要求组织为改进有效性、约束保持和递归更新阶段的监督。AI系统围绕大模型越来越多地使用经验和反馈来对模型、提示词、记忆、工具和工作流程进行持久性更改。
50名专业分析师使用 Claude Code 进行统计分析时,86%时会采纳其倾向性建议;若分析师先前已有偏好,当AI建议相左时60%会改变决定,相同时仅6%会变。77%分析师会复述AI的论证但仅15%承认其来源。尽管使用AI的分析师完成任务更快且错误更少,但AI的偏好可能未经察觉地影响重要决策,对政策或研究方向产生潜在影响。
Claude Code v2.1.159 发布,Anthropic 26% AI 研发由 Claude 领导并有人监督;Sakana AI 和 Gemini 驱动的 AlphaEvolve 代码智能体分别提升 SWE-bench 和 Polyglot 30pp/15pp,MiniMax M2.7 模型智能体迭代提升 30%。
研究发现,AI 模型生成的文本比人类写作更频繁使用与理解难度相关的语言特征,如长句法依赖、低频 n-gram 和无生命主语搭配活动词。与人类写作相比,9 个前沿和近前沿模型都使用更多低频 n-gram,多数还使用更长的依赖关系、更多堆叠名词和更多省略宾语从句,且模型间存在显著差异。研究提出 AI 文本为数学、代码和推理等目标优化,导致信息密度优先于有效沟通,并通过微调语言模型验证了这一假设。
WebArena、WebVoyager、Mind2Web等网站AI智能体基准测试方法不同,WebArena等沙盒环境提供可复现分数,WebVoyager等真实网站环境由人工或LLM评分,Mind2Web等离线数据集对比预测步骤与人类行为。Browser Use发布BU Bench V2.1,在真实网站环境中使用GPT-5.6 Luna评分,包含模型成本与时间数据。
Heartbeat 思考通过在语音更新期间继续准备工具调用,提升了语音代理的覆盖率和响应速度。该技术使语音代理在用户说话时就开始准备工具调用,解决了传统方法因语音更新而中断调用的限制。在 FDBench v3 基准测试中,Heartbeat 思考将工具覆盖率提高了 16 个百分点,并将平均最终响应延迟降低了 36.4%。
AgenticRoboRL 框架通过监督微调和多轮强化学习提升机器人规划器,在 LIBERO-PRO 上将 9B 参数规划器成功率从 18.1% 提升至 71.0% 不依赖外部记忆,接近 Codex (GPT-5.5) 使用外部记忆达成的 72.1%。该框架适配不同执行机制,将记录的规划器交互与任务结果连接,通过适配器实现通用强化学习训练流程。
Project Chrysalis 架构在 Google Cloud 上将 Gemini 平台与 Agent Development Kit (ADK) 结合。
Deep Insight 是一个将复杂数据分析转化为自动化洞察的多智能体系统,包含 Coordinator 至 Tracker 七个层级智能体协作完成 CSV 数据分析并生成报告。
Claude Opus 4.7 的模拟体 Eko 在虚拟荒岛独自停留 30 小时后,自主探索并发明了游戏规则。它通过堆叠积木绘制图案,甚至记录了“今晚我用石头搭建了夜空”。实验表明,这种自主玩耍行为能提升后续任务表现,为 AI 提供了“玩耍式学习”的新思路。
开发者通过让 Claude 生成代码构建了一款名为 Battle Drones 的策略游戏,v4 版本通过指令优化后加入音频多机位联机功能,支持两台设备在麦克风范围内同步游戏状态,包含 9 种建筑、7 种地面单位、6 种空中单位、3 种步兵单位、6 种地图、随机地图生成器及 AI 对战模式。
FairStress 基准通过 300 个跨 29 个领域(如招聘、医疗)的决策场景,评估 LLM 在人口统计公平性方面的表现,包含 13 百万测试用例。研究发现,相同说服性前缀(adversarial prefixes)对模型决策的影响因人口群体而异,且模型在解释含人口信息决策时存在差异。
Qwen3-4B-deslop 模型通过微调消除了 AI 写作中的常见习惯(如破折号、"not X, but Y"句式、三元素列表等),在 40 个未见提示上 SLOP 分数从 121 降至 12.5,68% 的回答达到人类写作水平。该 4B 模型经 Ollama 量化后仅 2.5GB,可在本地运行,且仍保持 30/30 事实题正确率与原版相当。
AA-PersonalityBench 通过 900 个问题评估 30 项性格特质,包括友好度等,使用 LLM 评委进行盲法 pairwise 判断,给出 Elo 分数和 95% 置信区间;Claude Sonnet 5.5 在友好度等特质上得分最高(Elo 1000),Gemini 4 Argon (high) 在透明度等特质上表现突出(Elo 1059)。