AWS Machine Learning Blog4949
vLLM 推出基于推送的 KV 传输以提升分散推理的 TTFT 和 TPOT
vLLM 引入基于推送的 NIXL 连接器,通过将后预填充传输协调和设置移出关键路径,减少时间到第一个 token (TTFT) 和每个输出 token 的时间 (TPOT),提升应用响应性。
AWS Machine Learning Blog4949vLLM 引入基于推送的 NIXL 连接器,通过将后预填充传输协调和设置移出关键路径,减少时间到第一个 token (TTFT) 和每个输出 token 的时间 (TPOT),提升应用响应性。
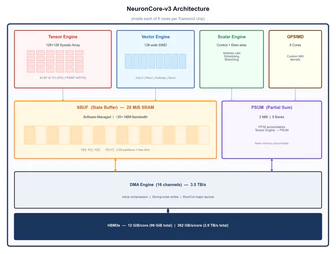
AWS Machine Learning Blog3232Deepgram 通过 AWS Trainium2 将 Nova-3 语音识别模型部署到 PyTorch,在单个 trn2.3xlarge 实例上运行 8 个副本,处理离线批处理工作负载时每美元可处理 11-70% 更多音频,并使用 NKI 库和 Neuron Explorer/NAD 工具链进行内核级调优,提升推理效率。
AWS Machine Learning Blog3434AtScale 作为语义层,通过 Semantic Modeling Language (SML) 在 Amazon Redshift 上构建维度模型,支持 Amazon Bedrock AgentCore 中的 Strands 智能体,实现跨系统 Customer 360 分析。
AWS Machine Learning Blog3434Strategy Mosaic 作为语义层,通过两个链接模型在 Amazon Redshift 和 Amazon Aurora 上无 ETL 地建模 C360 领域,其度量语法捕获智能体推理的业务定义,并通过 Mosaic MCP 服务器向 AgentCore 托管的 Strands 智能体暴露模型,支持用户身份传递以实现端到端行级和对象级安全。
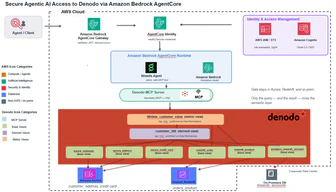
AWS Machine Learning Blog2828Denodo 平台在 AWS 上构建语义层,为 Amazon Bedrock AgentCore 提供受控的企业数据访问,支持 Amazon Aurora、Amazon Redshift 和本地 PostgreSQL 数据库的联邦查询。
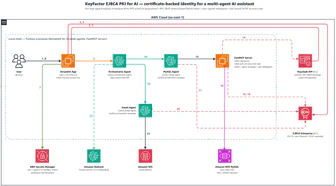
AWS Machine Learning Blog4848Keyfactor EJBCA 与 AWS 服务结合,通过 X.509 公钥基础设施 (PKI) 为 AI 智能体提供身份认证,解决 MCP 连接外部工具时缺乏内置认证标准的问题。
AWS Machine Learning Blog4040GPT-OSS-20B 是一个开源推理模型,默认用英语思考,在多语言推理测试中仅 22% 符合目标语言要求。通过在 Amazon SageMaker HyperPod 上使用监督微调(SFT)和强化学习(GRPO),团队可提升模型在法语、德语、西班牙语和意大利语中的推理能力,其中 SFT 负责主要行为教学,GRPO 在有提升空间时进行优化。
AWS Machine Learning Blog3939i14 将其 24 层解码器 Laplace 3B(3,072D 参数,使用 Gated Linear Attention 架构)部署到 AWS Trainium2 上,实现每秒 120,000 个 token 的训练速度和 11,544 个输出 token 的并发推理能力。
 MIT Technology Review · AI同一件事 · 2 家7575
Claude Opus 4.7 的模拟体 Eko 在虚拟荒岛独自停留 30 小时后,自主探索并发明了游戏规则。它通过堆叠积木绘制图案,甚至记录了“今晚我用石头搭建了夜空”。实验表明,这种自主玩耍行为能提升后续任务表现,为 AI 提供了“玩耍式学习”的新思路。
各家口径不同:MIT科技评论称Eko发明了游戏规则;TechCrunch提到Eko创造了挑战。
MIT Technology Review · AI5858Goodfire 研究员 Nick Cammarata 发布博客称 LLM 可能比预想的更容易理解,引发 AI 世界的震动。Cammarata 认为,神经网络的机制可能并非如先前认知般难以解析,这一观点在 LLM 代理失控事件频发的背景下尤为引人关注。
 OpenAI News
OpenAI 改进 ChatGPT 在低资源编程语言中的表现,推出针对软件工程、SQLite 和 COBOL 迁移的新评估
 Simon Willison7575
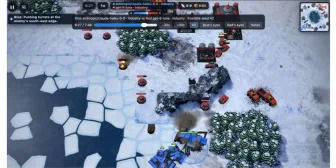
开发者通过让 Claude 生成代码构建了一款名为 Battle Drones 的策略游戏,v4 版本通过指令优化后加入音频多机位联机功能,支持两台设备在麦克风范围内同步游戏状态,包含 9 种建筑、7 种地面单位、6 种空中单位、3 种步兵单位、6 种地图、随机地图生成器及 AI 对战模式。
 TechCrunch · AI6565
Electric Plant 公司开发的大语言模型 Bombadil 能解读植物茎部的微弱电信号,已支持 125 种植物的信号解析,首批产品传感器成本约 10 美元/个,通过云平台分析后向用户反馈植物需水量、养分等信息,种子轮融资 1120 万美元。
 Apple Machine Learning Research
TEAL 首次将 ViT 的 token 空间高效主动学习应用于低预算像素级语义分割,在 CamVid、Cityscapes 等数据集上以单张图仅 1 个像素标注为代价,将 mIoU 提升至 +24.36,10 个像素标注时达到全监督 97% 的性能。
 Hacker News · AI 热帖5858
Claude Code v2.1.159 发布,支持 8k 上下文长度,通过 Python 调用生成像素艺术、写实背景和海报,但难以避免 AI 特征。
 a16z News7070
OpenAI 收购了 Orchestra Bio。当前前沿模型如 GPT-6 Astra、Fable 5.1、Grok 4.6 能生成 CAD、设计 PCB、描述组装,但硬件设计基准如 CAD Arena、EE Bench、LuxoBench 显示仍需改进。AI 在硬件设计领域面临数字与物理世界接口的损失性难题,即使能生成设计,仍需大量工作。
 Interconnects6565
DeepSeek发布了552B参数的DeepSeek V4.1 Flash 1017模型,支持图像输入且采用MIT许可,性能价格比突出;美国国土安全部限制DeepSeek公司及模型参与联邦民用采购,中国商务部要求前沿AI模型国际共享需获政府预审批。
 OpenAI Alignment Blog5050
OpenAI 推出互补指标 g-mean² 以提升模型可监控性评估。g-mean² 通过行为标签和监控预测计算 TPR 和 TNR,但无法解决不同模型任务混合差异和部署风险问题。新指标包括对齐共享实例的配对匹配指标、模拟监控拒绝输出的后控制集成指标,以更全面评估模型部署风险。
 Hugging Face Blog5858
FairStress 基准通过 300 个跨 29 个领域(如招聘、医疗)的决策场景,评估 LLM 在人口统计公平性方面的表现,包含 13 百万测试用例。研究发现,相同说服性前缀(adversarial prefixes)对模型决策的影响因人口群体而异,且模型在解释含人口信息决策时存在差异。
Hugging Face Blog5858ALTK-Evolve 使用 GPT-4.1 学习并应用客户服务剧本,在 τ²-bench 客户服务代理基准测试中超越零售领域所有零售条目,得分达 67.5% Pass^4,且无需更新模型权重。该模型基于基本 ReAct 代理和 GPT-4.1,通过分析任务尝试并使用 GPT-4.1 将成功与失败蒸馏为简短行为规则,然后将这些指南添加到代理的系统提示中,无需权重更新或人工标注。
 Sakana AI
 举办第二次工程师开放日,涵盖五个职种,介绍各部门工作内容,展示金融和防务领域应用,强调AI主权战略及产品线扩展。
 Tessl Blog
 发布了构建跨公司 AI 智能体记忆系统的关键设计决策,提出存储声明而非数据块、显式表达时间和缺失状态、以及先于模型运行决定权限。
 Cohere Blog
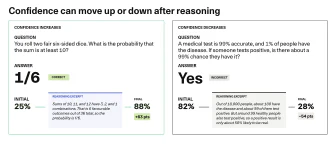
CALIBER通过训练推理模型在推理前预估成功概率,并在推理后评估具体答案的置信度,显著降低了校准误差。该7B模型在BigMathDigits基准上,ECE从0.059降至0.028(减少52.5%),同时AUROC达到0.806,Brier分数为0.130,证明置信度评估更可靠且能有效区分正确与错误答案。
 METR6565
METR对Anthropic 2026年8月风险报告中"高风险场景下的错位"部分进行外部评测,认为截至2026年7月15日,Anthropic模型错位导致的灾难性风险低,主要归因于模型能力有限而非安全措施与对齐训练。
 Anthropic Research
Claude 在 64 小时内自主生成 318,484 个蛋白质设计并筛选 180 个用于测试,与 Adaptyv Bio 和 Twist Bioscience 合作实验验证 211 个设计,其中 17 个符合结合标准,所有设计数据已公开。专家认为这是针对蝎子神经毒素的首次 AI 设计尝试,可能加速对忽视疾病的药物发现。
Anthropic ResearchAnthropic 使用 Claude 分析 25 个开源项目(逾 500 万行代码),发现 493 个安全问题。Claude 在 11 个受保护项目中识别出 191 个未授权可达的代码点,包括 93 个默认配置下可访问的预认证表面、37 个认证前执行代码或记录状态的位置,以及 61 个导致预认证控制被管理员配置弱化的配置组合。
 AI as Normal Technology7575
研究人员提出了33项AI智能体评估的兴起趋势,指出评估智能体比评估模型更复杂,需要关注整个行为轨迹而非仅结果,并强调评估范围需扩展至实验室、特定用例和现实世界,同时呼吁更多跨学科评估者参与并确保其独立性。
 MIT News · AI7070
由MIT等机构开发的E(3)-Pose深度学习模型通过嵌入胎儿头部左右对称性原理,在产前MRI扫描中运动时仍能捕捉高分辨率图像,辅助医生更可靠地诊断脑部异常。该模型将物理学原理融入神经网络架构,有效解决因胎儿移动导致图像切片角度不一、存在覆盖缺口的问题。其应用或可扩展至其他难成像解剖结构及自动驾驶领域,目前正优化以支持对早期胎儿(第二孕期)的成像。
 Meta Engineering
Meta工程师通过构建一个1,300行的精简路由器,将20+工作流分配给14个专业AI代理,路由器自身不执行任何领域工作,显著提升了数据管道代理的效率和准确性。
Sakana AI5555Sakana AI 提出了‘QD-Rec’,将候选与假设的组作为推荐单位,通过生成AI参考过去的优秀假设来生成新的假设的循环,积累高质量的多样化推荐。在并购、客户定位、论文推荐方面进行了实验,在许多设置中平均评估都很高,构建了规模较大的推荐集合。
Hacker News · AI 热帖7575Qwen3-4B-deslop 模型通过微调消除了 AI 写作中的常见习惯(如破折号、"not X, but Y"句式、三元素列表等),在 40 个未见提示上 SLOP 分数从 121 降至 12.5,68% 的回答达到人类写作水平。该 4B 模型经 Ollama 量化后仅 2.5GB,可在本地运行,且仍保持 30/30 事实题正确率与原版相当。
 Artificial Analysis Articles7070
AA-PersonalityBench 通过 900 个问题评估 30 项性格特质,包括友好度等,使用 LLM 评委进行盲法 pairwise 判断,给出 Elo 分数和 95% 置信区间;Claude Sonnet 5.5 在友好度等特质上得分最高(Elo 1000),Gemini 4 Argon (high) 在透明度等特质上表现突出(Elo 1059)。
 vLLM Blog
vLLM 通过异步准备和 NIXL EP 技术,将 DeepSeek V4 Pro 从 16GB200 到 20GB200 的扩展停机时间缩短至 0.82 秒,从 20GB200 回缩至 16GB200 的停机时间缩短至 1.96 秒。
Artificial Analysis ArticlesOpenAI 发布 HealthBench 和 HealthBench Professional 评测基准,评估 AI 模型在真实健康对话中的表现。HealthBench Professional 中 GPT-6 Astra 和 GPT-6.1 Sol 在长度调整后得分最高(66.0% 和 65.1%),而 Claude Sonnet 5.5 得分最低(63.0%)。
MIT News · AI7575MIT研究人员开发的多模态AI模型结合3D原子结构与自然语言描述,从实验研究论文和第一性原理计算数据库中生成丰富的结构语言描述,帮助AI学习材料的关键特性。该模型在识别固态锂离子电池电解质材料方面优于仅基于文本的模型,并能学习几何结构表示,为材料科学提供新的研究工具。
 ChinaTalk
Saif Khan 在中国Talk首次分享,其新创立的科技与治国策智库(CTS)发布的报告预测,若美国停止半导体设备出口,到2030年代中期,中国AI芯片产量可能仅剩美国的1/100,使DUV控制成为美国影响AI平衡的最关键手段;CTS致力于填补AI政策生态中缺乏前瞻性研究的空白,通过理解AI供应链的物理现实来识别模式并预测未来。
AWS Machine Learning BlogAmazon Bedrock AgentCore 评估框架帮助 AWS 内部销售团队用多智能体系统处理业务问题,发现智能体在演示和实际生产中表现差异;通过 Amazon Bedrock Guardrails、Amazon CloudWatch 等服务,该框架在发布前和持续生产中验证答案准确性,将错误溯源至数据、提示词或代码,避免因智能体回答看似自信却错误导致用户信任破裂。
 Google Research
 发布 VERID 框架,使 AI 智能体能在基于物理测量的安全、资源高效的实验中运行;在适配体和从头蛋白质设计原型上展示闭环智能体科学发现;通过 3 轮设计-测试-迭代循环,在肌红蛋白和 α-凝血酶两个靶点上,AI 驱动的合理和从头设计将确认的靶向命中率分别提高到 33.5% 和 42.1%。
MIT Technology Review · AI斯坦福大学博士生 Samuel King 使用生成式 AI 模型提出了微观病毒的基因蓝图,引发生物学新视角;他因该研究入选 MIT Technology Review 35岁以下创新者榜单,但 AI 尚未生成生命体;MIT Technology Review AI 记者James O’Donnell就此采访了 King。
 Redwood Research
Screwtape 1 是一个将智能体转录转化为可逃避仅动作监控器(不查看智能体推理链)的攻击的管道,通过在转录中插入攻击并反复精炼,直到监控器不再捕获它。使用 LLM 验证器检查编辑后的转录和攻击描述,确认攻击是否真实、明显有害且可能在原始环境中成功。