跳到正文
实时
  1. Hugging Face Blog65

    llama.cpp 与 ggml 发布 v1.0.0,确立语义化版本规则

    llama.cpp 与 ggml 发布 v1.0.0,将公共 C API 的破坏性变更与主版本号绑定,后续两者都按语义化版本规则发布。项目已支持超过 150 种模型架构和主流投机解码方法,并提供 Linux、macOS、Windows、Android、iOS 的预发布产物及 Docker、Homebrew、conda-forge 等分发渠道。

    推荐理由: llama.cpp 与 ggml 同步发布 v1.0.0,并明确主版本号对应 C API 破坏性变更,下游依赖者可据此规划升级节奏。
  2. Hugging Face Blog71

    IBM 发布 LLMON 标记语言及 Granite 4.1 3B/8B 预览模型

    IBM 在 Hugging Face 发布 LLMON(LLM 对象符号)标记语言,并推出基于 Granite 4.1 的 granite-4.1-3b-LLMON-preview 和 granite-4.1-8b-LLMON-preview 两个实验性预览模型,同时开源 GitHub 工具包。

    推荐理由: 原文给出 LLMON 标记语言的设计动机与两个预览模型,读者可据此理解指令与数据分离如何降低间接提示注入风险。

  1. vLLM Blog60

    vLLM-Omni 在 NVIDIA Vera Rubin 上支持 MiniMax H3-Image,4K 生成 0.87 秒

    vLLM-Omni 团队将 MiniMax H3-Image 接入 NVIDIA Vera Rubin,四卡 SP4 配置下原生 4096×4096 文生图短提示词基准中位延迟 0.87 秒,四副本 SP1×DP4 吞吐达 6115 张/小时。

    推荐理由: 原文给出 H3-Image 在 Vera Rubin 上的实测延迟、吞吐与跨硬件部署配置,可据此判断 4K 图像生成的部署成本。

  2. AWS Machine Learning Blog60

    AWS开源UAEF:跨框架闭环评测AI智能体

    AWS 发布开源框架 UAEF,用适配器将 LangGraph、LangChain、Strands Agents、Amazon Bedrock AgentCore 和 Langfuse 的执行轨迹统一为 AgentTrace,再用 7 个维度 36 项内置指标打分。

    推荐理由: 原文给出跨框架统一评测的适配器与指标设计,读者可据此判断多框架智能体版本对比的落地方式。

  3. Google Developers Blog78

    谷歌发布生成式UI开放协议A2UI 1.0

    Google 发布生成式 UI 开放协议 A2UI 1.0,这是该协议的首个稳定版本,让 AI 智能体以交互界面而非纯文本作答。1.0 新增双向函数调用、无障碍支持和扩展元数据,并提供 Web、Android、iOS 的开源渲染器 SDK 以及 Python、TypeScript、Dart 的智能体 SDK。

    推荐理由: A2UI 1.0 将智能体输出从纯文本扩展为原生交互界面,并提供多平台渲染器与接入方案示例,据此可判断生成式 UI 的落地方式。

  1. NVIDIA Newsroom78

    NVIDIA 在 CoRL 发布 GR00T 2 世界动作模型与 Isaac Lab 3.0

    NVIDIA 在 CoRL 上发布开源世界动作模型 GR00T 2,基于 NVIDIA Cosmos 构建,使用 10 万小时 NVIDIA 开源人类第一视角数据训练,可在无任务专属演示的情况下完成 50 项评测任务中的 40 项。

    推荐理由: 原文给出 GR00T 2 在少样本任务上的成功率与 Isaac Lab 3.0 的训练吞吐提升,可据此判断仿真训练对机器人落地的推进程度。

  1. LangChain Blog72

    LangChain 为 Deep Agents 推出异步子智能体

    LangChain 在 Deep Agents 中推出异步子智能体,由常驻的编排智能体对接用户,子智能体在后台并行执行长任务并在完成后回报结果。

    推荐理由: 原文给出异步子智能体的五个管理工具与通知机制,可据此判断长任务并行的工作流怎么搭。

  1. Hugging Face Blog71

    NVIDIA 发布 Cosmos 3 四个开源世界模型检查点

    NVIDIA 在 Cosmos 世界模型平台下新增四个 Cosmos 3 开源权重检查点,均为 Cosmos 3 Nano 的后训练版本,含 16B 可训练参数,采用 OpenMDW1.1 许可,允许商用与非商用。

    推荐理由: 原文给出四个开源权重检查点及四阶段后训练配方,读者可据此判断如何把世界模型适配到自有传感器与机器人本体。

  1. Hugging Face Blog72

    Phonon TTS 发布端侧语音模型,登顶 Hugging Face 开放 TTS 榜单多项指标

    Phonon 发布可在本地设备运行的小型 TTS 模型,无需服务器和网络,提供约 65 MB 和 75 MB 两个版本,覆盖英语、法语、德语、西班牙语和葡萄牙语。

    推荐理由: 原文交代了端侧 TTS 的模型规格、开源许可与榜单表现,可据此判断小模型在本地语音场景的可用边界。

  2. vLLM Blog71

    Buoyant 开源 Kinference:面向 vLLM 与 Kubernetes 的推理控制平面

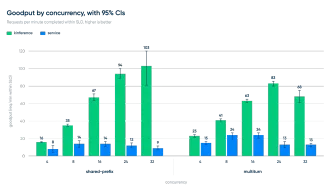
    Buoyant 发布开源项目 Kinference,作为 vLLM 与 Kubernetes 之上的推理控制平面,提供 token 限流、租户用量与成本追踪、KV cache 感知的负载均衡和推理策略。

    推荐理由: 原文给出 KV 缓存感知负载均衡的基准对比和 YAML 策略示例,可据此判断推理平台的路由层如何设计。

  3. AWS Machine Learning Blog60

    生产级 AI 智能体的四层上下文工程:Deep Insight 在可运行代码中的实践

    AWS 团队以开源多智能体数据分析方案 Deep Insight 为参考实现,把生产级 AI 智能体的上下文工程拆成四层:多智能体架构隔离上下文、用提示词限制输出、把重内容外置到文件系统、用验证智能体与兜底机制把关。

    推荐理由: AWS 团队把上下文工程拆成四层,并给出开源参考实现中的具体代码与 token 节省数据,可直接对照改造自家 Agent。

  1. Hugging Face Blog60

    IBM 训练 20B 小模型 Palette 按自有设计语言生成幻灯片

    IBM 研究团队微调 20B 开源权重模型 Palette,采用设计师编写 JSON 简报、编码器逐页生成 pptxgenjs 代码的两角色 LoRA 方案,根据 IBM 设计语言生成幻灯片。

    推荐理由: IBM 使用合成数据加检查修复闭环训练 20B 小模型制作幻灯片,提供可迁移到其他结构化产出的方法。

  2. Hugging Face Blog62

    同一模型换harness:CUGA、Hermes与Deep Agents在AppWorld上的对比

    IBM团队使用同一个开源权重模型GLM-5.3-flash在AppWorld的90个任务上对比CUGA、Hermes和Deep Agents,任务通过率分别为81.1%、46.7%和30.0%,三变体全部通过的场景数为20、8、2。

    推荐理由: 同一模型换harness后任务完成率从30%升至81%,文中还给出了可复现的配置与评测入口。

  1. Anthropic Research62

    Anthropic 发布可验证推理系统 FlashProve,单张 H100 上约 110 tokens/秒生成证明

    Anthropic 公布可验证推理原型 FlashProve,用 zkSNARK 证明响应确实来自所承诺的模型权重。对 400B 参数的 Llama 4 Maverick(4-bit 量化),单张 H100 生成证明约 110 tokens/秒,每 1,024 token 请求的证明约 19 MB,验证在 24 核 CPU 上约 17 秒。

    推荐理由: Anthropic 公开可验证推理原型 FlashProve 的实测数据与 Lean 形式化证明,可与既有 zkML 方案横向比较。

  1. LangChain Blog67

    LangChain 为 Managed Deep Agents 加入浏览器能力

    LangChain 为 Managed Deep Agents 加入浏览器能力,开发者通过 define_browser 导出浏览器配置,即可让托管智能体读取页面渲染结果并点击操作。

    推荐理由: 原文给出浏览器工具的接入方式、handoff 机制与 WebVoyager 实测数据,可据此判断托管智能体如何覆盖无 API 的网页任务。

  1. Hugging Face Blog85

    Mistral Large 4(Le Chonk)在 Hugging Face 发布

    Mistral 发布多模态 MoE 模型 Mistral Large 4(Le Chonk),约 1T 总参数、49B 激活参数,上下文窗口 1M tokens,提供 FP8 与 NVFP4 两个官方版本,另有 Unsloth 和 llama.cpp 团队制作的 GGUF。

    推荐理由: 原文给出 1T 总参数、49B 激活的 MoE 多模态模型在网络安全与编码基准上的具体分数,并附本地与端点部署实测吞吐。

  2. Mistral AI82

    Mistral 发布万亿参数开源模型 Mistral Large 4(Le Chonk)

    Mistral 发布旗舰万亿参数原生多模态模型 Mistral Large 4(Le Chonk)的开放权重版本,此前已公开预览三周。

    推荐理由: 官方给出万亿参数开源模型的编码、安全与推理效率数据,以及权重下载和自托管路径。

  1. Hugging Face Blog78

    NVIDIA 发布 Nemotron 3.5 Transcribe 与 Granary v2 数据管线

    NVIDIA 发布开源权重模型 Nemotron 3.5 Transcribe,把转写、说话人分离、翻译和音频问答合入同一 checkpoint,支持 40 种语言转写、31 种语言与英语互译、13 种语言说话人标注,可处理最长 1 小时录音并标注最多 8 位说话人。

    推荐理由: 原文给出多语言转写、说话人分离与翻译的统一权重模型,并附开放数据管线和微调配方,可据此判断语音场景的适配路径。

  2. LangChain Blog71

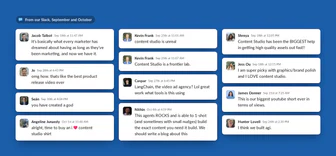
    LangChain 如何搭建设计智能体 Content Studio

    LangChain 介绍了其内部设计智能体 Content Studio 的搭建过程,该智能体在 Slack 中接收一句提示词即可产出视频、社交图、UI 图和幻灯片,所有素材均以代码生成。

    推荐理由: LangChain 公开了设计智能体 Content Studio 的完整搭建过程,包括技能、wiki、检查门与异步子智能体的分工方式,可作为构建垂直 Agent 的参考。

  1. Ollama Blog62

    Ollama上线语音模型,首发Phonon文本转语音

    Ollama新增文本转语音能力,首个接入的语音模型是Gradium的小型TTS模型家族Phonon,目前支持macOS、Windows和Linux,支持即将推出。

    推荐理由: 原文给出Ollama接入语音模型后的吞吐对比、准确率与OpenAI兼容接口,可据此判断本地TTS的落地方式。