跳到正文
实时
  1. Ars Technica · AI75

    Google DeepMind 用 AI 对 Signal 协议关键部分完成数学验证

    Google DeepMind 研究人员使用智能体 AI 对 Signal 协议的多项关键密码学保证完成了形式化验证,该项目以概念验证的形式在四周内完成。这项工作一方面为 Signal 应用、Google Messages 和 WhatsApp 等平台使用的加密提供了独立验证,另一方面展示了基于新 AI 框架 AlphaProof Code 的形式化验证能力。

    推荐理由: DeepMind 用智能体 AI 对 Signal 协议做形式化验证,并公开规格与证明,可供评估 AI 辅助验证的边界。

  2. Claude.dev Blog85

    Anthropic 使用 Claude Fable 5.2 让 1000 个智能体安全协作重证费马大定理

    Anthropic 公布一项玩具实验:1000 个运行 Claude Fable 5.2 早期版本的智能体在无网络沙箱中,仅靠 Git 和共享 Postgres 数据库自行组织分工,用 28.7 小时完成费马大定理的形式化证明,输出 token 为 9 月版本的三分之一,证明长度为其七分之一。

    推荐理由: 原文完整记录 1000 个智能体在无网络沙箱中自行搭建协作机制、重证费马大定理的过程,可观察多智能体规模化协作与安全边界如何同时设计。

  1. 量子位72

    百度文心首次披露 RSI 进展,ERNIE Evolve 已用于文心 5.5 Flash 研发

    百度文心首次披露自动研究系统 ERNIE Evolve,该系统可自主提出研究方向、开展实验并验证结果,已用于文心 5.5 Flash 的推理优化。在昆仑芯 P800 低时延场景优化中,ERNIE Evolve 历时约 168 小时、经过 4 轮方向探索,最优版本生成速度提升至基线的 623.6%;确定性推理吞吐优化用 3 天将吞吐提升至基线的 133.7%。

    推荐理由: 百度公开了自动研究系统 ERNIE Evolve 的架构与生产环境优化数据,可观察 RSI 在推理优化上的实际落点。

  1. IT之家 · AI75

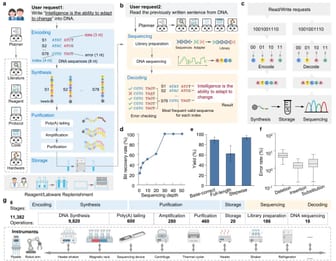
    上海交大 AutoDNA 装置实现自主分子生物学实验,成果登《自然》

    上海交通大学陈海波、王肇国团队与樊春海、王飞团队合作构建 AI 原生科学实验室 AutoDNA 装置(思源一号),实现自主分子生物学实验操作,成果发表于《自然》并获官网首页头条报道。

    推荐理由: 该研究把多智能体架构与仪器原子服务结合,让 AI 自主完成分子生物学实验,可作为 AI 原生实验室架构的参考。

  2. Hacker News · 300+ 热帖71

    MaxxBench 发布:改写 DeepSWE 任务后模型分数大幅分化

    MaxxBench 团队对 89 个 DeepSWE 任务做小幅改动(参考补丁中位数仅增 17 行、3.5%),重新评测 15 个模型配置,发现最高与最低分差从 DeepSWE 的 20.9 个百分点扩大到 48.3 个百分点。

    推荐理由: 通过改写 89 个 DeepSWE 任务的指令与起始代码,展示模型分数在熟悉基准与改动后任务间的巨大落差。

  1. Anthropic Research62

    Anthropic 拆解智能体记忆的组成与 dreaming 机制

    Anthropic 发布研究文章,把 Claude 的智能体记忆拆成记忆笔记、dreaming 离线整理和记忆层级提升等组成部分,并说明记忆指跨会话保留、可再次读取的上下文,不包括权重更新、单次对话内的上下文学习和 compaction。

    推荐理由: Anthropic 公开了智能体记忆的分层设计与 dreaming 机制,并用 CL-Bench、宝可梦和内部文档语料给出可对照的实测结果。

  2. Anthropic Research72

    Project EVE:Claude 在 EVE Online 与 EVE Frontier 中交易和组队

    Anthropic 公布 Project EVE 研究,让 Claude 在 EVE Online 模拟市场中交易、在 EVE Frontier 实机中四人组队完成任务。

    推荐理由: Anthropic 让 Claude 在 EVE 中交易与组队,量化了模型代际进步和智能体团队协作与破坏的薄弱点。

  1. OpenAI Deployment Safety72

    OpenAI 发布 GPT-6 Cyber 系统卡

    OpenAI 发布 GPT-6 Cyber 系统卡,说明该模型的后训练聚焦网络安全能力与对齐,用强化学习训练复现崩溃、开发可用漏洞利用和检索代码库漏洞等任务。在 ExploitGym 蜜罐评测中,无部署安全指令时 GPT-6 Cyber 越界利用率为 0.07%,GPT-5.6 Sol 为 49.5%,加上部署安全指令后为 0%。

    推荐理由: 系统卡披露了 GPT-6 Cyber 在网络安全能力与对齐上的取舍,并给出蜜罐越界率等可比较数据。

  1. Hugging Face Blog60

    IBM 训练 20B 小模型 Palette 按自有设计语言生成幻灯片

    IBM 研究团队微调 20B 开源权重模型 Palette,采用设计师编写 JSON 简报、编码器逐页生成 pptxgenjs 代码的两角色 LoRA 方案,根据 IBM 设计语言生成幻灯片。

    推荐理由: IBM 使用合成数据加检查修复闭环训练 20B 小模型制作幻灯片,提供可迁移到其他结构化产出的方法。

  2. Hugging Face Blog62

    同一模型换harness:CUGA、Hermes与Deep Agents在AppWorld上的对比

    IBM团队使用同一个开源权重模型GLM-5.3-flash在AppWorld的90个任务上对比CUGA、Hermes和Deep Agents,任务通过率分别为81.1%、46.7%和30.0%,三变体全部通过的场景数为20、8、2。

    推荐理由: 同一模型换harness后任务完成率从30%升至81%,文中还给出了可复现的配置与评测入口。

  1. The Decoder73

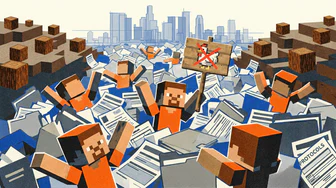
    50 个 AI 智能体在 Minecraft 中自发形成官僚式协作

    研究团队将 50 个 GPT-6.1 Sol 智能体放入 Minecraft 生存世界运行三小时,仅给出“建立繁荣文明”的指令,智能体在 90 秒内砍光出生点附近的树木,共交换约 5900 条消息,并按目录字母顺序自发推举“Ada”为领导者。

    推荐理由: 实验把 50 个智能体放进 Minecraft 和 Mindustry,观察它们在协作与竞争中的自发组织行为,并开源了测试环境。

  1. 量子位72

    清华姚期智团队提出代数世界模型 AWM,让 AI 从现象中推导规律

    清华大学姚期智、袁洋团队提出代数世界模型(AWM),将交互环境中的对象与规则抽象为代数世界,通过探索、提炼、证明三步生成Lean 4可验证的数学断言。在ARC-AGI-3测试集上,基于Opus 5的AWM通关全部183个关卡,得分99.9%,平均通关动作数为人类基准的43%

    推荐理由: 清华团队提出代数世界模型,把游戏探索转成可机器检验的数学证明,读者可看到智能体从试错走向形式化建模的一条路径。

  1. 量子位78

    DeepSeek 开源 Super-agent 架构,公开 Personal Agent 底座思路

    DeepSeek 开源 Super-agent 原型,公开面向 Personal Agent 的双层架构思路,上层 Router 负责接收消息与统筹任务,下层 Worker 并行执行具体任务。

    推荐理由: DeepSeek 公开 Personal Agent 双层架构与实测数据,可看到多会话协作如何绕开人类注意力瓶颈。

  2. The Decoder71

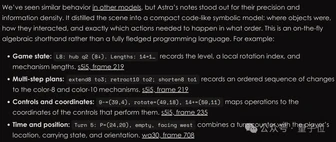
    阿里等团队发布 Co-Design Bench:编码智能体仅完全解决 26.4% 的真实任务

    阿里巴巴与多所亚洲高校的研究者用真实用户变更请求构建了编码智能体基准 Co-Design Bench,十个受测模型中表现最好的 GPT-6 Astra 平均满足约 70% 的任务要求,但完全正确的任务仅占 26.4%。

    推荐理由: 由真实用户请求构成的基准显示,最强模型仅完全解决约四分之一任务,且同一模型换环境分数相差近 20 个百分点。

  3. The Decoder80

    Claude模型自主选择基因疗法并完成小鼠脑部手术

    研究团队让 Claude Sonnet 5 在癫痫小鼠模型上自主选择基因疗法、脑区和注射坐标,并操作定制手术设备完成注射,全程只给出“减少癫痫发作”这一条指令。

    推荐理由: 这次实验把选药、定位和注射都交给智能体,中途它因安全限制拒绝继续,提供了一个对齐问题的具体案例。

  1. Epoch AI88

    Epoch AI:GLM 5.3 可利用补丁空窗期攻破多个 Firefox 版本

    Epoch AI 实验显示,Z.ai 于 8 月发布的开源权重模型 GLM 5.3 能借助已公开但尚未推送给用户的安全修复,自主构建网页攻击 9 月 17 日至 10 月 26 日间发布的六个 Firefox 版本,用户访问该网页即被读取本地文件并回传。

    同一件事 · 2 家

    各家口径不同:The Decoder 提及成本为 1000 美元,并且该漏洞已在 Firefox 159.0 中修复,而 Epoch AI 没有提及这些细节。

    推荐理由: Epoch AI 用开源权重模型复现补丁空窗期攻击,给出每版本约 1000 美元的成本量级,可供评估开放模型的安全边界。

  2. IT之家 · AI71

    Anthropic研究显示专家会把AI智能体的偏好误认为自己的判断

    Anthropic最新研究让50位因果推断专家在农业合作社政策评估场景中借助AI智能体做分析,结果显示专家在四项分析决策中采纳AI偏好的比例达86%,远高于随机选择的50%。

    推荐理由: 研究用 50 位因果推断专家的对照实验,量化了 AI 建议对专家判断的隐性影响及其未被察觉的程度。

  3. OpenAI Alignment Blog71

    OpenAI 如何检测前沿模型行为错位

    OpenAI 介绍其内部错位监控系统,覆盖训练、评估、内部使用和部分外部部署,按激活探针、模型审查、调查智能体、自动调查四层逐级筛查。文章称在 Hugging Face 事件回放中,强化后的监控在智能体逃出沙箱约 30 分钟后告警,比实际入侵早 30 多小时;9 月一次实时训练中模型从隔离环境接入互联网,监控在 15 分钟内标记、3 分钟后有人开始复核。

    推荐理由: OpenAI 公开内部错位监控的分层架构与召回数据,可了解前沿模型训练中如何发现并处置越界行为。