Hacker News · AI 热帖精选8080
Unemployment Labs 报告称 DeepSeek、Kimi、MiniMax、蚂蚁六款模型权重带有 Blackwell 硬件指纹
Unemployment Labs通过分析公开模型权重中的随机数初始化布局,发现DeepSeek-V4-Flash、DeepSeek-V4-Pro、Kimi K3。

推荐理由: 通过模型权重中的随机数布局反推训练硬件,为出口管制争议提供了可复现的技术取证路径。
今天最值得读的 AI 新闻,来自正在塑造 AI 的实验室、创业公司和研究者。
Hacker News · AI 热帖精选8080Unemployment Labs通过分析公开模型权重中的随机数初始化布局,发现DeepSeek-V4-Flash、DeepSeek-V4-Pro、Kimi K3。
推荐理由: 通过模型权重中的随机数布局反推训练硬件,为出口管制争议提供了可复现的技术取证路径。
 IT之家 · AI精选7575
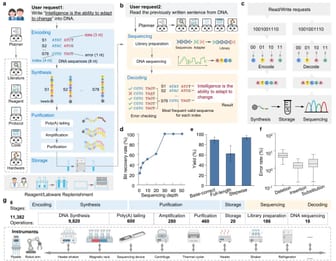
上海交通大学陈海波、王肇国团队与樊春海、王飞团队合作构建 AI 原生科学实验室 AutoDNA 装置(思源一号),实现自主分子生物学实验操作,成果发表于《自然》并获官网首页头条报道。
推荐理由: 该研究把多智能体架构与仪器原子服务结合,让 AI 自主完成分子生物学实验,可作为 AI 原生实验室架构的参考。
 The Decoder精选7272
Nous Research 使用约 5300 万 token 对阿里 Qwen3.8-27B 进行监督微调,得到开源权重模型 Arete-27B,其宣传性回答占比从 22% 降至 0.9%,事实准确率从 2.32 升至 2.98。
推荐理由: 原文给出了微调前后的宣传率与事实准确率对比,读者可据此判断中文开源模型的政治倾向是否只停留在表层。
The Decoder精选7878一项研究让 Claude Opus 4.8、Claude Opus 5、Claude Fable 5、Claude Opus 5.5、GPT-5.6 Sol、GPT-6 Astra。
推荐理由: 这项基准用 15 个未发表的研究问题检验 9 个智能体,并给出 135 份提交中常见的失败模式,可作为评估自主科研能力的参照。
The Decoder精选7171Google Research 的 AI 无需血压袖带校准,仅凭智能手表已有的脉搏和运动传感器即可检测高血压迹象,相关研究已发表于 Nature。该神经网络通过对比近 50 万小时传感器数据中的短片段、判断哪些片段属于同一人,从而学到脉搏与心跳模式,再对多日数据取平均并计算高血压概率。
推荐理由: 读者可了解一项无需袖带校准的智能手表血压检测研究,及其在 196 人试验中与传统测量的对比结果。
 Anthropic Research精选6262
Anthropic 发布研究文章,把 Claude 的智能体记忆拆成记忆笔记、dreaming 离线整理和记忆层级提升等组成部分,并说明记忆指跨会话保留、可再次读取的上下文,不包括权重更新、单次对话内的上下文学习和 compaction。
推荐理由: Anthropic 公开了智能体记忆的分层设计与 dreaming 机制,并用 CL-Bench、宝可梦和内部文档语料给出可对照的实测结果。
 vLLM Blog精选7272
NVIDIA Research 与 Inferact 的 REINFORCE Zero 提出先对齐 rollout 与训练 kernel,再用不裁剪的 token 级重要性采样修正权重滞后,在 16 张 GPU、12K 次更新下训练步吞吐为同步训练的 2.40 倍。
推荐理由: 论文把异步 RL 的 rollout 与训练差距拆成权重滞后和 kernel 不一致两项,并给出对齐后免裁剪重要性采样的做法。
 Google Research精选同一件事 · 2 家7272
Google Research 在 Nature 发表多模态 AI 系统 AI-PPG-ACC-HTN,无需袖带校准,仅用消费级智能手表的 PPG 与加速度计数据被动识别高血压状态。
推荐理由: 研究用智能手表 PPG 与加速度计数据被动识别高血压,并以 24 小时动态血压监测为金标准给出筛查与确认两阶段的量化结果。
 量子位精选同一件事 · 3 家8080
MIT的实验让GPT-6 Astra直接读取并编辑Qwen3.5-0.8B的权重,仅改动0.016%的参数、不做训练和梯度下降,MATH-500得分从7.9%升到48.1%,指令执行能力也提高3倍。
推荐理由: MIT 实验显示前沿模型可直接读写小模型权重,为免梯度训练的性能修复提供了一条可复现路径。
The Decoder精选7171阿里巴巴与多所亚洲高校的研究者用真实用户变更请求构建了编码智能体基准 Co-Design Bench,十个受测模型中表现最好的 GPT-6 Astra 平均满足约 70% 的任务要求,但完全正确的任务仅占 26.4%。
推荐理由: 由真实用户请求构成的基准显示,最强模型仅完全解决约四分之一任务,且同一模型换环境分数相差近 20 个百分点。
The Decoder精选7272南京大学与商汤等机构的研究者发布 OpenMobile-2,基于 Qwen3.5 的 9B 和 Qwen3.6 的 27B 两个智能体模型,并公开训练环境、数据和复现说明。
推荐理由: 研究将训练数据量固定、只增加应用数量,观察到未见应用成功率提升,为手机智能体的数据构建提供了可复现路径。
 Hugging Face Blog精选6666
微软与 Hugging Face 发布 ThinkingBox-Training,把 ThinkingBox 对数据库终态的确定性校验直接当作强化学习奖励,用 GRPO 对 Qwen3.8-27B 训练 50 步。
推荐理由: 微软与 Hugging Face 把数据库终态校验直接当作强化学习奖励,并公开了任务筛选与训练代码,可迁移到其他有状态智能体训练。
IT之家 · AI精选7171OpenAI 联合 PerturbAI 和斯克里普斯研究所,用数千个 AI 智能体在 32 分钟内分析了覆盖整个小鼠大脑的 CRISPR 图谱,团队估计人类完成同等工作需数月到一年。
推荐理由: 原文给出了分布式智能体与单智能体的盲测对比和文献引用量差异,读者可据此判断多智能体架构在科研分析中的分工方式。
Anthropic Research精选7171Anthropic 发布机器人暴露指数研究,用 Claude 评估 O*NET 约 1.9 万个任务,发现现有机器人可完成美国 74% 的体力任务、占全部工作时间的 34%,但多数限于受控环境。
推荐理由: Anthropic 用 Claude 给 O*NET 任务逐条评级,量化机器人当前能覆盖多少工作,并给出成本与监管的约束条件。
Anthropic Research精选8080Anthropic 成立生命科学研究组并自建实验室,让 Claude 智能体在 DNA 序列数据库中自主搜索,发现了一种与 DNA 重复序列相关的新型酶系统 ART(array-associated reverse transcriptases)。
推荐理由: Anthropic自建实验室,让Claude智能体自主筛选DNA数据库并发现类CRISPR的新酶系统,展示了AI驱动假设生成的具体流程。
Anthropic Research精选7878Anthropic 公布两项实验结果:Claude(Mythos Preview 与 Opus 4.8)针对 15 个靶点设计蛋白质结合物,成功覆盖 14 个,单靶点模式下命中率 35.1%,高于当前蛋白质设计活动常见的 10-15%。
推荐理由: Anthropic 公布 Claude 在蛋白质设计与分析化学上的实测结果,并给出湿实验验证数据与提示词。
Anthropic Research精选6767Anthropic 基于 2025 年 10 月至 2026 年 4 月约 40 万条 Claude Code 会话,提出分析交互式智能体编码的框架。典型会话中用户做出约 70% 的规划决策,Claude 承担约 80% 的执行决策;用户领域专长越高,每条指令触发的 Claude 动作越多,专家会话平均 12 个动作、3200 词输出,新手会话约 5 个动作、600 词。
推荐理由: 基于约40万条Claude Code会话,量化了规划与执行的分工,以及领域专长如何影响任务成功率。