跳到正文
实时
  1. Google DeepMind76

    Google DeepMind 发布 Gemini Robotics 2.5 视觉-语言-动作模型

    谷歌 DeepMind 发布了 Gemini Robotics 2.5,称其为目前能力最强的视觉-语言-动作(VLA)模型,在 200 项任务上相比此前基线成功率提升 30% 至 100%,完成任务速度快 20% 至 30%。
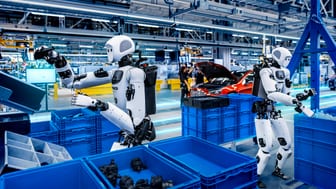
    推荐理由: 官方披露了 200 项任务评测与奔驰产线 96% 成功率的实测数据,可据此判断 VLA 模型在真实工业场景的落地程度。

  1. Hugging Face Blog71

    NVIDIA 发布 Cosmos 3 四个开源世界模型检查点

    NVIDIA 在 Cosmos 世界模型平台下新增四个 Cosmos 3 开源权重检查点,均为 Cosmos 3 Nano 的后训练版本,含 16B 可训练参数,采用 OpenMDW1.1 许可,允许商用与非商用。

    推荐理由: 原文给出四个开源权重检查点及四阶段后训练配方,读者可据此判断如何把世界模型适配到自有传感器与机器人本体。

  1. IT之家 · AI78

    智元发布具身模型 GO-3 Preview,登顶三大榜单并计划 2026 年底开源

    智元于 10 月 29 日推出具身模型 GO-3 Preview,采用具身原生的 WRAM 架构,把任务推理、未来预测与动作生成连接起来,并已登顶 RoboDojo、RoboTwin、RoboColiseum 三大评测榜单,计划 2026 年底全面开源。

    推荐理由: 原文给出便利店真机任务成功率从 28.6% 到 85.7% 的部署后数据,可观察具身模型在线自我改进的路径。

  1. Hugging Face Blog66

    NVIDIA 发布 Cosmos3-H-Dreams 手术生成式模拟模型

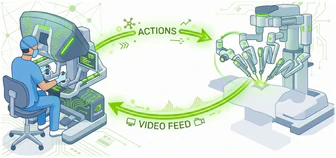
    NVIDIA 发布 Cosmos3-H-Dreams,把交互式生成模拟扩展到临床胆囊切除场景,可依据器械动作实时生成手术画面。

    推荐理由: 原文交代了从桌面缝合到临床胆囊切除场景的迁移路径,以及四步与两步蒸馏检查点之间的质量与延迟取舍。

已浏览全部内容