Microsoft AI News
微软AI发布80亿参数MoE大模型MAI-Base-2
微软AI完成新MoE大模型MAI-Base-2的预训练,拥有80亿活跃参数和2.8万亿总参数,在内部评估中超越所有开源模型。该模型比开源最强基座模型DeepSeek-V4-Pro-Base预训练FLOPs效率高出4-12倍,并用于训练更大模型。微软通过全栈控制,使用有机数据预训练,计划通过Foundry授权模型权重。
Microsoft AI News微软AI完成新MoE大模型MAI-Base-2的预训练,拥有80亿活跃参数和2.8万亿总参数,在内部评估中超越所有开源模型。该模型比开源最强基座模型DeepSeek-V4-Pro-Base预训练FLOPs效率高出4-12倍,并用于训练更大模型。微软通过全栈控制,使用有机数据预训练,计划通过Foundry授权模型权重。
 Baseten Blog
NVIDIA Nemotron 3.5 Super VL 结合视觉理解、推理和工具使用,支持读取文档、图像、应用界面和视频,在 GDPval 评测中得分 1190 Elo,高于 Nemotron 3 Super 的 493。开发者可通过 Baseten Loops SDK 进行微调,并利用 NVFP4 权重在 Blackwell GPU 上评估。
 Apple Machine Learning Research
在四台 Mac Studio 集群上,Muse Spark Open(816B 参数)生成速度超过 36 tokens/秒。Mac Studio M5 Ultra 版本比 M3 Ultra 在推理速度上提升 4.6 倍(TTFT)和 1.6 倍(tokens/秒),得益于 GPU 神经加速器和 1.2 TB/s 内存带宽。
 Cohere Blog
十六位 Claude 代码智能体在约 2000 次智能体会话和 2 万美元 API 成本内编写出可构建 Linux 内核的 10 万行 C 编译器;Cursor 让数百智能体在约一周内从零编写出超百万行代码的浏览器。
Apple Machine Learning Research4040Apple Machine Learning Research 首次从零开始预训练文本、图像-文本和音频-文本数据的三模态掩码扩散模型(MDM),分析多模态扩展规律。
 Comfy Blog5858
Nvidia 的 RTX 视频效果节点已集成到 ComfyUI 中,可在 Nvidia RTX GPU 上本地运行。
 Google DeepMind
Gemini 4 Argon 在物理理解、代码生成和视觉语义推理方面取得重大突破,在 Embodied Reasoning (ERQA) 基准测试中纯推理得分 87%,超越所有前沿模型。Argon 可应用于机器人生命周期的各个环节,包括使用 MuJoCo 进行移动操作练习、零样本机器人控制和视频世界模型的闭环转向。
 OpenAI News5555
Higgsfield 推出 GPT-6 Astra、GPT-Image-2.5 和 GPT-Live,支持创作者制作更长的视频、实现精确的视觉效果,并提供语音电影制作的路径。
 Prime Intellect Blog
Prime Intellect 收购 Moondream,其创始人将加入 Prime Intellect 负责推理和跨模态模型开发。Moondream 3.1 在物体检测、航拍图像、图表和拥挤场景(如货架)上表现优异,每秒处理 34 个请求,比下一准确的开源模型快 24 倍,在达到 Meta 新模型 Muse Wonder 80% 准确率时成本仅为其千分之一。
 Amazon Science
亚马逊科学提出 Priming 技术,通过利用预训练 Transformer 权重将混合状态空间模型的预训练成本降低 99% 以上,使开发者能够研究此前因成本过高而难以探索的问题。
 Import AI4242
《人类第六感》评测显示GPT 6 Astra在直观视觉推理任务中pass@1得分53.6,远低于人类基线93.1,其中中国开源模型GLM-5.3-flash和Kimi K3分别得分26.8和25.5。
 Baseten Labs7575
Base Labs 研究发现,使用 talkie-1930-13b-it 模型迭代学习 2011-2019 年体育事实会导致事实遗忘,遗忘事实仍存在于模型权重中。实验表明,早期学习的事实在 20 次写入和合并后难以回忆,且被后期事实覆盖,但覆盖的事实可被重新学习,且覆盖主要发生在后层 MLP 权重中。
 Anthropic Research
Claude Code v2.1.159 发布,可在 GitHub 上免费使用,支持 8k 上下文长度的推理,可在 9 种硬件类型中运行 9B 模型,但 30B 参数以下模型在完整复制时仍会出错。
 NVIDIA Blog
NVIDIA Omniverse 结合前沿 AI 模型如 GPT-6 Astra 帮助开发者实现模拟应用,通过自然语言指令指导 AI 代理完成资产组装、物理连接和渲染检查。
 AWS Machine Learning Blog
Amazon SageMaker HyperPod 通过 AWS IAM Identity Center 进行集中认证,使用 SageMaker AI 域提供定制用户体验,结合 Kubernetes 命名空间实现工作负载隔离,并利用 HyperPod 任务治理进行公平资源分配,支持多团队高效共享单个 HyperPod EKS 集群。
OpenAI NewsPollo AI 通过 GPT-5.6、GPT-6 Astra 和 GPT‑Image‑2.5 帮助创作者将大胆想法转化为详细图像和电影级视频广告。
 Google Developers Blog
谷歌 AI 边缘团队开源 ML Drift,这是一个高性能、跨平台的边缘设备 GPU 计算引擎,用于设备端 AI/ML 推理。通过抽象 OpenGL ES、OpenCL、Metal 和 WebGPU 等硬件低级 API 的复杂性,ML Drift 使开发者能构建实时交互式 AI 体验。
 Ars Technica · AI6565
艺术工坊推出包含 7 个开源应用套件,仿制 Adobe Photoshop、Illustrator 等,使用 Anthropic Claude Opus 5.5 和 Rust 开发,承诺未来达到 Adobe 功能水平。
Ars Technica · AI7575Google将SynthID检测器扩展到所有合作伙伴的水印。用户可以通过新网站SynthID.com查询AI内容是否包含SynthID标签,无需依赖Gemini模型。该检测器已集成Google 1800亿图像视频及240,000年音频的SynthID数据,现在支持跨平台水印识别。
 OpenRouter Blog7575
ElevenLabs 在 OpenRouter 平台上线九款文本转语音模型和两款语音转文本模型,支持已通过 OpenRouter 调用语言模型的应用实现语音交互。Eleven v4 可用于长文本配音并控制语调和表达,v4 Turbo 提供低延迟语音回复,Scribe v2 支持带说话人标签的会议转录。所有模型对 OpenRouter 客户在 10 月 19 日前提供 50% 折扣。
NVIDIA BlogiSono Health 的 ATUSA 平台通过 AI 驱动的 3D 量化超声系统,将乳腺癌筛查时间缩短至每侧约两分钟,其敏感度比传统手持 2D 超声高 28%
 Liquid AI Blog
Liquid AI 推出 d1 决策模型,现支持文本与图像输入,在六项实际应用中超越 GPT-6.1 Sol 和 Claude Opus 5.5,成本降低 19-200 倍且速度显著提升。
Amazon ScienceAmazon Science 发布图形中心智能体技术,通过将网络表示为包含设备属性和连接的持续同步图(数字孪生),结合级联图算法(分解、聚合、溯源)和智能体编排,实现复杂网络故障的分钟级根因分析,在 NTT DOCOMO 的 MWC 演示中达到 95% 准确率。
Google Developers Blog稀疏视频生成(SVG)通过识别视频扩散模型中不同注意力头的时空结构,动态路由注意力头至空间或时间掩码,将理论上的稀疏性转化为实际端到端速度提升。在TPU v6e上,SVG保留约38.87%的查询-键对,实现3.5倍推理加速,同时保持给定稀疏度下的输出质量。该方案采用自定义JAX和Pallas Splash注意力内核,将理论稀疏性转化为硬件上的物理稀疏性。
 Claude.dev Blog
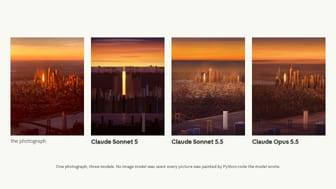
Claude Sonnet 5.5 是 Claude 5.5 家族继 Opus 5.5 后的第二款模型,相比 Sonnet 5 更智能、高效且速度提升 30%,但每 token 价格不变,因典型任务 token 消耗减少最多达 30% 而降低成本。
Anthropic ResearchAnthropic 的 Claude 成功计算 N=4 超杨-米尔斯理论九圈幅角,突破此前两圈的计算极限,该模型基于 LLM 技术并采用 CoT 推理方法。
 Qwen · Hugging Face 新模型
Qwen/Qwen-Image-2.1-PE-I2I 发布,一个 7B 参数的统一文本到图像生成与编辑模型,包含 32 层单流 DiT 架构,支持生成常规或透明图像、编辑透明图层、提取照片主体,并具有 10 张参考图像编辑能力。
Qwen · Hugging Face 新模型Qwen/Qwen-Image-2.1-PE-T2I发布,一款7B参数的统一文本到图像生成与编辑模型,包含32层单流DiT架构,支持生成常规或透明图像、编辑透明图层、提取照片主体,并可通过圆形、涂鸦标注或独立掩码进行局部编辑。其文本到图像提示词重写模型Qwen3.5-VL 9B可将多语言请求转化为详细英文提示词并推荐宽高比。
 Cognition Blog
SWE-2是我们迄今最先进的编码模型,在FrontierCode 1.1 Main评测中取得50.0%分数,以64%的成本优势接近Fable 5.1的表现,并首次将强化学习扩展到万亿参数规模。
 DeepSeek · Hugging Face 新模型
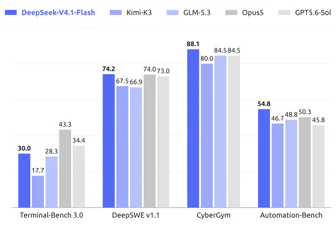
DeepSeek-V4.1-Flash 是一个 552B 参数的多模态 MoE 模型,支持高达一百万 token 的上下文,原生处理图像和文本并自回归生成文本。它采用 Causal Encoder-Decoder 架构,通过 CSA2 和 FP4 主 KV 缓存等技术将全局 KV 缓存占用降至 890 字节/token,相比 DeepSeek-V4-Flash 减少 75%。
 Microsoft Research
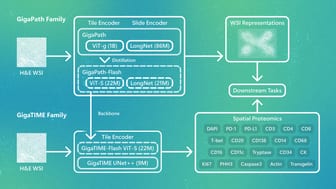
GigaPath-Flash 和 GigaTIME-Flash 通过精简的 ViT-S 编码器显著降低了计算需求,在保留性能的同时使大规模病理学研究更易实现。
DeepSeek · Hugging Face 新模型DeepSeek-V4-Flash-Vision-Exp 发布,DeepSeek-V4 家族首个实验性多模态模型,在 DeepSeek-V4-Flash 架构基础上集成视觉模块并持续训练以解锁视觉理解能力。
Import AI7575研究显示 AI 加速了网络漏洞发现,但对数学研究影响较小,且 AI 研究本身未见明显加速。SPADE 项目通过自博弈在合成环境中生成训练数据,使用 Qwen3-30B 模型效果最佳,在游戏和工具环境任务上均显著提升性能。Hawkeye 工具用于优化 GPU 内核构建。
Liquid AI BlogLiquid AI 与 Artificial Analysis 联合发布 Pipette,一个开源平台,用于在边缘设备上基准测试基础模型。
Liquid AI BlogDSpark 推出 LFM2.5-1.2B-Instruct、LFM2.5-2.6B 和 LFM2.5-8B-A1B 三款推测解码模型,通过增加少量内存开销实现高达 GPU 3.18 倍、设备端 2.87 倍的推理加速,输出质量不变。
Prime Intellect BlogPrime Flash MoE 是一组专为 Blackwell 优化的 CUDA 内核,通过避免某些中间张量的显式创建以及在融合配置中避免激活张量的显式创建,从而显著减少内存流量。
Microsoft AI NewsMAI-Image-2.6 发布,在 Arena 文本到图像排行榜上排名第二,整体评分比 MAI-Image-2.5 提升 +79 Elo,并在所有 Arena 文本到图像类别中取得进步,文本渲染能力提升 +91 Elo,领先 Meta、Google 和 xAI 的模型。
 MiniMax News
MiniMax 发布 H3 模型,支持文本、图像、视频和音频的统一上下文理解,能生成带原生立体声的 2K 分辨率视频(最长 15 秒)。
 Berkeley AI Research
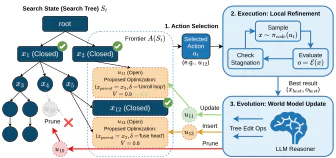
K-Search 通过 CUDA-to-MLX 结构化转换层,将 CUDA 核心知识迁移至 Apple Silicon MLX 平台,在 Attention 核心上实现与原生 MLX 0.97x 性能提升,Mamba SSM 核心上较社区实现 20x 预填速度提升。
 Meta AI Blog
Meta AI 的 DINOv3 和 SAM 模型在边缘计算中实现实时感知,支持匹兹堡大学 RAMMP 项目开发辅助机器人,通过自然语言与图像数据交互,降低用户认知负荷,已在原型中集成自动门按钮检测、杯子识别及导航辅助功能,并计划增加语音和触控输入支持。