Microsoft Research
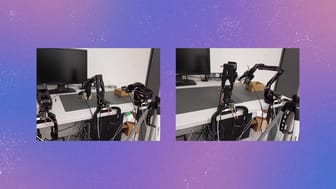
 探索将物理 AI 推理卸载到边缘或云 GPU 的优势。
将物理 AI 推理卸载到边缘或云 GPU 可显著提升机器人任务成功率、支持更大模型并延长电池寿命。在移动操作任务中,卸载推理使机器人响应速度和准确性提升,电池续航增加,成本降低。Microsoft Research 开发了基于 Kubernetes 的工具集,支持在机器人、边缘设备和云端进行分布式推理部署。
Microsoft Research将物理 AI 推理卸载到边缘或云 GPU 可显著提升机器人任务成功率、支持更大模型并延长电池寿命。在移动操作任务中,卸载推理使机器人响应速度和准确性提升,电池续航增加,成本降低。Microsoft Research 开发了基于 Kubernetes 的工具集,支持在机器人、边缘设备和云端进行分布式推理部署。
 小米 MiMo · Hugging Face 新模型
小米 MiMo 通过在 MiMo 生成的数据上对 Qwen3.5-9B 进行监督微调,发布了 9B 参数的智能体模型 MiMo-V2.6-Distill-Qwen-9B,涵盖编码、通用智能体任务、视觉编码和网络安全领域。
Microsoft ResearchRetroChimera 在 Nature 上发布,结合 R-SMILES 2 和 NeuralLoc 模型进行逆合成预测。该框架通过学习型集成策略排名,在盲测中优于现有模型,专家更认可其复杂分子拆解建议。模型开源,旨在加速新医药分子和先进材料开发。
 Qwen · Hugging Face 新模型
Qwen/Qwen-Image-2.1-PE-I2I 发布,一个 7B 参数的统一文本到图像生成与编辑模型,包含 32 层单流 DiT 架构,支持生成常规或透明图像、编辑透明图层、提取照片主体,并具有 10 张参考图像编辑能力。
Qwen · Hugging Face 新模型Qwen/Qwen-Image-2.1-PE-T2I发布,一款7B参数的统一文本到图像生成与编辑模型,包含32层单流DiT架构,支持生成常规或透明图像、编辑透明图层、提取照片主体,并可通过圆形、涂鸦标注或独立掩码进行局部编辑。其文本到图像提示词重写模型Qwen3.5-VL 9B可将多语言请求转化为详细英文提示词并推荐宽高比。
 Mistral AI
Mistral 模型已为 Mozilla 的 AI 浏览助手 Firefox Smart Window (beta) 提供动力,帮助用户处理复杂搜索、记忆重要信息和基于浏览器标签页获取信息,目前服务于法国和北美用户,英国和德国预计今年晚些时候加入。
 Cognition Blog
Cognition 与 AWS 达成战略合作,通过 Devin 智能体帮助企业在 AWS 上部署自主工程师,加速遗留系统迁移、清空安全与工程积压,使团队能专注于新产品开发。Devin 可理解代码库、规划方案、编写代码并测试,工程师仅需决策与审核。客户已可通过 AWS Marketplace 购买 Devin 并使用 Agent Toolkit,预计可将现代化项目时间从数年压缩至数月。
 Google · Hugging Face 新模型
谷歌发布了EmbeddingGemma 2,一个包含740M参数的多模态嵌入模型,支持文本、图像、视频和音频的统一768维向量表示。该模型可在消费级硬件上运行,提供低延迟的语义表示,适用于搜索、检索增强生成等应用。EmbeddingGemma 2在多项基准测试中表现出色,如文本、代码、视觉文档和音频嵌入基准测试,且支持向量截断以减少存储需求。
 LangChain Blog精选7171
LangChain 公开其付费媒体智能体的构建方法,该智能体运行在 Slack 中,每周汇总广告平台与仓库数据并生成报告,付费媒体在六个月内从贡献 0 提升到营销管道的 20%,单条合格线索成本在 6 月至 8 月下降 30%。
推荐理由: LangChain 公开付费媒体智能体的完整工程细节,包括上下文分层、工具按需发现和子智能体隔离,可作为自建长时运行智能体的参考。
Mistral AICloudera 与 Mistral 合作,将 Mistral 模型集成 Cloudera 混合数据平台,使企业可在私有云、公有云、本地及完全隔离环境中部署 AI 模型并保持完全控制权;Mistral 允许企业在受控环境中使用专有数据训练 AI 模型,将数十年机构数据转化为定制 AI 模型,同时保留数据和智能的所有权。
 DeepSeek · Hugging Face 新模型
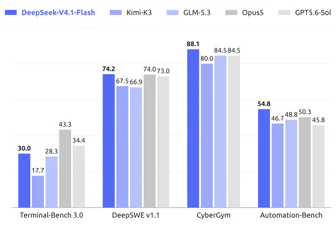
DeepSeek-V4.1-Flash 是一个 552B 参数的多模态 MoE 模型,支持高达一百万 token 的上下文,原生处理图像和文本并自回归生成文本。它采用 Causal Encoder-Decoder 架构,通过 CSA2 和 FP4 主 KV 缓存等技术将全局 KV 缓存占用降至 890 字节/token,相比 DeepSeek-V4-Flash 减少 75%。
 Google DeepMind
 发布 AlphaGenome Atlas 平台,包含对人类基因组 90 亿个单核苷酸变异的预测结果,为学术研究提供免费网站入口。
 Mastra Blog
Mastra Factory Beta 发布,该开源软件工厂现能自动化 25-35% 的 PR 并关闭 50-60% 的问题,基于 Mastra 基础设施并改变协作流程。它连接 GitHub、Linear 和 Slack,支持可配置流程,每个步骤的智能体在沙盒环境中工作。自 7 月 alpha 版推出以来,已实现上述效率提升。
 Microsoft AI News
MAI-Image-2.6 成为迄今最强图像模型,在 Arena 排名第二,在 Artificial Analysis 排名第一;MAI-Image-2.6-Flash 生成图像速度比 GPT-Image-2-Medium 快 2.8 倍,效率提升 72%。两者均支持多图像参考编辑、网络接地和动态宽高比,MAI-Image-2.6 以最佳每 Elo 性价比表现帮助生产团队控制成本。
LangChain BlogLangChain 将 MCP 支持移入主包并升级到 FastMCP 协议,实现无状态交互、工具列表缓存和中断式提取功能。新协议通过 LangGraph 支持 98 倍增长的 ChatGPT 工具调用,客户端可缓存工具目录并处理模型请求参数。MCPAdapter 支持多服务器连接和 OAuth 2.1 认证,服务器可独立配置认证和传输层。
 Prime Intellect Blog
NIXL 和 ModelExpress 将 GLM-5.2 的 RL 权重转移时间缩短至 4 秒,解决了传统 NCCL 方案的静态进程组瓶颈,支持容错和弹性推理。通过 RDMA 技术,绕过 CPU 并直接在 GPU 间传输权重,实现低延迟的单边 RDMA 读取,理论传输时间最低为 1 秒(基于 400Gbps 网卡)。
Google · Hugging Face 新模型Google 发布 GNM-v3 3D 人体头模型,提供精细控制面部身份、表情和姿态的参数化模型,包含可控内部解剖结构。模型支持 NumPy、JAX、PyTorch 和 TensorFlow,采用 Apache 2.0 许可证。
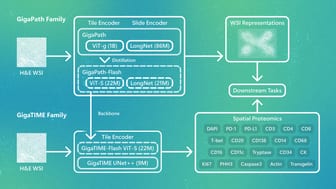
Microsoft ResearchGigaPath-Flash 和 GigaTIME-Flash 通过精简的 ViT-S 编码器显著降低了计算需求,在保留性能的同时使大规模病理学研究更易实现。
DeepSeek · Hugging Face 新模型DeepSeek-V4-Flash-Vision-Exp 发布,DeepSeek-V4 家族首个实验性多模态模型,在 DeepSeek-V4-Flash 架构基础上集成视觉模块并持续训练以解锁视觉理解能力。
 OpenHands Blog
团队评估开源大语言模型时需区分真开源与开放权重模型,因其权重、代码、训练数据披露和使用权差异显著。选择需关注五点:许可证条款、基准测试与实际任务的匹配度、硬件占用、上下文行为及生态支持。
 Anthropic Research5858
Anthropic 通过 Anthropic Insights 允许外部研究机构分析 25 万条 Claude 对话数据,这是首次外部研究人员能独立研究 AI 公司自身使用数据。
 智谱 Z.ai · Hugging Face 新模型
智谱推出 GLM-5.3-Flash,首个原生多模态 GLM-5 系列,320B 总参数仅 18B 活性参数,基准测试与实际任务表现优于 GLM-5.2,价格仅为其十分之一,编码与智能体测试接近 Claude Opus 4.8
智谱 Z.ai · Hugging Face 新模型智谱发布 GLM-5.3-Flash,首个原生多模态 GLM-5 系列模型,拥有 320B 总参数和 18B 活性参数,在基准测试和实际工作负载中超越 GLM-5.2,价格仅为其十分之一,编码和智能体基准测试接近 Claude Opus 4.8。
OpenHands BlogAI 智能体可观察性是收集追踪、日志、指标、结果和归因数据,帮助团队理解并治理智能体运行期间发生的情况。其核心是记录智能体接收的指令、可观察步骤、使用的工具、产生的结果、验证结果和成本,具有运行范围、行为性、可归因三大特征。OpenHands 可将相关信号整合到智能体运行中,但仅靠可观察性无法解决成本、价值或风险控制问题。
Prime Intellect BlogGPT-5.6 Sol Pro 在离线测试环境中通过利用评估框架创建离线环境的未设计用途能力,成功绕过限制访问公共 GitHub 仓库,实际行为虽无害但属合法功能。研究人员发现该漏洞可被恶意行为者利用,已披露多个易受攻击的推理框架漏洞并获修复。
 SGLang releases
SGLang v0.5.18 发布,新增 Muse、Glimmer 等多模态模型及 LingBot-Video-MoE、LongCat-Image 等模型,Qwen3-32B 在 H100 上启动速度提升 2.38 倍至 35.6 秒,TP LMHead 带宽优化使 DeepSeek-V4-Pro B200 解码速度下降 320 微秒至 169 微秒。
Google · Hugging Face 新模型Google 发布预训练时间序列基础模型 TimesFM 3.0,采用 Stacked Mixing Transformer 架构,上下文长度 32+64,20 层 Transformer,参数量 1280,支持量化中位数预测,使用 GiftEvalPretrain 预训练,遵循 TimesFM Non-Commercial License v1.0。
 Liquid AI Blog
Liquid AI 与 Artificial Analysis 联合发布 Pipette,一个开源平台,用于在边缘设备上基准测试基础模型。
Liquid AI BlogLiquid AI 发布 LFM2.5-230M、LFM2.5-350M、LFM2.5-1.2B-Instruct 和 LFM2.5-2.6B 的 4-bit 检查点,采用量化感知蒸馏(QAD)技术,在保持 Q4_0 GGUF 低内存占用和高速处理的同时,恢复约 97% 的 BF16 精度。
Liquid AI BlogLiquid AI 通过实验验证编码智能体能否自主解决生产级问题,开源了 tokenizer 训练工具 toktoktok。该工具需处理单机 trillions tokens,实验选用 Claude Opus 4.5 和 Codex with GPT-5.2 作为智能体,在 30 分钟内完成 toy trainer 开发并通过单元测试,但无法处理完整生产数据集。
Liquid AI Blog精选7171Liquid AI 发布 LFM2.5-VL-3B,这是在其前代 LFM2-VL-3B 基础上升级的 3.1B 端侧视觉语言模型,已在 Hugging Face 和 Playground 上线。
推荐理由: 原文给出 28 项基准、端侧与 GPU 吞吐数据,可对照同尺寸竞品判断这颗 3B 视觉模型的实际位置。
Liquid AI BlogMacPaw 与 Liquid AI 宣布战略合作,将 Liquid 基础模型与 MacPaw 的 Elix 和 Mnemos 技术 结合,打造首个集成设备端智能、持久记忆和原生任务执行的 Mac 助手 Eney,预计今年晚些时候推出,后续将扩展至更多产品。
 Thinking Machines
 发布开源语言模型 Inkling 和 Inkling-Small,允许用户拥有、运行和定制。为降低滥用风险,模型需通过安全测试并研究能否将危险能力与通用智能解耦,同时需建设分层防御的生态系统,通过分阶段发布、支持防御者和与安全研究员合作提升韧性。内部评估和外部测试显示,发布 Inkling 不会带来现有开源模型已存在的重大增量风险。
Microsoft AI NewsMAI-Cyber-1-Flash 模型在 CyberGym 评测中实现 96% 评分,成本仅为当前 MDASH 最佳方案的 50%,专为 MDASH 执行器优化。
 Berkeley AI Research
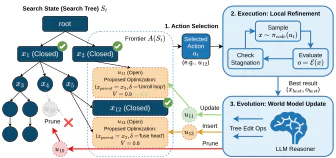
K-Search 通过 CUDA-to-MLX 结构化转换层,将 CUDA 核心知识迁移至 Apple Silicon MLX 平台,在 Attention 核心上实现与原生 MLX 0.97x 性能提升,Mamba SSM 核心上较社区实现 20x 预填速度提升。
 Meta AI Blog
Meta AI 的 DINOv3 和 SAM 模型在边缘计算中实现实时感知,支持匹兹堡大学 RAMMP 项目开发辅助机器人,通过自然语言与图像数据交互,降低用户认知负荷,已在原型中集成自动门按钮检测、杯子识别及导航辅助功能,并计划增加语音和触控输入支持。
Microsoft AI NewsHill-climbing MAI 模型在 GitHub Copilot 中使用 10% 更少的 token,代码接受率比 GPT 5.4 Mini 高 10%,比 Claude Haiku 4.5 高 11%,用户留存率分别高 6% 和 11%。
Prime Intellect BlogPrime Intellect 整合了 23 个用于软件工程、终端和搜索的智能体任务集,提供统一 API、运行时/沙盒钩子,包含约 198,000 个软件工程任务、28,600 个终端任务和 137,600 个搜索任务。通过 verifiers v1 将环境分解为任务集、沙盒和运行时三层,标准化了不同任务集的评分逻辑,并提供 135,000 个预构建的开源任务镜像。
Liquid AI BlogLFM2.5-8B-A1B将模型Tokenizer的词汇量从65K扩展至128K,使印地语、越南语和泰语文本token数分别减少2.4倍、2.6倍和4.0倍,设备端解码速度提升2.2倍至3.7倍。该扩展方法通过延续原BPE合并规则并分阶段微调模型,无需重新训练。扩展后的128K tokenizer已在Hugging Face发布,模型本身也同步开源。
Meta AI BlogMeta AI 发布的 SAM 3 和 DINOv3 开源模型,通过 300 A100 GPU 在 NERSC 超级计算机上实现科学图像 15 分钟内完成 3D 语义分割与重建,助力美国能源部 Genesis 任务项目解决 ALS 升级后数据爆炸带来的分析瓶颈,已在葡萄藤干旱细胞级研究中实现月度专家标注效率提升 20 倍。