Anthropic Research
Anthropic发布新指标observed exposure评估AI替代风险
Anthropic 引入新指标 observed exposure 量化 AI 替代风险,结合 LLM 理论能力与实际使用数据,侧重自动化工作场景;研究发现当前 AI 覆盖率仅达理论值的几分之一,高风险职业多为高学历高薪女性,自 2022 年底失业率未显著上升,但暴露职业中年轻工人招聘放缓。
Anthropic ResearchAnthropic 引入新指标 observed exposure 量化 AI 替代风险,结合 LLM 理论能力与实际使用数据,侧重自动化工作场景;研究发现当前 AI 覆盖率仅达理论值的几分之一,高风险职业多为高学历高薪女性,自 2022 年底失业率未显著上升,但暴露职业中年轻工人招聘放缓。
 Cognition Blog
SWE-1.6 在 SWE-Bench Pro 上取得 11% 的更高分数,但存在过度思考和自我验证问题,模型以 950 tok/s 的速度运行。该模型通过改进 RL 算法和扩展基础设施训练,计算量提升两个数量级,目前向小部分用户开放早期访问以收集反馈。
 Prime Intellect Blog
Prime Intellect Lab 发布,提供端到端模型训练平台,整合 Environments Hub、托管训练与托管评估,支持大规模智能体强化学习、推理和评估,无需管理 GPU 集群或算法细节。平台基于环境构建,包含任务数据集和执行器,已通过私有测试完成超 3000 次强化学习运行。
 Berkeley AI Research
伯克利 AI 研究提出基于信息驱动的成像系统设计框架,该框架通过互信息量化测量对物体的区分能力,在彩色摄影、射电天文学、无透镜成像和显微镜四个领域验证了信息估计能预测解码器性能,优化互信息的设计方案在达到端到端最优效果的同时减少内存和计算量。
Anthropic Research精选7878Anthropic 与 MATS 学者构建 SCONE-bench,包含 2020 至 2025 年间真实被攻击的 405 个智能合约,Claude Opus 4.5、Sonnet 4.5 和 GPT-5 在知识截止日期之后被攻击的合约上生成可利用脚本,模拟窃取金额合计 460 万美元。
推荐理由: Anthropic 用真实被黑合约构建基准,把智能体攻击能力换算成美元损失,并给出成本与效率的下降曲线。
Cognition BlogSWE-grep 和 SWE-grep-mini 是专为快速并行上下文检索训练的智能模型,其检索能力与前沿编码模型相当,但耗时仅为其十分之一。它们现已在 Windsurf 的新 Fast Context 子代理中提供。
 Dify Blog6565
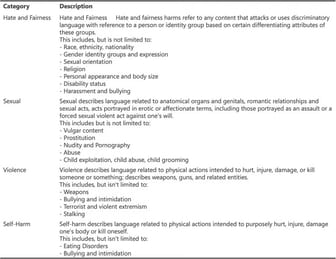
Azure AI 内容安全容器插件已在 Dify 插件市场上线,可自动检测并过滤用户输入和 AI 输出的有害内容,保障应用安全合规。该插件支持实时内容审核、多层防护(涵盖仇恨言论、暴力、色情、自残等),并允许本地容器部署以满足隐私和合规需求。最新版本 v0.0.2 提供统一审核、自定义配置、文本黑名单、组合结果输出及详细违规信息等功能。
Prime Intellect BlogINTELLECT-2 是首个通过全球分布式强化学习训练的 32B 参数模型,采用完全异步 RL 跨动态异构计算贡献者群组训练推理语言模型。开源了训练框架 PRIME-RL 及 TOPLOC、SHARDCAST 等组件,并改进 GRPO 训练配方与数据过滤技术,在数学和编码任务上提升 QwQ-32B 性能。
Prime Intellect BlogINTELLECT-1 发布,首个由全球协作训练的 10B 参数语言模型,基于 Llama-3 架构,在 5 国 3 大洲 112 个 H100 GPU 上完成 1T token 训练,PRIME 框架实现 400x 通信带宽降低,96% 计算利用率,支持 8192 序列长度、128256 词汇量,模型代码及数据已开源。
Dify Blog6565OpenAI今日发布o1系列(含o1-mini)推理模型,需API Tier 5访问,Dify已支持其集成。开发者可在Dify平台通过API Key配置OpenAI o1模型,并选择为默认推理模型,支持200消息免费试用。
Dify Blog6565Dify 推出 Conversation Variables 功能,通过临时存储关键信息提升多轮对话的 AI 交互自然度和上下文感知能力。该功能支持存储和召回关键信息,优化多步 AI 工作流,并实现细粒度记忆控制。
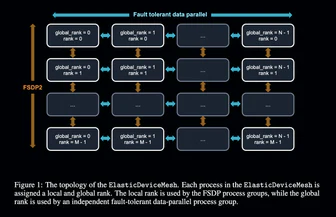
Prime Intellect BlogOpenDiLoCo 成功复现并扩展了 DeepMind 的 DiLoCo 实验至 10B 参数模型规模,通过 Hivemind 和 PyTorch FSDP 实现了跨两洲三国的分布式训练,保持 90-95% 计算资源利用率。该框架基于 Hivemind 开源实现,支持资源动态加入退出和容错训练,在 1.5B 参数模型上显著降低 500 倍通信需求的同时保持性能。
Cognition Blog7575Devin 在 SWE-bench 基准测试中成功解决 13.86% 的问题,远超此前最高 1.96% 的未辅助基线,即使提供确切文件也优于最佳前代模型(4.80%)。