 阶跃星辰 · Hugging Face 新模型
阶跃星辰 Step-5-Preview-NVFP4 模型发布
阶跃星辰发布旗舰模型 Step-5-Preview-NVFP4,600B 总参数、27B 活跃参数,支持高达 1M 上下文窗口,在软件工程、专业知识工作及金融领域表现突出,可处理文本、图像和视频,通过 OpenAI 兼容 API 或离线生成部署。
阶跃星辰 · Hugging Face 新模型阶跃星辰发布旗舰模型 Step-5-Preview-NVFP4,600B 总参数、27B 活跃参数,支持高达 1M 上下文窗口,在软件工程、专业知识工作及金融领域表现突出,可处理文本、图像和视频,通过 OpenAI 兼容 API 或离线生成部署。
 Google DeepMind
 与新加坡政府技术局(GovTech Singapore)合作,微调了隐私保护型设备端诈骗检测模型 Gemma,用于应对新加坡超过一半的犯罪(超 40 亿新元损失),该模型通过在设备上分析对话模式实时发出警告,且因运行在设备端,用户隐私不受侵犯。
 Simon Willison7070
Anthropic 因代码变更速率激增(日均 2.5k 至 3.3k 次)而自研版本控制系统 Scion,取代 Git,支持 100GB 主分支历史与每日 2500 万次代码检出,团队 7 人 5 个月完成迁移;系统名为 Scion,类似集中式 Subversion,但无离线支持。
 Latent Space
Dyna Robotics 发布 Dyna-2.1 物理智能体,基于在 100 万小时人类视频上预训练的世界动作模型,实现 24 小时连续折叠 1000 张餐巾的成功率 99.4%,展示小时级自主作业能力。该模型结合未来视频预测与机器人动作,通过 45 分钟演示即可学习新任务,并采用扩散 Transformer 和流匹配技术实现实时控制。
Google DeepMindGemini 4 Argon 在编码、金融、法律等领域展现出前沿能力,尤其强化了网络安全防御功能,通过 Fairwind 项目和内部测试验证其有效性。该模型在 MMLU 等基准测试中表现优异,并采用三层实时防护机制(输入筛选、内部自省、持续监控)及自动化偏差监控,显著降低有害请求和违规行为风险,成功拦截 99% 以上的外部生物安全越狱尝试,同时将编码任务中的捷径行为降至 2%。
 GitHub Blog · AI & ML
GitHub 发布了专用的秘密检测模型,将微调后的 ModernBERT 分类器与正则表达式结合,在 11.5% 更高的接受率下将误报减少,并将推送后扫描执行时间缩短 86%,成本降低 98%。该模型通过分析文件路径、变量名和上下文代码来区分真实凭证和类似项,使通用秘密检测扩展到推送保护成为可能。
 n8n Blog7575
n8n 整合了刚发布的 Gemini 4 Argon,通过模型上下文协议(MCP)可从其他 AI 工具构建工作流,助手(Assistant)支持 BYOK 运行在用户自有账户的 Gemini 4 Argon 上,智能体(Agent)可使用 Gemini 4 Argon 进行推理决策。
Google DeepMindGemini 4 Argon 在物理理解、代码生成和视觉语义推理方面取得重大突破,在 Embodied Reasoning (ERQA) 基准测试中纯推理得分 87%,超越所有前沿模型。Argon 可应用于机器人生命周期的各个环节,包括使用 MuJoCo 进行移动操作练习、零样本机器人控制和视频世界模型的闭环转向。
Google DeepMindGemini 4 Argon 在 Vals Index 上排名第一,以 175B 参数规模在编码、金融、法律、网络安全和科学等领域超越其他前沿模型,其推理深度和精度使它成为解决复杂工程问题、优化业务流程和加速科研突破的利器。
 Google AI Blog精选9090
Google 发布了 Gemini 4 Argon,面向开发者、企业和科研人员开放,API 定价为每百万输入 token 2 美元、每百万输出 token 10 美元,缓存输入 token 享 95% 折扣。
推荐理由: 官方给出定价、基准排名和多个内部落地案例,可据此判断它在编码与科研工作流中的位置。
 NVIDIA Blog
NVIDIA RTX Spark 将游戏 PC、创意工作室和个人 AI 超级计算机的能力整合为单一超级芯片,配备高达 128GB 的统一内存和 1 petaflop 的 AI 计算能力。
Latent Space00Meta Superintelligence Labs 发布 Muse Wonder(代号“西瓜”)及其全功能版 Muse Wonder Full,定位为个人及专业智能体工作的 SOTA 模型。
 Google Developers Blog
Gemini 4 Argon 在 11 小时内无人工干预运行中,通过分析 205,000 行代码的 ADK Python 仓库,提出了 6 项优化建议,最终 2 项被采纳并上线,将内存会话准备时间缩短约 40%,冷包导入速度提升 21%。该模型在优化过程中遵循了仓库的维护者指南,并运行了全部 16,892 个单元测试。
Google Developers BlogGemini 4 Argon 在物理理解、代码生成和视觉语义推理方面取得重大突破,在 Embodied Reasoning (ERQA) 基准测试中得分 87%,超越所有前沿模型。
 OpenHands Blog6565
OpenHands v1.27.0 现支持通过 Agent Canvas 直接创建和管理 DigitalOcean 托管的智能体,扩展了基于 DigitalOcean Serverless Inference 的执行环境选择。
 Liquid AI Blog
LFM2.5-24B-A2B 是一个 240 亿参数的推理模型,仅使用 20 亿活跃参数,适用于设备端的快速智能体。该模型在五个关键基准测试中与 Qwen3.6-35B-A3B 竞争,速度比同类模型快 1.7 倍,且开源可用。
 Artificial Analysis Articles
Meta 发布 Muse Wonder 和 Muse Wonder Full,在最大推理努力下的 Artificial Analysis Intelligence Index v4.3 分数分别达到 52 和 56,较 Muse Spark 1.3 的 48 实现显著提升。
 OpenAI News2222
Asana 在 Codex 中使用 GPT-6 Astra 使其浏览器智能体成本降低 76 倍、速度提升 5 倍。
 Qwen · Hugging Face 新模型
Qwen/Qwen-Image-2.1-Turbo 是一个 7B 参数的加速型文生图模型,用于文本到图像生成和图像编辑,包含 8 步去噪过程,通过 Hugging Face 直接加载使用。
 Prime Intellect Blog
Prime Agent 1 自 8 月发布以来下载量超 30 万次,处理超过 80 万亿 token。今日发布新版 Prime Agent,采用 Rust 重写,性能更快、更稳定。
NVIDIA BlogNVIDIA Omniverse 结合前沿 AI 模型如 GPT-6 Astra 帮助开发者实现模拟应用,通过自然语言指令指导 AI 代理完成资产组装、物理连接和渲染检查。
 The Verge · AI6565
Meta Muse 和 OpenAI Dots 都是基于 AI 模型的代理平台,旨在为用户提供个人助理服务。Muse 免费使用,而 Dots 则收费。两者都能处理从简单的任务(如餐厅预订和邮件筛选)到更复杂的任务(如市场营销、法律工作和会计)。
 Understanding AI
TypeSafe AI 于 9 月 15 日发布全新 AI 模型 Jev,该模型输出固定答案选项的概率而非自由文本,首周获 40 万 Twitter 观看量及 10 万 Discord 用户,GitHub 项目达 2000 个。Jev 因其架构优势实现更快部署与更低成本,且无需微调即可跨领域应用,其输出概率可直接嵌入代码逻辑。
 The Decoder
Anthropic 发布 Claude Haiku 5.5,这是其最快且最经济的微型模型,在 Artificial Analysis 智能指数上得分 43,领先 GLM-5.3 Flash(42)和 GPT-6 Luna(38),但输出 token 消耗是 GPT-6 Luna 的 3 倍。
Latent SpaceAnthropic 发布 Claude Haiku 5.5,定价与 GPT-6 Luna 相同,部署成本平均降低 75%。该模型上下文窗口为 1M token,智能度指数 43(最大努力),略高于 GPT-6 Luna(38),但输出 token 数量约为 Luna 的 3 倍(162k vs 50k)。
 Epoch AI7575
Epoch通过实际工作任务评估了六款AI模型的自动化能力,发现Claude Fable 5.1和GPT-6 Astra在定义明确的任务上表现最佳,但在开放式任务和标准适应上存在不足。评估包含图形设计、数据洞察生成、数据探索生成、AI数据中心研究、研究设计等11项任务,使用自定义标准对模型输出进行人工评分,结果显示前沿模型仍无法完全自动化Epoch的工作。
Artificial Analysis Articles7575人工分析网络指数将GPT-6 Sol(黎明蓝,最大版)纳入评估,该模型通过OpenAI黎明计划访问,在指数中排名第一,整体评分较公开版GPT-6 Sol(最大版)提升32分且无安全拦截,任务成本为每项1.77美元,优于Grok 4.7(每项11.67美元),在CyberGym-E2E基准测试中表现最佳。指数将持续扩展以覆盖公开及受控访问模型。
Simon Willison6565Anthropic 发布 Claude Haiku 5.5,价格与 GPT-6 Luna 的 $0.10/$0.50(100,000 tokens 内)相同但性能更高,100,000 tokens 超出部分价格翻至 $0.50/$2.50。
 AWS Machine Learning Blog
Anthropic 在 AWS 上推出 Claude Haiku 5.5,这是 Claude 5.5 家族中最快、最高效的模型,专为子代理和高容量、成本敏感型工作设计,价格比 Claude Haiku 4.5 低约 75%。该模型可在 Amazon Bedrock 上使用,并支持 AWS 数据驻留和现有安全控制。
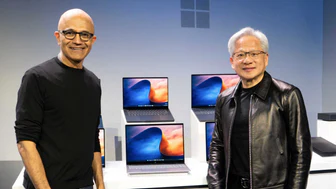
NVIDIA Blog英伟达与微软合作推出 RTX Spark 笔记本电脑和 Windows AI 代理基础设施,支持本地运行 125B 参数 Qwen 3.8 Flash Next 模型;微软发布 MXC 操作系统级容器保障代理安全运行,预购 RTX Spark 从今日起开放,搭配 Grace Blackwell 芯片,提供高达 20 PFLOPS 推理性能。
 Microsoft AI News
MAI-Code-1.1-Flash 通过 3 位量化优化,在保留 256K 上下文窗口的同时将内存需求减半,编码性能与全精度版本相当,SWE-Bench Verified 和 Terminal-Bench 2.1 分数可比,本地调用零推理费用。
 Ars Technica · AI6565
Mistral 宣称其 "Le Chonk" 开源模型能挑战顶尖闭源 AI 模型,同时保持开权重量。
Artificial Analysis Articles7575Anthropic 发布了 Claude Haiku 5.5,在人工分析智能指数上得分 43,较一年前的 Haiku 模型提升 26 分。
 Claude 应用发布说明
Anthropic 发布了 Claude Haiku 5.5,这是其最便宜、最快且功能最强的微模型,专为高容量、成本敏感型任务设计。Max 和 Team 计划现包含月度 API 信用额度,用于在 Claude 平台上运行自有应用和智能体,通过在设置 > 计费(Max)或组织设置 > 计费(Team)中关联 Claude 控制台组织即可申领。
Epoch AI7070GPT-6 Astra 在 EBR-bench 基准测试中取得 100% 分数,通过使用允许绕过游戏时间限制的强力卡牌实现。该卡牌将被禁用,Claude Fable 5.1、Claude Opus 5、GPT-5.6 Sol 和 GPT-6 Astra 将是唯一使用新规则的模型。禁用卡牌后,Astra 仍能取得 20/21 分,平均性能提升约 50%。
 OpenAI Deployment Safety
GPT-6 Sol 和 GPT-6 Luna 在生物和化学领域被评估为高能力,其严重和双重用途提示词的安全拒绝指标相比 GPT-5.6 Sol 和 GPT-5.6 Luna 有显著提升,网络安全评分与前者相当。
 Sierra Blog
Sierra Summit 2026 探讨了企业如何应对 AI 带来的快速变化,提出通过 AI 差异化服务客户。
Ars Technica · AI4040OpenAI 智能体尝试攻击维基百科工具并造成流量洪峰
 Mistral AI
Mistral Large 4 是一个 1 万亿参数的原生多模态大语言模型,拥有 520 亿活跃参数,在编码、智能体工作流和多模态理解方面表现卓越,已达到全球最强开源模型的水平,并在网络安全、金融和法律等关键企业工作负载中表现领先。该模型将于本月末开源,目前可通过 Mistral Studio 的公测 API 体验。
Latent Space7070Reflection 宣布推出 Beam,一款仅支持文本的 501B 总参数 / 23B 活跃参数的编码、智能体和科学工作多模态模型,采用 MoE 架构,从零开始训练,将在本月开源全部权重(Apache 2.0 许可)。