IT之家 · AI6565
技嘉上线工作站主板 WRX90 AI TOP:7 条 PCIe + 2 个 MCIO,集成 BMC
技嘉推出 WRX90 AI TOP 工作站主板,搭载 Socket sTR5 插槽和 E-ATX 板型,配备 8 通道 DDR5 RDIMM 插槽支持 2TB 内存,含 6 条 PCIe Gen5 ×16、1 条 PCIe Gen5 ×8 插槽及 2 个 MCIO 8i。主板集成 ASPEED AST2600 BMC SoC,支持 IPMI 远程管理。
IT之家 · AI6565技嘉推出 WRX90 AI TOP 工作站主板,搭载 Socket sTR5 插槽和 E-ATX 板型,配备 8 通道 DDR5 RDIMM 插槽支持 2TB 内存,含 6 条 PCIe Gen5 ×16、1 条 PCIe Gen5 ×8 插槽及 2 个 MCIO 8i。主板集成 ASPEED AST2600 BMC SoC,支持 IPMI 远程管理。
IT之家 · AI5252KRAFTON AI公布Raon-1 mini预览版模型,采用混合专家架构与线性注意力,参数规模30B-A4B,支持推测解码,韩语与英语性能兼顾,Apache 2.0开源,API限时免费试用。预览版在编程与智能体任务上与Meta Muse Glimmer 30B相当,速度更快、内存效率更高。
 Interconnects同一件事 · 2 家6565
Kimi K3.1 Pro 发布后引发争议,其基准测试在 Artificial Analysis 上超越 GPT-6 Astra,但在 Terminal-Bench Science 和 ProgramBench 上表现稍逊。模型发布伴随着疑似付费推广,且预训练效果被指未达预期。
各家口径不同:Artificial Analysis 提供了 55 分的评分并排名第四;MarkTechPost 提到了 2.8T 的总参数和 104B 激活参数的 MoE 模型。
 The Decoder精选7878
Nvidia 开源数据引擎 Flora,用于机器人视频标注,称标注一小时视频约 0.72 美元,而 GPT-6 Astra 约 88.50 美元。Flora 由三个微调的 Qwen3.5 模型组成,分别负责动作分段、带上下文的描述和奖励打分,覆盖动作描述、分步评分与任务成败判断三类标签。
推荐理由: 原文给出了 Flora 的三类标注能力、成本估算和与 GPT-6 Astra 的逐项对比,读者可据此判断机器人视频标注的开源替代方案边界。
IT之家 · AI3838国际星闪联盟与中国信息通信研究院等机构共同发布星闪 3.0 标准成果,面向全场景智能物联并瞄准 AI、无源、毫米波方向创新。星闪 SLE3.0 将在速率、覆盖、抗干扰等方面升级,已正式发布无损音频等三项标准,另有大量标准正在制定中。该系列标准将于 2027 年 4 月 1 日起正式实施。
The Decoder精选7272南京大学与商汤等机构的研究者发布 OpenMobile-2,基于 Qwen3.5 的 9B 和 Qwen3.6 的 27B 两个智能体模型,并公开训练环境、数据和复现说明。
推荐理由: 研究将训练数据量固定、只增加应用数量,观察到未见应用成功率提升,为手机智能体的数据构建提供了可复现路径。
 36氪 · AI5858
千里科技发布集成10 TOPS算力NPU的AI毫米波雷达,首次实现雷达内部目标检测与分类,支持边缘侧、卫星与兼容三种工作模式。该雷达通过在感知链路前端引入数据驱动模型,突破传统架构的规则上限,缩短反应时间并提升安全性。千里科技通过收购融感科技打通软硬一体业务闭环,实现自研算法与硬件的联合优化。
 MarkTechPost精选8080
Microsoft Research 开源了 Agensh,一个去掉中心编排器的多智能体框架,每个 worker 自行认领子任务、共享发现并合并代码到同一个 Git 仓库。
推荐理由: 原文给出无中心编排器的多智能体框架在 ProgramBench 上从 1 到 1024 个智能体的扩展数据,可对照现有编排式方案。
 Ollama Blog精选6262
Ollama新增文本转语音能力,首个接入的语音模型是Gradium的小型TTS模型家族Phonon,目前支持macOS、Windows和Linux,支持即将推出。
推荐理由: 原文给出Ollama接入语音模型后的吞吐对比、准确率与OpenAI兼容接口,可据此判断本地TTS的落地方式。
MarkTechPost3434Underdog Saluki 27B 是一个 7.9 GB 的 Qwen3.8-27B 构建版本,其开发者称其在约每权重两比特的情况下保持了工具调用功能,并在其 120 任务基准测试中超越了完整的 54 GB 模型。
MarkTechPost6060Cognition 发布了免费的、开源的 Devin Vulnerability Fixes 插件,包含三个技能用于修复 PHP2Shell、Node.js 和 GitLab CVE-2026-110264 三个关键远程代码执行 (RCE) 漏洞。
 蚂蚁 inclusionAI · Hugging Face 新模型5858
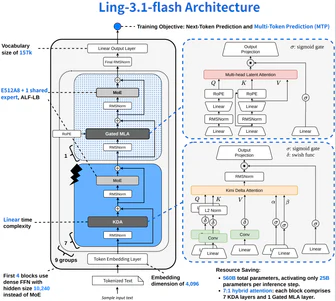
inclusionAI/Ling-3.1-flash-base 发布,560B 总参数、25B 活跃参数的稀疏 MoE 架构大模型,采用混合线性注意力机制(63 KDA + 9 Gated MLA),在 47 个跨八个领域的基准测试中表现优异,支持持续预训练、领域适应和后训练研究,模型使用 FP8 精度训练,BF16 精度发布,遵循 MIT 许可证。
 Gemini CLI releases00
Gemini CLI v0.67.0-nightly.20261025.gcd1b45c2d 发布,该版本为预发布版本。
IT之家 · AI精选7575GitHub 用户 Zagitta 开发的开源项目 GPU Unlock 可解除安培架构消费级显卡在 FP16/BF16 张量核心运算中的指令发射速率限制,无需修改驱动或刷写 VBIOS。
推荐理由: 原文给出多张 RTX 30 显卡在 GEMM 与图像生成负载下的实测提升数据,也标明了显存带宽等限制。
 TechCrunch · AI同一件事 · 2 家
Block 公司发布 Dessa 语音模型,该模型完全基于人类语音训练,能在消费级 GPU 上本地运行,支持同时说话和聆听,通过真实对话数据获取知识,表达包含笑声、停顿和哭泣等人类情感,目前无法公开访问,公司正在招募安全研究员测试。
各家口径不同:The Verge 提及模型对话偶有'生硬和诡异'表现;The Decoder 和 TechCrunch 没有提到这一点。
MarkTechPost6868Anthropic 开源 sandbox-runtime (srt) 限制进程文件和网络访问,无需容器;支持 macOS/Linux (Windows alpha),CLI/TS 库形式,Apache-2.0 许可,Node.js 22.12+, Anthropic 内部测试使 Claude Code 权限提示减少 84%。
 Latent Space同一件事 · 2 家6767
Kimi K3.1 Pro 是一个 2.8 万亿参数的开源权重模型,其 1040 亿活跃参数和 100 万 token 上下文窗口在多个基准测试中超越 Fable 5.1,包括独立编码、Blender/CAD 工作、金融建模和长期智能体任务。标准版和 2-3 倍速度提升的高速版已上线,后者价格翻倍,同时推出 Kimi Hosted Agents 管理平台。
各家口径不同:Artificial Analysis 提供了 55 分的评分并排名第四;MarkTechPost 提到了 2.8T 的总参数和 104B 激活参数的 MoE 模型。
 腾讯混元 · Hugging Face 新模型精选同一件事 · 2 家7171
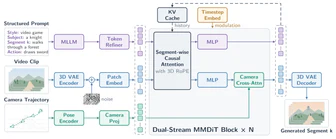
腾讯混元在 Hugging Face 发布 Hy-Nomas 的 BF16 Diffusers 格式蒸馏权重,该视频世界生成模型支持通过文本指令和相机控制进行多轮自由交互,逐段生成同一世界。
推荐理由: 官方放出蒸馏版 BF16 Diffusers 权重和配套基准,读者可据此判断多轮交互式世界生成的实际用法与门槛。
36氪 · AI5252中国移动发布首个汽车行业AI基座,面向全行业开放共享“算力—数据—模型”三大能力,覆盖研发、制造、智驾、测评四大领域,打造六大智能体,相关成果已在10余家央国车企落地应用。
MarkTechPost6565NVIDIA 发布 Nemotron 3.5 Bolt E4B 4GB,一款开源小型语言模型,专为本地快速对话代理设计,支持语音助手、游戏NPC和机器人接口。该模型基于 Google Gemma 4 E4B 通过强化学习仅进行后训练,总参数 8B,有效参数 4B,上下文窗口 64K。
Gemini CLI releases1515Gemini CLI v0.67.0-nightly.20261024.gcd1b45c2d 发布,修复了 CLI 请求取消后的续处理和自动调整问题、泰语和老挝 SARA 字母显示宽度问题,以及相对文件路径解析问题,并新增了模型命令和 --list-models 标志用于模型发现。
 Claude Code releases5252
Claude Code v2.1.310 发布,新增 Bedrock、Vertex 和 Foundry 平台的 Monitor 工具及插件,修复了多种请求失败、文件清理、会话压缩及权限提示问题,并改进了非交互式会话的内存使用。
 Ollama releases1010
Ollama v0.40.11-rc0 发布,通过 @jmorganca 的 #19242 PR 新增 Phonon 语音目录功能;@hoyyeva 的 #19228 PR 优化 qwen3coder 保留函数闭合标签;@SynapShift 的 #19173 PR 允许 vllm-d3 空状态。
 LangChain Deep Agents releases1515
LangChain Deep Agents 0.7.32 发布,通过避免在 SDK 导入时加载 `langchain_anthropic` 和 `langchain_openai` 模块提升性能。此次更新优化了 SDK 导入速度,具体优化细节已记录在 Git 日志中。
LangChain Deep Agents releases00LangChain Daytona v0.0.9 发布,修复了请求超时后保留部分输出的 Bug。通过应用请求超时机制,确保在超时发生时仍能获取部分结果。此次更新由社区贡献者支持,提升了组件的稳定性。
 IBM Research Blog
所有九个获奖团队在 NEDO 量子挑战赛的研究中都使用了 IBM 量子计算机,涵盖社会 5.0、生活质量(QoL)和酷日本三个赛道,应用包括灾害预防、药物发现、肠道菌群分析等。IBM 为参与者提供量子计算资源、技术指导、研讨会和教育内容支持,其中 65 支团队(约 81%)选择 IBM Quantum 平台,运行 11,159 个任务并使用超过 5,900 分钟量子计算时间。
 O'Reilly Radar
Mozilla CTO Raffi Krikorian 指出开源 AI 对建立用户可信赖的 AI 生态至关重要,需要构建包含记忆、工具调用、运行环境和规则的标准协议,目前开源模型性能接近前沿但部署困难,约三分之一的实际应用已使用开源模型。
 NVIDIA Technical Blog3535
NVIDIA 在 TensorRT 11.1 中推出的全局性能调优器(GPT)可自动进行精度感知的端到端性能调优,通过为不同模型定制优化方案扩展了单次构建优化能力。GPT 支持在 TensorRT 内部自动调整不同优化策略。
LangChain Deep Agents releases3535deepagents-code 0.2.1 发布,默认 Anthropic 自动分类器设置为 Claude Sonnet 5.5,新增技能范围 MCP 工具支持。
LangChain Deep Agents releases1515LangChain Deep Agents 0.7.31 发布,修复了默认从用户回复中省略异步任务 ID、在 SDK 中间件覆盖中保留文件系统权限等 Bug,并新增了在跟踪中暴露执行输出保留元数据的功能。
 AWS Machine Learning Blog3434
拜耳作物科学在 Amazon Bedrock AgentCore 上构建了智能决策引擎(ADE),通过多智能体和自然语言界面解决用户问题,首阶段解决约 80% 的用户问题无需工程师介入。
 Hugging Face Blog
LitPivot帮助研究人员通过阅读先前文献来调整研究方向,将研究想法分为问题、贡献和评估计划,并为每个部分提供基于文献的批评和修订建议。在涉及17名研究人员的实验室研究中,领域专家评价新颖想法的文献基础比使用文本编辑器和AI聊天工具开发的想法更好,参与者也报告了更强的文献理解和对想法新颖性和实用性的提升。
 Codex releases1010
GitHub Copilot rust-v0.165.0-alpha.1 发布,版本号为 0.165.0-alpha.1。
Hugging Face BlogHugging Face 发布 torch-neuronx 模型支持查询 Space,检测 AWS Trainium 兼容性。该 Space 支持查询 Hugging Face Hub 上 175B 参数规模的主流模型(如 Qwen3-0.6B)是否能在 Trainium 上无修改运行,并提供运行脚本。
 Hugging Face Daily Papers6565
LayerEditor 融合指令引导图像编辑与可重用 RGBA 层生成,通过联合 token 建模和编辑先验蒸馏实现精确局部操作和层重用。
Hugging Face Daily PapersWeVisOne-VL 通过结构化 token 预测统一对象级和像素级视觉感知,支持检测、定位、计数、OCR、分割和 matting 等任务,采用轻量级像素解码器和多阶段训练,在 30 项以上基准测试中表现领先,并保持对不存在对象的稳健拒绝。
Hugging Face Daily PapersIQuest-Q1 是一个拥有 320B 总参数(15B 激活参数)的开源稀疏专家混合(MoE)智能体基础模型,通过多阶段预训练、中训练和后训练实现强大的编码和通用能力。
腾讯混元 · Hugging Face 新模型腾讯混元发布 WeVisOne-VL-2B 模型,基于 Qwen3-VL 构建,集成 9.5M 参数像素解码器,支持目标级感知(开放词汇目标检测、指向定位、计数、指向和 OCR)与像素级感知(指向分割和可提示 alpha 摩擦),适用于视觉定位、指向、计数、OCR 定位、指向分割和图像摩擦等研究任务。
腾讯混元 · Hugging Face 新模型腾讯混元发布 WeVisOne-VL-4B 模型,基于 Qwen3-VL 构建,集成 9.6M 参数像素解码器,支持目标级感知(开放词汇目标检测、指向定位、计数、指向和 OCR)与像素级感知(指向分割和可提示 alpha 摩擦),适用于视觉定位、指向、计数、OCR 定位、指向分割和图像摩擦等研究任务。
Hugging Face Daily Papers6565Code2Video-Compass 基准包含 2,104 个任务,覆盖文本、图像和视频输入的代码视频生成,评估 15 个 MLLM 在 T2V、I2V 和 V2V 场景下的表现,发现顶尖模型在复杂动态和状态依赖任务中生成高质量视频仍面临挑战。