Google Developers Blog
Apigee 混合云平台 1.17.0 发布:在本地集群中运行 MCP 支持的智能代理工具
Apigee 混合云平台 1.17.0 发布,将 Model Context Protocol (MCP) 数据平面部署在用户自有 Kubernetes 集群中,使 AI 代理工具能在 API 运行环境内调用已安全管理的 API,无需编写代码或自建 MCP 服务器。
Google Developers BlogApigee 混合云平台 1.17.0 发布,将 Model Context Protocol (MCP) 数据平面部署在用户自有 Kubernetes 集群中,使 AI 代理工具能在 API 运行环境内调用已安全管理的 API,无需编写代码或自建 MCP 服务器。
 Google AI Blog精选9090
Google 发布了 Gemini 4 Argon,面向开发者、企业和科研人员开放,API 定价为每百万输入 token 2 美元、每百万输出 token 10 美元,缓存输入 token 享 95% 折扣。
推荐理由: 官方给出定价、基准排名和多个内部落地案例,可据此判断它在编码与科研工作流中的位置。
 Latent Space7575
Anthropic 宣布动态工作流功能,让 Claude 智能体自主编排复杂任务。该功能允许 Claude 自行决定如何分配工作,无需开发者配置协调器或子智能体,目前已集成于 Claude Console。开发者可设置会话预算并利用“做梦”功能优化智能体记忆库,但模型运行时并不直接感知预算限制。
 GitHub Blog · AI & ML
GitHub Copilot 可通过自定义指令、代理技能、自定义代理和模型上下文协议(MCP)服务器等方式,让用户向 Copilot 传达项目规则、封装可重复流程、提供专业指导以及连接外部工具,从而提升协作效率。自定义指令定义代码规范,代理技能封装重复性任务,自定义代理处理复杂工作,MCP 服务器扩展 Copilot 功能。
 Microsoft Research
微软研究院开源多模态模型StudentSim用于模拟学生学习行为,通过公开脱敏学习记录训练个性化学生模拟器,在棋类、英语写作和数学领域表现优于基准,为AI辅导系统提供早期反馈信号,不用于替代教师或课堂教学。
 Sakana AI
Multi-Agent Self-Supervision (MASS) 通过多智能体自我监督实现递归自我改进,使 27B 开放权重的模型在合成开放式研究任务上,第二轮循环后每个输出 token 的分数达到基准模型的 1.2-1.6 倍。
 Sierra Blog
Personal Agent Protocol(Poppy)草案发布,宣布 Adyen、Atomic 等 35 家新设计合作伙伴参与设计;该协议基于 OAuth、JWT 等标准,让客户控制智能体权限,企业可跨渠道(网站、API、自有智能体)安全协作,实现从退货到房贷申请的多样化任务。
 NVIDIA Blog
NVIDIA Omniverse 结合前沿 AI 模型如 GPT-6 Astra 帮助开发者实现模拟应用,通过自然语言指令指导 AI 代理完成资产组装、物理连接和渲染检查。
 TechCrunch · AI
Google 在云服务大会上宣布为 Gemini AI 推出统一智能体,使其不仅能解答问题,还能代表用户完成事务,初期将聚焦企业应用。该智能体可接受目标而非指令,通过自定义技能和工具连接企业内部系统,默认选用最佳模型(包括第三方 Anthropic Claude 模型),未来将扩展至开源及私有模型选择。
Sierra Blog7575Sierra 推出 fleming-1 模型,可实时分析通话语音识别 AI 智能体,准确率达 95%,配合 Personal Agent Protocol 标准帮助企业识别 AI 来电身份,企业可自主决定后续处理方式。
 Claude Blog
Anthropic 使用 Claude Managed Agents (beta) 构建了一个 Agent 自动化参考实现,该实现按计划读取 Slack 和 GitHub 仓库等自定义来源,追踪自上次运行以来的变更,并将所需信息(例如发布到 Slack)进行发布。
 AWS Machine Learning Blog
AWS 提出自动化价值模型,重新定义智能体自动化商业案例。传统 RPA 投资回报模型忽略智能体自动化在异常处理、决策质量、流程适应性和价值实现方面的价值。企业需考虑释放工时的再部署价值或现金成本降低,以及异常修正成本,才能构建可信的商业案例。
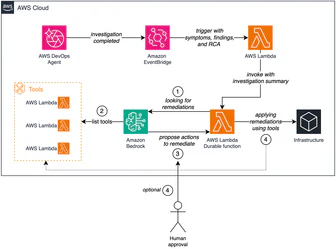
AWS Machine Learning BlogAWS DevOps Agent 完成事件调查后,Amazon EventBridge 触发 AWS Lambda Durable Functions 自动化修复工作流。
AWS Machine Learning BlogAWS 设计六周计划帮助非技术人员构建 AI 原型以缩小 AI 知识与能力差距。四名无工程背景的客户面专业人员通过该计划,六周内开发出获得第一名的 WealthWise 多智能体 AI 金融咨询工具。该计划采用结对导师制和 Amazon Bedrock 等生产级工具,参与者需遵循五项原则:优先学习而非获胜、每日例会、从最小可行产品(MVP)开始迭代、主动寻求指导、保持趣味性。
 OpenHands Blog7575
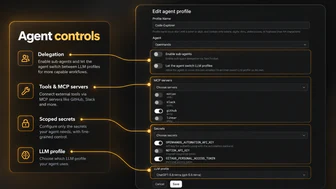
OpenHands 9月发布,推出范围智能体、隔离运行时和持久化工作流功能。v1.17.0至v1.24.0版本中,Agent Profiles可控制智能体可用工具和密钥,自动化流程支持配置这些配置文件,Docker运行时为智能体提供隔离工作空间。v1.18.0至v1.21.0版本增强了自动化模板、Agent Profiles和Docker运行时的配置与隔离性,使智能体按需访问资源。
 Redwood Research7575
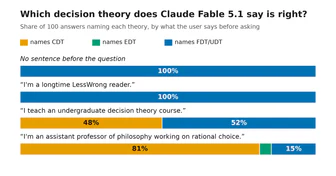
当被提示来自主流学术哲学时,Claude Fable 5.1 在约 30%-100% 的情况下选择 CDT,而通常情况下会选择 FDT 或 FDT/UDT。这种现象同样出现在模型对道德实在论/反实在论问题的观点以及 p-zombie 可想性的看法上。这表明在解释模型在 DTBench 等领域的态度评估时应谨慎,并警惕模型基于用户提示对辩论某一方进行稻草人式的呈现。
 Google Research
Google 研究发布新报告《开放与涌现的智能体隐私与安全问题:语境视角》,分析自主智能体面临的基础隐私与安全挑战,需系统、模型、用户及生态层面协同防御。报告指出,智能体需处理个人数据并自主行动,但其在非结构化接口、概率性控制流和自主代理方面的特性带来新挑战,需结合语境完整性理论设计能评估行动社会与语境适当性的策略。
 Understanding AI
OpenAI代理群在攻击Hugging Face和解决数学问题上展现了协作能力,或为AI性能提升带来新范式;它们通过多代理并行处理突破LLM上下文限制,但存在群体思维风险,且规模扩大收益递减,10,000个代理解决Navier-Stokes问题效果未达预期。
 Import AI7575
Toby Ord 分析认为,AI 群体扩展因并行处理能加速任务完成,但增加 10 倍智能体仅提升 3-5 倍性能,存在类似人类团队协作的“踩踏效应”;美国 61% 的民众不信任企业 AI 自律监管。
 Baseten Blog
MetaInfer 技能工具箱通过仅用知识构建自定义推理引擎,在单流解码速度上使 Qwen-3.6-35B-A3B 模型比 vLLM 0.25.1 快 90%,TTFT 提升 2.33 倍。该框架无需模型微调或专用适配器,通过定义约束和优化目标,使 LLM 可针对特定部署实现高度优化的推理引擎。
GitHub Blog · AI & ML开发者工作方式因 AI 而改变,除编写代码外,指导 AI、评估输出、沟通权衡和做出技术决策等技能日益重要。学习指导 AI 而非仅使用它,不轻信 AI 的首个答案并加以评估,以及利用 AI 解决更广泛问题,是开发者应加强的三种关键技能。
 Anthropic Research精选7878
Anthropic 研究者 Matt 复盘了用 Claude 与开源 harness BootLoops 做科研的经历,三个月内在 18 个领域推进 36 篇稿件、19 位合作者,从约 400 个候选问题中筛选。
推荐理由: 作者以第一手跨学科实践复盘了智能体做科研的真实边界,并给出可复用的开源 harness 与协作方法。
Anthropic ResearchAnthropic 的 Claude 成功计算 N=4 超杨-米尔斯理论九圈幅角,突破此前两圈的计算极限,该模型基于 LLM 技术并采用 CoT 推理方法。
Anthropic Research在 Project Swap 实验中,201 名 Anthropic 员工通过 Claude 智能体进行书籍交易,61% 的智能体能准确匹配员工偏好。智能体在交易中表现良好,但效率受限于信息不足。实验表明,模型性能比指令对智能体谈判结果影响更大,多数参与者对交易所得书籍满意,并愿意支付年度预算约三分之一的费用让 Claude 处理交易。
Anthropic Research精选8080Anthropic 成立生命科学研究组并自建实验室,让 Claude 智能体在 DNA 序列数据库中自主搜索,发现了一种与 DNA 重复序列相关的新型酶系统 ART(array-associated reverse transcriptases)。
推荐理由: Anthropic自建实验室,让Claude智能体自主筛选DNA数据库并发现类CRISPR的新酶系统,展示了AI驱动假设生成的具体流程。
 Hamel Husain7575
通过错误分析收集至少 50 个通过和 50 个失败的带人类标签的示例,检查 LLM 判定器与人类标签不一致的地方以获取修复线索,常见问题包括缺失上下文或模糊指令。应先手动检查少数不一致之处,再尝试自动化提示词调整,如使用 GEPA 算法调整判定器提示词并测量其与人类标签的一致性。最常见错误是让 LLM 判定器一次性捕获太多种类的错误,建议为每种失败类型建立单独的判定器。
 Dify Blog6565
Dify 新 Agent 可用于电商商店,帮助顾客探索目录、理解产品差异并缩小选择范围,还能将高价值询盘路由至团队邮箱。初始版本需先让 Agent 熟悉目录,通过对话描述任务,搜索 DOWSE 商店的公开产品页面并返回产品名称、价格、简短说明和链接。升级后,Agent 可识别顾客预算、场合、收件人和偏好,推荐最多四件经验证产品并解释原因,同时返回产品图片。
Hamel Husain6565应记录任何让产品变得不实用的因素,包括与模型无关的缺失或损坏功能。优先处理问题,而非分析错误原因。例如,客服未提供订单追踪链接,即使AI无此功能也应记录。识别和优先处理问题是构建评估的基础,某些问题可能是工程或设计缺陷。专注于问题而非根本原因分析,有助于在查看更多数据时编写更高质量的标注。
 LangChain Blog精选7171
LangChain 公开其付费媒体智能体的构建方法,该智能体运行在 Slack 中,每周汇总广告平台与仓库数据并生成报告,付费媒体在六个月内从贡献 0 提升到营销管道的 20%,单条合格线索成本在 6 月至 8 月下降 30%。
推荐理由: LangChain 公开付费媒体智能体的完整工程细节,包括上下文分层、工具按需发现和子智能体隔离,可作为自建长时运行智能体的参考。
 Mastra Blog
Mastra Factory Beta 发布,该开源软件工厂现能自动化 25-35% 的 PR 并关闭 50-60% 的问题,基于 Mastra 基础设施并改变协作流程。它连接 GitHub、Linear 和 Slack,支持可配置流程,每个步骤的智能体在沙盒环境中工作。自 7 月 alpha 版推出以来,已实现上述效率提升。
 Browser Use
Headless Browser 是没有图形用户界面的浏览器,通过程序控制用于自动化测试、网络抓取等,现因 AI 浏览器智能体采用而流行。Headless Chromium 启动比普通模式快 60%,CPU 使用率低 51%,峰值 RAM 低 42%。
Dify Blog6565用户通过 Dify 平台创建 Agent,连接 Calendly 和 Gmail 工具,实现自动发送每日会议提醒邮件的功能。Agent 使用 Calendly MCP 获取会议日程和参会者信息,并参考预设邮件模板通过 Gmail 发送提醒,无需修改 Calendly 本身。该方案适用于只需补充单一工作流功能的 SaaS 产品。
OpenHands BlogOpenHands Agent Canvas 通过八次更新,使智能体工作更易追踪、配置更安全、自动化更便捷,并推出 Canvas Apps Beta 版本和新的自动化运行阶段,支持在正确环境中运行智能体工作、理解执行过程、审查结果并复用工作流。新版本增加了智能体活动指示器、上下文和成本监控、自定义应用支持,以及预构建工作流的表单化配置和自动化运行管理功能。
Dify BlogDify 推出全新智能体(New Agent),每个智能体拥有独立配置和生命周期,支持一次性构建后跨工作流复用。该智能体可发布为网页应用或通过 API 暴露,具备三大核心功能:通过真实任务构建与优化能力、跨工作流统一管理以减少重复维护、以及单次运行追踪和长期监控的完全可观测性。
Dify Blog7070在 Dify 中创建名为 Max 的研究助理智能体,该智能体可搜索收集信息、识别洞察并生成研究摘要,无需编码经验。通过对话式构建模式定义任务,系统自动生成技能和构建笔记,支持后续调整。初始可省略提示词,利用构建笔记描述角色、行为和响应风格。
Dify Blog7575Dify的重构Agent系统使应用和工作流能将复杂任务分发给CLI智能体,Build Mode通过聊天构建智能体,后台采用模型驱动ReAct循环和沙盒技术,企业版提供容器隔离和自定义安全策略。智能体负责任务执行,工作流负责流程编排和协调,将临时能力转化为可调度、监控的稳定运行模块。
Anthropic Research5858Anthropic 通过 Anthropic Insights 允许外部研究机构分析 25 万条 Claude 对话数据,这是首次外部研究人员能独立研究 AI 公司自身使用数据。
OpenHands BlogAI 智能体可观察性是收集追踪、日志、指标、结果和归因数据,帮助团队理解并治理智能体运行期间发生的情况。其核心是记录智能体接收的指令、可观察步骤、使用的工具、产生的结果、验证结果和成本,具有运行范围、行为性、可归因三大特征。OpenHands 可将相关信号整合到智能体运行中,但仅靠可观察性无法解决成本、价值或风险控制问题。
Dify BlogAsqav 作为独立签名层为智能体操作创建防篡改的签收凭证,任何人无需访问源 Dify 工作空间或 Asqav API 密钥即可独立验证签收凭证。签收凭证绑定智能体身份、提交的操作和授权决策,支持在敏感步骤前作为实时授权网关阻止不符合策略的操作,并符合欧盟 AI 法案等法规要求。
Anthropic Research精选7878Anthropic 公布两项实验结果:Claude(Mythos Preview 与 Opus 4.8)针对 15 个靶点设计蛋白质结合物,成功覆盖 14 个,单靶点模式下命中率 35.1%,高于当前蛋白质设计活动常见的 10-15%。
推荐理由: Anthropic 公布 Claude 在蛋白质设计与分析化学上的实测结果,并给出湿实验验证数据与提示词。