Google Developers Blog
Google AI Edge Gallery 推出设备端语音识别与文本转语音功能
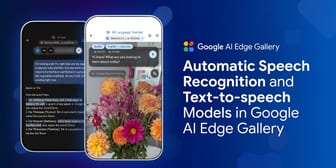
Google AI Edge Gallery 今日推出设备端自动语音识别(ASR)与文本转语音(TTS)功能,可在手机和可穿戴设备上完全离线运行多语言 ASR 和自然 TTS 模型。
Google Developers BlogGoogle AI Edge Gallery 今日推出设备端自动语音识别(ASR)与文本转语音(TTS)功能,可在手机和可穿戴设备上完全离线运行多语言 ASR 和自然 TTS 模型。
 PyTorch Blog
ExecuTorch WebGPU 后端使 PyTorch 模型无需转换框架格式即可在 WebGPU 浏览器中运行,支持 Llama 3.2、Qwen3、Gemma 3 等多种模型。
 Berkeley AI Research2222
BAIR团队在2026年11月9日至12日于德克萨斯州奥斯汀举行的机器人学习会议(CoRL)上展示多项研究成果,包括33篇主会论文、4个突破性海报、10场口头报告和7场专题演讲,其中教授Negar Mehr将发表早期职业主题演讲。会议涵盖机器人视觉语言行动模型、具身智能体、细粒度操作对齐、后见之明奖励编辑等议题。
 Google Research精选7272
Google Research 在 Nature 发表多模态 AI 系统 AI-PPG-ACC-HTN,无需袖带校准,仅用消费级智能手表的 PPG 与加速度计数据被动识别高血压状态。
推荐理由: 研究用智能手表 PPG 与加速度计数据被动识别高血压,并以 24 小时动态血压监测为金标准给出筛查与确认两阶段的量化结果。
 IBM Research Blog3838
HRL 实验室开发出采用先进算法的惯性测量单元(IMU),提供不间断的 GPS 替代方案。其 MEMS 惯性传感器尺寸如汤罐,精度接近 GPS,并解决长期困扰的偏差漂移问题,通过 AutoCal 自动校准系统持续修正误差,实现无限导航支持。该 IMU 采用 ASIC 和先进封装技术优化成本与尺寸,适用于无人机等轻型载体。
 Hugging Face Blog精选7272
Phonon 发布可在本地设备运行的小型 TTS 模型,无需服务器和网络,提供约 65 MB 和 75 MB 两个版本,覆盖英语、法语、德语、西班牙语和葡萄牙语。
推荐理由: 原文交代了端侧 TTS 的模型规格、开源许可与榜单表现,可据此判断小模型在本地语音场景的可用边界。
 AWS Machine Learning Blog2828
Amazon Bedrock 现在支持在印度境内对 Kimi K3 进行推理,满足严格的数据本地化需求。客户 Ultrahuman 通过 API 调用该服务,使 AI 健康助手能处理每日超 14,000 次对话,同时将健康数据保留在 AWS 内部,成本降低 80%,多轮对话速度提升 85%。
Hugging Face Blog精选7676Liquid AI 发布 LFM3 新一代 Liquid Foundation Models,以 LFM3-1.7B-Base 为共享骨干派生六个 2B 级模型,覆盖文本、视觉、音频、全模态和决策,全部在 Hugging Face 开放权重。
推荐理由: Liquid AI 用同一 2B 级骨干派生六个模态模型,并给出单卡微调与端侧部署路径,可据此判断小模型专用化路线。
 LangChain Deep Agents releases
LangChain Deep Agents 的 deepagents-code==0.2.2 版本发布,包含安全与性能改进。新增 GPT-6.1 Terra 支持、选中文本输入至聊天、插件更新检测等功能;修复项目 .env 文件设置信任值、终端 UI 链接限制、Git 选项限制等 Bug;通过重用父进程上下文、优化服务器启动流程、精简转录渲染等提升性能,推荐尽快升级。
AWS Machine Learning Blog5252AWS 推出在 AWS Trainium 上用 torchtitan 训练 Qwen3 的三种方法,包括使用 Transformers v5、torchtitan 原生配置以及 Neuron Kernel Interface (NKI) mixture-of-experts (MoE) 内核。
Hugging Face BlogHugging Face 介绍了如何使用 TorchNeuron 在 AWS Trainium 上进行系统级推理性能分析,通过 torch.profiler 配置 Neuron 后端捕获干净 traces,并利用 key_averages() 表识别耗时操作。
Google Developers BlogGoogle发布原生PyTorch后端的vLLM和SGLang推理引擎,支持TPU并优化生产级服务;vLLM-TorchTPU在SemiAnalysis InferenceX基准测试中实现175B参数模型每百万token成本2.01美分,行业领先。
Google Developers BlogCoral NPU 发布了完整的 32 位架构,包含新的矩阵执行单元,支持高达 1 TOPS 性能和 10mW 平均功耗;推出基于 IREE/MLIR 的 Coral Compiler v1.0。
Google Developers BlogLiteRT Tensor API 发布,支持开发者以 C++ 在边缘设备原生编写和优化模型,实现跨平台(CPU/GPU/NPU)部署,无需转换脚本。开发者可完全控制计算图结构并直接加载模型权重,通过共享加速器缓冲区实现零拷贝数据流转,同时为 AI 编码智能体提供构建模块。
 Google DeepMind
Gemini 4 Argon 在物理理解、代码生成和视觉语义推理方面取得重大突破,在 Embodied Reasoning (ERQA) 基准测试中纯推理得分 87%,超越所有前沿模型。Argon 可应用于机器人生命周期的各个环节,包括使用 MuJoCo 进行移动操作练习、零样本机器人控制和视频世界模型的闭环转向。
 Amazon Science
亚马逊科学提出 Priming 技术,通过利用预训练 Transformer 权重将混合状态空间模型的预训练成本降低 99% 以上,使开发者能够研究此前因成本过高而难以探索的问题。
Google Developers Blog谷歌 AI 边缘团队开源 ML Drift,这是一个高性能、跨平台的边缘设备 GPU 计算引擎,用于设备端 AI/ML 推理。通过抽象 OpenGL ES、OpenCL、Metal 和 WebGPU 等硬件低级 API 的复杂性,ML Drift 使开发者能构建实时交互式 AI 体验。
Amazon ScienceAmazon Science 发布图形中心智能体技术,通过将网络表示为包含设备属性和连接的持续同步图(数字孪生),结合级联图算法(分解、聚合、溯源)和智能体编排,实现复杂网络故障的分钟级根因分析,在 NTT DOCOMO 的 MWC 演示中达到 95% 准确率。
Google Developers Blog稀疏视频生成(SVG)通过识别视频扩散模型中不同注意力头的时空结构,动态路由注意力头至空间或时间掩码,将理论上的稀疏性转化为实际端到端速度提升。在TPU v6e上,SVG保留约38.87%的查询-键对,实现3.5倍推理加速,同时保持给定稀疏度下的输出质量。该方案采用自定义JAX和Pallas Splash注意力内核,将理论稀疏性转化为硬件上的物理稀疏性。
 Meta AI Blog
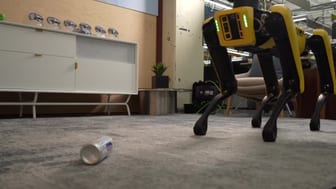
Meta AI 的 DINOv3 和 SAM 模型在边缘计算中实现实时感知,支持匹兹堡大学 RAMMP 项目开发辅助机器人,通过自然语言与图像数据交互,降低用户认知负荷,已在原型中集成自动门按钮检测、杯子识别及导航辅助功能,并计划增加语音和触控输入支持。
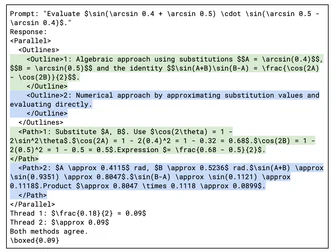
Berkeley AI Research适应并行推理让模型根据问题自行决定何时分解和并行化独立子任务、同时启动多少线程以及如何协调。现有方法如固定并行、启发式结构化搜索和蒙特卡洛树搜索等,均在模型外部决定并行结构。最新进展如 ParaThinker 和 GroupThink 等尝试让模型自适应选择并行策略,但决策仍受外部限制。