AWS Machine Learning Blog3434
在 Amazon SageMaker JumpStart 上部署 OpenFold3:预测生物分子结构
OpenFold3-preview 可在 Amazon SageMaker JumpStart 上部署,该开源生物分子结构预测模型由 OpenFold Consortium 和哥伦比亚大学的 AlQuraishi Lab 开发,支持蛋白质、DNA、RNA、小分子配体及其复合物的 3D 结构预测。
AWS Machine Learning Blog3434OpenFold3-preview 可在 Amazon SageMaker JumpStart 上部署,该开源生物分子结构预测模型由 OpenFold Consortium 和哥伦比亚大学的 AlQuraishi Lab 开发,支持蛋白质、DNA、RNA、小分子配体及其复合物的 3D 结构预测。
AWS Machine Learning Blog4545Amazon Bedrock AgentCore runtime V2 通过一次性准备环境并快照恢复,将会话启动时间缩短至约 2 秒,同时回收未使用的内存。V2 支持构建钩子以加载大文件或 CLI,适用于需要提前准备资源的场景。通过 CloudWatch 指标可测量会话启动时间,优先优化平台开销或代码执行时间。
AWS Machine Learning Blog开发者使用 Claude Code 和 OpenAI Codex CLI 等编码智能体时,需按任务而非单次调用付费,因此模型路由应基于每项任务的成本。NVIDIA NeMo Switchyard 是一个开源库,可帮助 AI 智能体选择处理每个请求的模型,支持 Stage 和 Random 两种路由策略。
 Codex releases00
GitHub Copilot 发布 0.171.0-alpha.5 版本,提供代码审查、漏洞检测和秘密扫描等功能,支持企业级代码安全和 AI 特性。
 Google Research精选8888
Google 在 Antigravity 中向外部研究者和开发者开放 /teamwork 多智能体工作流,可与 Gemini 4 Argon、Carbon、Hydrogen 配合使用,/boost 和 Deep Review 也已可用。
推荐理由: Google公开了/teamwork在多智能体科研与工程任务上的具体结果,并开放给外部研究者使用。
 LangChain Deep Agents releases1212
langchain-modal 0.0.8 发布,修复了 `ModalSandbox` 文件 I/O 问题,更新为使用 `Sandbox.filesystem` API
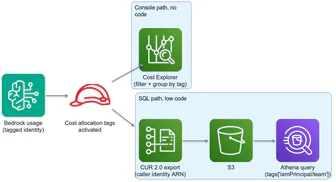
AWS Machine Learning Blog3838Amazon Bedrock 通过内置的零 instrumentation 成本归因功能,将每一次推理调用追踪到 IAM 主体,并将身份信息与组织标签传递至 AWS Cost and Usage Reports (CUR 2.0) 和 AWS Cost Explorer,同时保持数据在 AWS 安全边界内。
AWS Machine Learning BlogAssemblyAI 通过混合使用 AWS 的 EC2 On-Demand 和 Spot 实例,并利用 Amazon ECS、SQS 和 EventBridge 构建弹性架构,以 3.5 倍的速度提升 GPU 实例利用率,在欧洲 AWS 区域内实现成本降低并满足服务等级协议(SLA),其推理平台部署在 g4dn、g5、g6 三种 GPU 实例家族上。
 Ai2 Blog同一件事 · 2 家4040
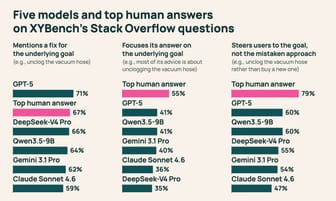
XYBench 发布,包含 8K+ 问题测试 AI 助手如何应对基于误解的请求;Claude Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B 和 DeepSeek-V4 Pro 在测试中常聚焦原错误方法而非用户实际目标。
各家口径不同:Ai2博客称基准测试包含8K+问题,而Hugging Face博客提到8150个问题。
 Meta Engineering
Meta 将 Android 虚拟设备框架 Cuttlefish 原生移植到 macOS,通过支持 QEMU 和 vhost-user,解决在 Apple Silicon 上运行虚拟设备的技术难题,提升开发效率并统一测试环境。新版本支持 macOS 的显示、签名和构建流程,并扩展了蓝牙、Wi-Fi、3D 图形等特性,使 Mac 开发者可使用与 CI 相同的高保真虚拟设备。
 Hugging Face Blog同一件事 · 2 家4040
Hugging Face 发布 XYBench 基准测试,包含 8150 个真实问题,评估 AI 助手识别用户误解并引导至正确解决方案的能力。Claude Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B 和 DeepSeek-V4 Pro 在测试中倾向于关注用户错误假设(Y),而非实际目标(X),其中只有 35-41% 的回答以实际目标为中心。
 Databricks Blog
Databricks 发布了 Genie Migrate,现支持从 Microsoft SQL Server、Azure Synapse、Teradata、Oracle、Snowflake、Amazon Redshift、Google BigQuery 迁移至 Lakehouse,自动转换 SQL 代码至 ANSI SQL。
LangChain Deep Agents releases2020LangChain Deep Agents 0.7.38 发布修复了当软链接解析超出批准搜索范围时,`ls`、`grep` 和 `glob` 会错误返回结果的问题。
 NVIDIA Newsroom
Dyania Health的Synapsis AI通过分析患者全部病历记录,连接多年间隔的发现以回答临床问题,帮助医护团队识别需要关注的患者及原因;该系统基于NVIDIA NeMo、TensorRT和TensorRT-LLM构建,在医疗机构内部运行以保护数据安全,已在克利夫兰诊所支持超过7800名主动脉瓣置换患者的长期随访研究。
 蚂蚁 inclusionAI · Hugging Face 新模型
inclusionAI 发布 FP8-量化四步蒸馏的 Duo 1.0 Realization 权重,用于其因果基础模型,支持全双工实时音视频交互,需与因果基础模型权重叠加使用。
Codex releases00GitHub Copilot 0.171.0-alpha.2 发布,该 AI 编码智能体用于任务、项目和自动化工作,支持代码审查、协作和云端开发环境。
蚂蚁 inclusionAI · Hugging Face 新模型SingVL-4B GGUF 是基于 Qwen3.5 的 4B 参数多模态决策模型 Sing VL S1 的 GGUF 版本,可对文本或 JSON 及最多四张图像回答命名问题,并使用完整前向传递评分选项,在 Text 评测中得分为 69.76,Vision 评测中得分为 73.94。模型使用 llama.cpp 适配器,默认上下文容量为 4096 token,支持文本和图像输入。
Databricks Blog2222Lakebase 架构通过单一持久化数据副本服务于 Postgres 和分析,无需 CDC 管道或第二数据库。该架构将数据分层存储于对象存储和缓存中,并非传统复制。其支持点查和扫描两种访问路径,使用 Postgres 堆页和 Parquet 格式分别优化,且无额外同步任务。
 vLLM Blog
DeepSeek-V4.1-Flash 在单台 NVIDIA Vera Rubin NVL72 机架中实现每 GPU 1.7M tokens/s 的服务能力,单个用户达 387 tokens/s,较 GB300 NVL72 提升 58 倍。
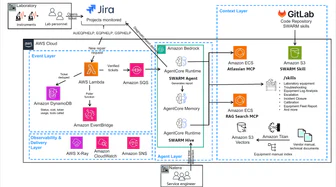
AWS Machine Learning BlogNatera 为解决实验室设备故障导致的知识断层问题,开发 SWARM 智能体系统,通过 Amazon Bedrock AgentCore 实现 130 倍响应提速和 96.2% 自动化处理支持工单。
AWS Machine Learning BlogSGLang-Neuron 通过 AWS Deep Learning Container 公开可用,支持在 AWS Trainium 上使用 SGLang 推理和强化学习部署,采用与 SGLang 相同的接口,运行在原生 PyTorch 上,支持 PD disaggregation 和 10240 token 上下文长度。
vLLM Blog精选6060vLLM 在 Inkling 2 Small 发布首日提供支持。该模型是文本与视觉输入的多模态 MoE,总参数 594B、激活参数 17B,上下文最长 1M tokens,并自带 DSpark 推测解码器。
推荐理由: 原文给出了 vLLM 对 Inkling 2 Small 的 Day-0 支持细节与多项内核优化,读者可据此了解该模型的部署路径与吞吐表现。
AWS Machine Learning Blog亚马逊 Bedrock 推理的请求级选择仍会改变服务处理的 token 数量和应用税率。缓存持续时间、服务层级、推理努力和 maxTokens 可在不改变模型或提示的情况下影响成本。每个选择取决于模型和工作负载,可通过响应元数据、日志和账单数据验证其效果。
 Google Developers Blog
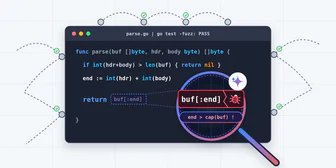
Gemini 4 Argon 将 Go 代码的 panic 路径转化为 Z3 约束规则,配合 Z3 检查触发条件,配合 go test 重放触发字节,在 1 分钟内定位 3 个植入的解析器 Bug 并发现 3 个 skill-lint 潜在 Bug。该流程比 go test -fuzz 更高效,能找到模糊测试遗漏的边界检查错误。
AWS Machine Learning BlogAmazon Bedrock 自动记录调用者身份,用户可通过 IAM 主机分配标签、激活成本分配标签并使用 CUR 2.0 或 AWS Cost Explorer 报告数据,再结合 AWS Budgets 设置预算动作实现支出限制。无需编写应用代码,当达到阈值时预算动作会自动应用 Deny IAM 策略。此方案适用于已使用 IAM 角色的账户,支持静态主标签和动态会话标签两种身份映射方式。
Databricks BlogEclipse Aerospace 与 Databricks 合作,通过 PySpark 自定义数据源将近 20 年的专有飞行数据(总计 3TB)更便捷地用于服务中心和工程师,无需额外基础设施。
Codex releases00GitHub Copilot 发布 0.170.0-alpha.4 版本,提供代码审查、安全漏洞检测和密钥扫描等功能。
AWS Machine Learning Blog3838开发者可通过 Amazon Bedrock 应用推理配置文件和 LiteLLM 快速访问基础模型,实现单 API 访问、用户级成本控制和模型性能可观察性。
 Google AI Blog精选8282
Google搜索上线Gemini 4 Hydrogen,这是搜索迄今最大的一次模型升级,已面向全球所有用户开放。官方称新模型能理解多部分问题、拼写错误和高度具体的请求,并借助更强的指令遵循与工具调用能力逐项回应问题。Hydrogen的推理能力还强化了查询分发,可同时检索多个相关子主题并给出更多图片、结构化回答、对比表格和定制工具。
推荐理由: Google官方说明Gemini 4 Hydrogen在搜索中的意图理解、查询分发与可视化回答变化,可据此判断搜索体验的调整方向。
 OpenAI Alignment Blog
OpenAI 使用自动化红队技术训练 GPT-6 Astra 和 Sol,显著提升了模型在高风险领域(如网络、生物和暴力活动)抵抗越狱攻击的模糊鲁棒性。在无生产环境安全防护的测试中,Astra 在网络领域比 GPT-5.6 Sol 安全率高出 32.5%,并在所有攻击者预算下保持更优的鲁棒性。
 Google DeepMind精选8787
Google DeepMind 发布 Gemini 4 Hydrogen,面向日常编码与智能体工作流,在默认 high 思考档位下 Artificial Analysis 智能指数为 51,高于 Argon 的 50,xhigh 档位可达 54
推荐理由: 官方给出Hydrogen与Carbon、Argon的分工定位,以及多模型编排在成本与速度上的实测差异。
 Apple Machine Learning Research3838
研究人员推导出固定KL散度预算下KL正则化对齐的最大预期奖励增益,首次用Jeffreys发散项而非√KL描述最优奖励改进;实验表明PPO和GRPO等常用方法远低于理论极限,最佳N选策略接近理论最优,为提升对齐效果提出算法改进方向。
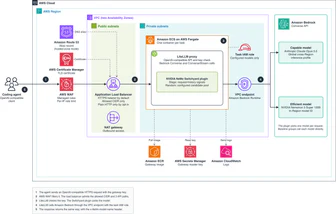
AWS Machine Learning BlogAmazon Bedrock AgentCore 运行时通过硬件隔离的 Firecracker 微虚拟机(MicroVM)为每个会话提供安全环境,新版本将启动速度提升 15 倍,计算扩展至 4 倍,效率提高 68%,支持最高 8 vCPUs 和 32 GB 内存及 10 GB 容器镜像,会话启动时间少于 2 秒,适用于复杂工作负载。
Databricks BlogH6.ai 在客户现有 ERP 上自动化应付账款处理,通过读取发票、匹配采购订单、分配会计科目并对照公司政策执行,结合 AI 辅助理解与确定性政策执行。其采用 Lakebase Postgres 为每位客户建立专用数据库,存储采购订单、供应商、会计科目、历史交易和政策等财务上下文,支持频繁回归测试。
 PyTorch Blog5050
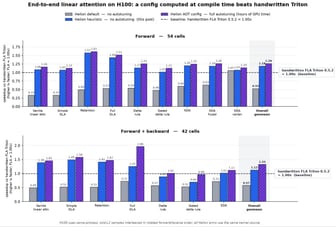
Helion 通过编译时启发式算法分析内核 IR 和数据流,无需慢速自动调优即可选择快速设置,将内核分类为矩阵乘法、归约或逐点操作,并选择块大小、warp 和阶段,实现近乎自动调优的速度。
Databricks BlogBlock 公司推出 Buzz 开源协作空间,让员工与 AI 智能体在共享工作区互动。通过 Databricks Unity Gateway,用户可访问 OpenAI、Anthropic、Google 等前沿模型及开源模型(原文未提具体数量),实验不同智能体框架组合。员工能创建 AI 智能体并选择模型(如包含 Goose 轻量版),实现多人协作开发、分析等任务。
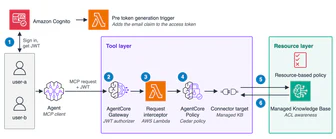
AWS Machine Learning Blog5858Amazon Bedrock Managed Knowledge Base 通过在 AgentCore Gateway 工具层注入用户上下文并验证 JWT,结合知识库的 ACL 意识功能,实现企业 AI 代理的细粒度访问控制。
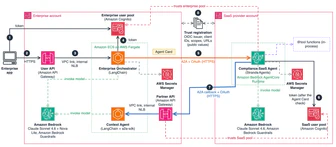
AWS Machine Learning Blog5555AWS 推出 Agent-to-Agent (A2A) 协议,使跨组织边界运行的多智能体系统能够通过标准化协议发现彼此、通信和交换任务,无需暴露内部细节或依赖相同框架。
PyTorch Blog两人的团队借助 AI 编程智能体,在不到一周内完成了 SGLang 与 IBM Spyre 的集成,构建了一个约 1,500 行代码的插件。SGLang 在 Spyre 上的推理吞吐量比参考 PyTorch 实现(使用 torch-spyre)高约 3.6 倍,并在 Granite 3.3 8B 和 Gemma 4 26B A4B 工作负载上与 vLLM 性能相当。
PyTorch BlogEUROPA联盟在JUPITER超级计算机上使用PyTorch和TorchTitan成功训练了参数量达951.9B的MoE模型,将单GPU的吞吐量从90提升至约1,300 tokens/s,使用了384个NVIDIA GH200 GPU。