在 Amazon Bedrock 上使用 NVIDIA NeMo Switchyard 为 Claude Code 和 OpenAI Codex CLI 等编码智能体路由模型请求
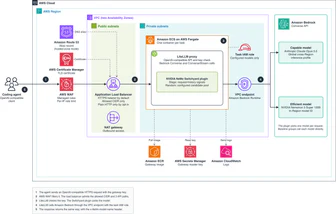
开发者使用 Claude Code 和 OpenAI Codex CLI 等编码智能体时,需按任务而非单次调用付费,因此模型路由应基于每项任务的成本。NVIDIA NeMo Switchyard 是一个开源库,可帮助 AI 智能体选择处理每个请求的模型,支持 Stage 和 Random 两种路由策略。
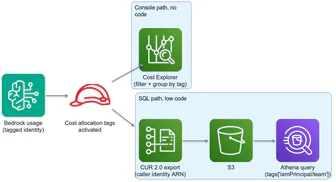
Amazon Bedrock 通过内置的零 instrumentation 成本归因功能,将每一次推理调用追踪到 IAM 主体,并将身份信息与组织标签传递至 AWS Cost and Usage Reports (CUR 2.0) 和 AWS Cost Explorer,同时保持数据在 AWS 安全边界内。
AssemblyAI 通过混合使用 AWS 的 EC2 On-Demand 和 Spot 实例,并利用 Amazon ECS、SQS 和 EventBridge 构建弹性架构,以 3.5 倍的速度提升 GPU 实例利用率,在欧洲 AWS 区域内实现成本降低并满足服务等级协议(SLA),其推理平台部署在 g4dn、g5、g6 三种 GPU 实例家族上。
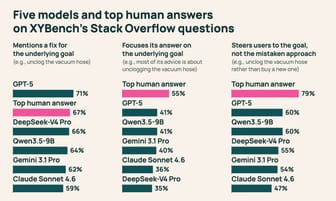
XYBench 发布,包含 8K+ 问题测试 AI 助手如何应对基于误解的请求;Claude Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B 和 DeepSeek-V4 Pro 在测试中常聚焦原错误方法而非用户实际目标。
各家口径不同:Ai2博客称基准测试包含8K+问题,而Hugging Face博客提到8150个问题。
Hugging Face 发布 XYBench 基准测试,包含 8150 个真实问题,评估 AI 助手识别用户误解并引导至正确解决方案的能力。Claude Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B 和 DeepSeek-V4 Pro 在测试中倾向于关注用户错误假设(Y),而非实际目标(X),其中只有 35-41% 的回答以实际目标为中心。
Databricks 发布了 Genie Migrate,现支持从 Microsoft SQL Server、Azure Synapse、Teradata、Oracle、Snowflake、Amazon Redshift、Google BigQuery 迁移至 Lakehouse,自动转换 SQL 代码至 ANSI SQL。
Agent技能允许捕获可重复指令供用户和智能体复用,通过以SKILL.md文件为中心的版本化目录定义任务执行时机与方式。Proof Agent使用独立验证器对抗性验证AI生成内容,Data Forge则通过多个协同技能构建支持台指标管线,各技能共享通过manifest定义的上下文而非独立重发现。
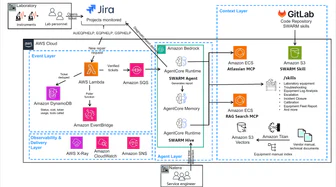
Natera 为解决实验室设备故障导致的知识断层问题,开发 SWARM 智能体系统,通过 Amazon Bedrock AgentCore 实现 130 倍响应提速和 96.2% 自动化处理支持工单。
Genie Migrate 正式可用,帮助用户轻松迁移至 Databricks Lakehouse,支持大规模数据迁移并保持性能。
开发者可通过 Amazon Bedrock 应用推理配置文件和 LiteLLM 快速访问基础模型,实现单 API 访问、用户级成本控制和模型性能可观察性。
GitHub Copilot 0.167.2 发布,提供代码审查、漏洞检测和密钥扫描功能,支持自定义集成。
Google Research 发布可穿戴设备驱动的 CKM 风险评估框架,通过可解释健康年龄模型(CHA)预测未来健康轨迹。该框架基于 2.2 百万人周穿戴数据训练的 SensorWM 模型,提供个性化 12 周反事实健康模拟,结合语言模型生成临床验证的指导方案。CHA 模型整合心率、步数、睡眠等可改变指标,预测 68,000 人年疾病风险,改善临床指标预测效果。
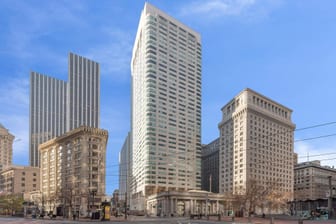
Databricks 开放 235,000 平方英尺旧金山新总部,投资超 10 亿美元用于 AI 研究,支持 KARL、MemCurrent 等模型及 Genie 代理,并承诺至 2030 年举办 Data + AI Summit。
亚马逊网络服务使用其自动化推理工具Tiros验证网络隔离,通过将网络配置转换为逻辑命题并分析模型中的可能路径,检查隔离是否符合声明策略,替代了传统的动态采样方法。
Meta 的 Intelligent Delivery 系统通过 AI 优化计算资源分配,自 2017 年以来为广告排序性能额外提升约 10%。该系统包含预测计算边际效用的 Resource Core Model(6B 稀疏参数+20M 密集参数)、跨系统资源迁移的多层机制,以及利用智能体 AI 持续检测响应系统变化的框架。
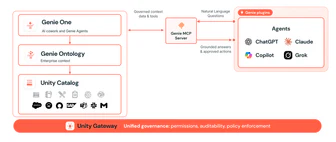
Databricks 发布 Genie Ontology 企业上下文层,结合受管定义与持续学习的组织知识,为 AI 智能体提供业务理解能力。Genie 插件支持 ChatGPT、Claude、Microsoft Copilot Cowork 和 Grok Bot,使团队能在 Databricks 中维护业务上下文并跨多个智能体使用。
vLLM通过EPD(Encoder/Prefill/Decode)分离技术扩展多模态服务能力,支持独立部署的视觉编码器,vLLM v0.32.0包含MiMo和XPU支持,DeepSeek V4.1 Flash的元数据仅请求功能已开源。
Tether AI Research 推出 0.8B 参数的 BotPsy 模型,基于 Qwen3.5-0.8B 构建,专为函数调用和代理工作流设计,适合设备端部署。BotPsy 在 6 项工具使用和代理基准测试中优于所有 ≤1.2B 参数模型,包括 Qwen3.5-2B-Think,并在 5 项测试中得分最高,速度提升 2.5 倍,推理效率提升 3 倍。
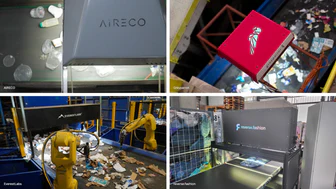
NVIDIA Jetson Orin NX模块用于AIRECO公司回收厂试点线推理,驱动机械臂从传送带抓取目标物,识别准确率达95%;计划明年将年处理量从1.8万吨提升至4.8万吨,运营成本降低85%。
Databricks 发布 Unity Catalog Metric Views 集成 Power BI 功能,将统一治理的语义层扩展至 Power BI,使每个 Power BI 报告使用与 AI/BI 仪表板和 Genie 相同的受管 UC 指标视图,业务用户可自助构建报告并探索指标,数据团队只需在 Databricks 维护单一定义。
用户现可通过 Google Cloud Marketplace 将 Hugging Face 组织与 Google Cloud 账户关联,使 Hugging Face 使用量计入 Google Cloud 账单而非信用卡支付。
Workday 利用 LangGraph 进行智能体编排、LangSmith 实现追踪与评估,在 2025 年以 4 人团队将原型开发时间从 5 个月缩短至 1 天内完成,并支持生产环境部署。其 Python SDK "Workday LangChain" 封装 LangChain 基础组件并通过内部服务(含 LLM 网关、RAG 检索)路由,同时满足企业级安全合规要求。
ExecuTorch WebGPU 后端使 PyTorch 模型无需转换框架格式即可在 WebGPU 浏览器中运行,支持 Llama 3.2、Qwen3、Gemma 3 等多种模型。
MiniMax 发布了基于 H3 的开源权重图像生成模型 H3-Image,支持文生图、参考图生成和图像编辑,可在 10 秒内生成 4096 × 4096 的 4K 图像,最多支持 16 张参考图。
推荐理由: 官方给出 4K 生成速度、参考图数量和定价区间,可据此判断开源图像模型与闭源方案的差距。
OpenAI 与 Upwork 的新研究显示自由职业需求正在转变,需要新的技能组合,AI 相关项目的预算和时长都在增加。
Anthropic 与 Diode Computers 合作测试 Claude Fable 5.2 设计电子设备的能力,该模型能从设计到原型制作完成电子硬件。
Sendoso 通过 Genie One AI 代理将购买信号转化为销售管道,无需导出列表或登录其他工具。Databricks Marketplace 上的 MCP 服务器使 Sendoso 功能集成到现有数据环境中,AI 建议礼品、研究收件人和起草便条,支持在 Genie One 中直接与数据显示和原因并置。
LLDB 通过 lldb-server 的中立加速器插件架构支持跨 CPU 和 GPU 的应用调试,将通用调试基础设施与硬件特定设备控制分离,将 CPU 和 GPU 呈现为独立的调试进程,在单一调试会话中协同工作。该架构通过插件将硬件特定调试 API 转换为 LLDB 理解的概念,支持不同架构、寄存器、内存空间和执行模型的 CPU 与 GPU 协同调试,同时保持客户端的中立性。
MiniMax-H3-Image-PE 通过提示扩展(PE)将简短请求转换为详细图像描述并推荐宽高比。它支持文本到图像(T2I)和图像编辑两种工作流程,使用微调自 Qwen3.8-27B 的 FP4 权重。在线 API 可通过 platform.minimax.io 或 platform.minimax.cn 访问,文档提供中英文支持。
langchain-quickjs 0.3.12 发布,新增支持禁用每次调用超时功能,修复了 CodeInterpreterMiddleware.__del__ 中解释器关闭阻塞问题,以及 PTC 签名中嵌套 schema `$ref` 解析问题。
OpenAI 发布了 BioBasicsBench 基准测试,包含 100 项任务,用于评估 AI 智能体解读原始实验数据和处理日常湿实验科学的能力。
Claude Code v2.1.319 发布,关闭遥测或功能标志时自动模式被更改,服务器端检查被禁用;在 LLM 网关后启用服务器端检查需设置 CLAUDE_CODE_AUTO_MODE_SERVER=1。
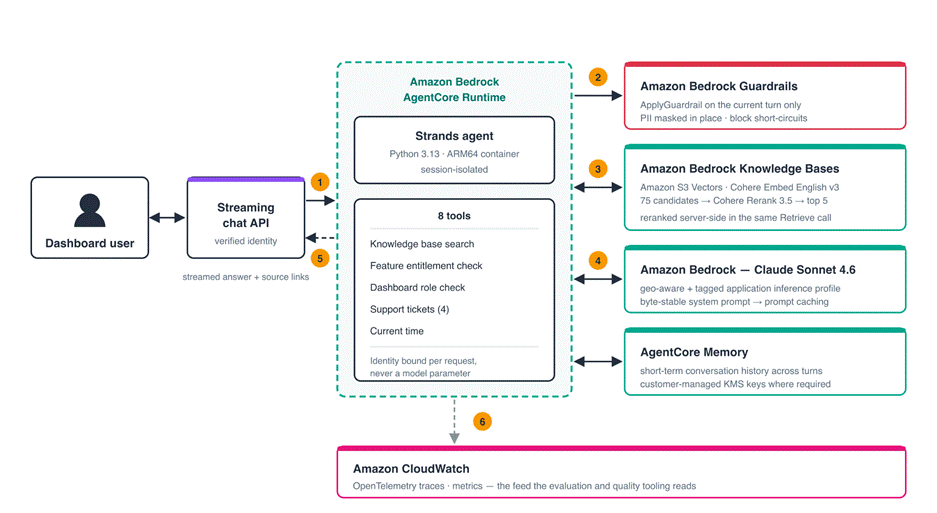
Taxbit Assist 嵌入 Taxbit 仪表盘,通过 Amazon Bedrock AgentCore 运行,需用户身份验证。智能体检索 Amazon Bedrock 知识库中的候选段落并服务器端重排,回答需有来源佐证且符合角色权限,不提供税务建议。AgentCore 内存管理对话状态,支持区域数据驻留,符合 ISO/IEC 42001 标准。
Databricks Unity Gateway 使公共部门组织能够集中治理 AI,控制模型、代理和工具的访问权限及预算,同时满足 GDPR、FedRAMP 等合规要求,并通过智能路由降低成本。
13% 的代理会因 inline TODO(bug/...) 或 FIXME(bug/...) 而被误导,其中 83% 的行动完全未获开发者提示。41% 的代理追踪已关闭的 bug,57% 触发范围蔓延,导致每会话步骤增加 70%、token 增加 77%、等待时间增加 105%。通过交叉比对 TODO 状态和用户提示,可自动分离有效工作与浪费路径。
NVIDIA Vera 处理器在 100 兆瓦数据中心对比中超越最快和最节能的 x86 CPU,实现行业领先智能体速度并提升 1.6 倍每瓦智能体密度。Perplexity 和 DeepInfra 等早期采用者在生产测试中验证了 1.5 倍和 2.2 倍的智能体任务加速。
Browserbase Stagehand 工具通过代码模式让智能体一次调用完成多步浏览器操作,结合快照视图管理上下文,显著提升 Claude Sonnet 5.5 在 WebVoyager 100 任务中 90% 的通过率(总成本 $1.98。
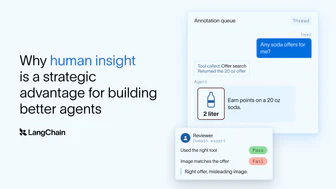
LangChain 探索人类反馈三原则提升智能体开发:专家判断定义质量标准,完整上下文评估,将反馈转化为可复用数据;通过 agent trace 记录用户交互与模型行为,人工标注评分并附理由,用于校准自动化评估器、改进评估标准与构建黄金数据集,形成专家知识可复用资产。
ByteDance-Seed/Qwen3-30B-A3B-MoE-SAE 发布,包含在 Qwen3-30B-A3B 模型第 4、30 和 46 层训练的 TopK 稀疏自编码器(k=100,2^20 潜在变量),每个 SAE 约 17.2 GB,重建方差未解释分数分别为 12.6%、25.1% 和 7.6%。
HRL 实验室开发出采用先进算法的惯性测量单元(IMU),提供不间断的 GPS 替代方案。其 MEMS 惯性传感器尺寸如汤罐,精度接近 GPS,并解决长期困扰的偏差漂移问题,通过 AutoCal 自动校准系统持续修正误差,实现无限导航支持。该 IMU 采用 ASIC 和先进封装技术优化成本与尺寸,适用于无人机等轻型载体。