腾讯混元 · Hugging Face 新模型
腾讯混元发布 WeVisOne-VL-4B 统一视觉语言模型
腾讯混元发布 WeVisOne-VL-4B 模型,基于 Qwen3-VL 构建,集成 9.6M 参数像素解码器,支持目标级感知(开放词汇目标检测、指向定位、计数、指向和 OCR)与像素级感知(指向分割和可提示 alpha 摩擦),适用于视觉定位、指向、计数、OCR 定位、指向分割和图像摩擦等研究任务。
腾讯混元 · Hugging Face 新模型腾讯混元发布 WeVisOne-VL-4B 模型,基于 Qwen3-VL 构建,集成 9.6M 参数像素解码器,支持目标级感知(开放词汇目标检测、指向定位、计数、指向和 OCR)与像素级感知(指向分割和可提示 alpha 摩擦),适用于视觉定位、指向、计数、OCR 定位、指向分割和图像摩擦等研究任务。
 vLLM Blog5858
vLLM 在 NVIDIA Blackwell、Rubin 和 AMD MI350 系列显卡上为 MiniMax-M3.1-Flash 提供零日支持,在智能体工作负载上表现优异。
 AWS Machine Learning Blog2727
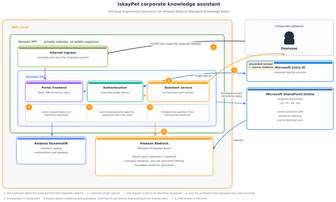
IskayPet 通过 Amazon Bedrock Managed Knowledge Bases 构建了企业知识助手,该助手能在零售运营、兽医护理、人事入职和采购等四个领域、跨越三个国家和四种语言回答员工问题,无需管理 RAG 基础设施。
 Hugging Face Blog
Hugging Face 发布 OlmoEarth v1.3,一款卫星嵌入模型,提供全球预计算嵌入(10米分辨率,64及128维度),用户无需登录或技术知识即可使用。模型在27项评测中表现最佳,128维度嵌入在20项评测中得分最高,64维度嵌入在18项评测中领先。模型训练成本较v1.2降低53%,较v1降低18%,碳排放也相应减少,权重、数据和代码全部开源。
 Google Developers Blog
Google API Gateway 现在支持流式传输,允许实时 API 调用,无需更改规范。流式传输支持 Server-Sent Events (SSE)、分块传输编码、HTTP 响应流和 WebSocket,最长连接时间可达一小时。在公共预览期间,创建网关时通过 `--enable-streaming` 标志启用,计划在正式版中自动启用,无需额外配置。
 NVIDIA Newsroom
欧洲交通领导者 Bolt with Lucid、梅赛德斯-奔驰、大众商用车和 Einride 正在 NVIDIA Hyperion 计算平台上展示自动驾驶交通应用案例,展示对 3 级和 4 级车辆以及未来自动驾驶出租车车队的潜在应用。
NVIDIA NewsroomAgile Robots 发布 Agile ONE SN 人形机器人参考平台,搭载 NVIDIA Isaac GR00T 和 Jetson Thor,计划集成 NVIDIA Halos 安全系统,为开发者提供完整的人形机器人开发与验证平台。
 PyTorch Blog3030
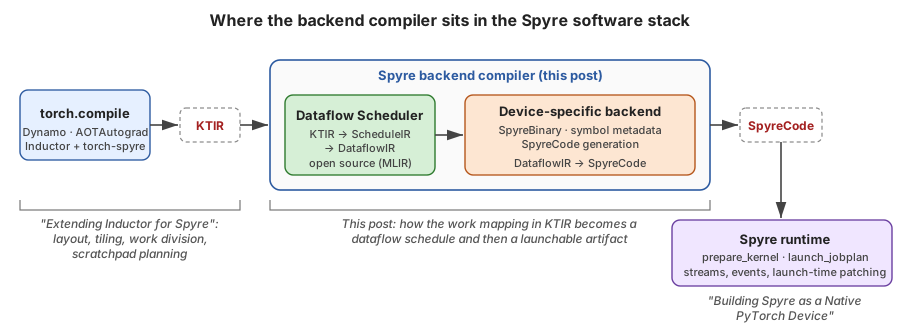
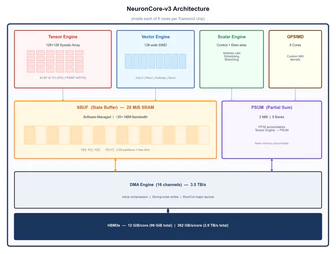
Torch-spyre 的 Inductor 决定每个内核的工作如何在 Spyre 的核心上分配,并管理张量在片上 Scratchpad 和片外内存之间的驻留,而后端编译器将这些决策转换为硬件可以实际运行的指令。
腾讯混元 · Hugging Face 新模型精选7373腾讯混元发布并开源 Hy-SimulMT-30B-A3B 系列实时同传模型,支持中英双向语音到语音翻译和实时声音克隆,同时输出译文文本与语音。在 RealSI 长音频评测中 StreamLAAL 约 3 秒,为对比系统中最低,GEMBA 分数超过所比开源模型和 5 个商业 API 中的 4 个。
推荐理由: 官方给出实时同传的延迟与质量对比,并开放模型权重和推理部署工具,可据此判断落地条件。
腾讯混元 · Hugging Face 新模型精选7474腾讯混元发布 Hy-SimulMT-30B-A3B 实时同声传译模型,支持中英双向语音到语音翻译并实时克隆说话人音色,已在 Hugging Face 开源多个版本。
推荐理由: 官方给出与开源模型、商业 API 及专业同传译员的对比数据,可据此判断实时同传的质量与延迟取舍。
腾讯混元 · Hugging Face 新模型精选7272腾讯混元发布并开源实时同声传译模型 Hy-SimulMT-30B-A3B,支持中英双向语音到语音翻译,可在说话过程中持续输出译文文本与语音,并支持实时声音克隆。
推荐理由: 官方给出实时同传的延迟与质量对比,并开放多个量化版本和推理部署脚本,可据此评估落地成本。
腾讯混元 · Hugging Face 新模型精选7575腾讯混元发布并开源 Hy-SimulMT-30B-A3B,支持中英双向语音到语音实时同声传译,边接收音频边输出译文文本和语音,并支持实时声音克隆。在 RealSI 长音频评测中,其 StreamLAAL 约为 3 秒,为对比系统中最低,GEMBA 分数高于所比较的开源模型和五个商业 API 中的四个。
推荐理由: 原文给出中英双向同传的延迟与质量对比数据,并附开源权重和部署方式,可据此判断实时语音翻译的可用程度。
PyTorch BlogPyTorch 用户可在 AMD MI350 系列显卡上通过 FlyDSL 使用现有算子 API 加速密集和分组 GEMM、融合多头注意力、MXFP8/MXFP4 缩放 GEMM、RMSNorm 和 TopK,无需调用自定义内核
 Google Research
 发布的 AI 模型在 JAMA Network Open 上验证,其通过盲扫超声技术评估孕期周数(gestational age)的准确性。
Hugging Face BlogHugging Face 介绍了如何使用 TorchNeuron 在 AWS Trainium 上进行系统级推理性能分析,通过 torch.profiler 配置 Neuron 后端捕获干净 traces,并利用 key_averages() 表识别耗时操作。
 Mistral AI5050
Mistral 与 NVIDIA 合作将 AI 模型与 NVIDIA 加速计算和物理建模工具整合,加速工程模拟并实现闭环 AI 驱动设计。合作将推出公共基准和开放数据集,标准化物理和智能体 AI 在计算机辅助工程中的评估,并利用 NVIDIA Omniverse 进行 3D 模拟和资源创建。
 NVIDIA Blog5858
NVIDIA 欧洲合作伙伴正扩展区域计算能力,支持模型训练与推理,帮助开发者构建 agentic 和物理 AI 应用。Nscale 使用 NVIDIA DSX 平台实现 37% 更多 GPU 和 50% 更高推理吞吐量,Crusoe 开发液冷 AI 工厂支持低延迟推理,Nebius 采用 NVIDIA Groq 3 LPX 加速敏感应用。
NVIDIA BlogNVIDIA 在 GTC Berlin 上展示了其本地 AI 硬件全阵容,RTX Spark 已上线支持 Windows PC 上的个人智能体,DGX Spark 支持开发者构建和扩展 Linux 应用,DGX Station 则为 Linux 企业团队运行前沿工作负载,Windows 版将于 12 月推出。
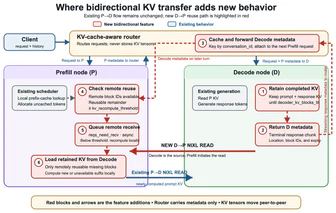
AWS Machine Learning Blog5858vLLM 的双向 KV 传输机制通过让解码节点在后续对话回合中返回先前计算的 KV 缓存给预填充节点,减少了重复计算,在 AWS EC2 P5en 实例上的多轮基准测试中将 Qwen3-32B 的 TTFT 提升了 1.6 倍,zai-org/GLM-5-FP8 提升了 3.3 倍。该功能通过扩展 NIXL KV 连接器实现,并利用 KV 缓存感知路由器协调跨对话回合的 KV 重用。
AWS Machine Learning Blog4949vLLM 引入基于推送的 NIXL 连接器,通过将后预填充传输协调和设置移出关键路径,减少时间到第一个 token (TTFT) 和每个输出 token 的时间 (TPOT),提升应用响应性。
AWS Machine Learning Blog5858TwelveLabs 的 Pegasus 1.5 视频语言模型现已在 Amazon Bedrock 上提供,可将长视频转换为结构化、带时间戳的元数据,支持基于用户定义标准分析整个视频并返回匹配片段的 JSON 数据,分析时长扩展至每请求两小时,无需预索引且数据保留在 AWS 边界内。
AWS Machine Learning Blog3434AtScale 作为语义层,通过 Semantic Modeling Language (SML) 在 Amazon Redshift 上构建维度模型,支持 Amazon Bedrock AgentCore 中的 Strands 智能体,实现跨系统 Customer 360 分析。
AWS Machine Learning Blog3434Strategy Mosaic 作为语义层,通过两个链接模型在 Amazon Redshift 和 Amazon Aurora 上无 ETL 地建模 C360 领域,其度量语法捕获智能体推理的业务定义,并通过 Mosaic MCP 服务器向 AgentCore 托管的 Strands 智能体暴露模型,支持用户身份传递以实现端到端行级和对象级安全。
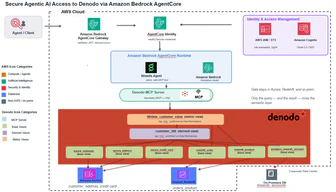
AWS Machine Learning Blog2828Denodo 平台在 AWS 上构建语义层,为 Amazon Bedrock AgentCore 提供受控的企业数据访问,支持 Amazon Aurora、Amazon Redshift 和本地 PostgreSQL 数据库的联邦查询。
AWS Machine Learning Blog4040Eon 使用 Amazon Bedrock AgentCore Gateway 替代了本地 Model Context Protocol (MCP) 服务器,将跨 AWS、GCP 和 Azure 的操作工具访问整合为单一认证网关,使新工程师调查工具配置时间从 2 天缩短至 2 分钟。
AWS Machine Learning Blog3131加拿大组织可通过 Amazon Bedrock 在加拿大 (Central) 和加拿大西 (Calgary) 区域使用 OpenAI GPT-5.6、GPT-6 和 GPT-6.1 模型,实现跨区域推理。
AWS Machine Learning Blog3838Octave Reliance 团队为解决监管行业质量管理的知识孤岛问题,在 Amazon Bedrock 上构建了基于 Cohere Embed v4 的三层安全多人租户 AI 基础设施,将部署时间缩短 50%。
AWS Machine Learning Blog4040GPT-OSS-20B 是一个开源推理模型,默认用英语思考,在多语言推理测试中仅 22% 符合目标语言要求。通过在 Amazon SageMaker HyperPod 上使用监督微调(SFT)和强化学习(GRPO),团队可提升模型在法语、德语、西班牙语和意大利语中的推理能力,其中 SFT 负责主要行为教学,GRPO 在有提升空间时进行优化。
AWS Machine Learning Blog3838Amazon Quick 结合 Amazon Bedrock AgentCore 为供应链团队提供跨系统实时数据访问,用户可通过对话式提问在 seconds 内获取跨系统答案,如识别受港口关闭影响的高收入 SKU 及成本。Quick 作为界面层,AgentCore 作为智能层,通过 MCP 协议连接 ERP、监控、采购等后端系统,实现从问题发现到生成应急采购请求的完整流程,所有操作需人工确认。
AWS Machine Learning Blog3939i14 将其 24 层解码器 Laplace 3B(3,072D 参数,使用 Gated Linear Attention 架构)部署到 AWS Trainium2 上,实现每秒 120,000 个 token 的训练速度和 11,544 个输出 token 的并发推理能力。
 Databricks Blog
Databricks 将 RFD4-Proteina 模型集成到 Genesis Workbench,支持在 AI 运行时环境中执行,并与研究数据和工作流程连接。开发者可通过 Genie Code 和 NVIDIA BioNeMo Agent Toolkit 技能构建和调整管道,利用 serverless NVIDIA GPU 计算进行蛋白质设计。
腾讯混元 · Hugging Face 新模型精选7878腾讯混元在 Hugging Face 发布视频世界生成模型 Hy-Nomas,支持通过文本指令和相机控制进行自由形式的多轮交互,逐段生成视频并延续同一世界。模型采用分段自回归 DiT 架构,结合 Qwen2.5-VL-7B 文本编码器、相机条件模块和 PixelUMM 解码器,蒸馏推理配置为 8 步去噪、720×1280 分辨率、24 FPS。
推荐理由: 腾讯混元开源可多轮交互的世界生成模型,给出架构细节与单卡 4090 部署配置,便于评估落地成本。
vLLM Blog蚂蚁集团和 vLLM 社区开源 Humming,这是一款通用的高性能量化推理内核库。Humming 支持英伟达从图灵架构开始的 GPU 以及 T-Head Zhenwu 810E 等 CUDA 兼容设备,提供广泛的量化支持,涵盖多种整数和浮点类型、位宽和缩放方案,在多个代表性工作负载上显著优于 vLLM Marlin、FlashInfer 和 DeepGEMM 等现有实现。
Mistral AIMistral AI 推出 Voxtral 3,包含 50+ 语言实时多步对话的尖端语音模型和语音代理 SDK,其语音转文本模型 Voxtral Small Transcribe 3 在 FLEURS 45 基准中 Forced WER 0.9%。
Hugging Face Blog5858AnyLanguageModel 1.0 发布,一年支持苹果平台本地模型进展。新增支持 OpenAI Chat Completions、Anthropic Messages、Google Gemini 等云端模型,本地模型支持 llama.cpp、MLX、Core ML,工具调用与引导生成功能扩展。云端模型具备本地模型相同功能,API 密钥支持闭包动态获取。
Hugging Face BlogHugging Face 发布 TorchTPU,使 TPU 成为 PyTorch 的原生后端设备。Transformers、Diffusers 和 Kernels 现可直接在 TPU 上运行,用户只需从 Hugging Face Hub 选择模型,指定 device_map="tpu" 即可。
 Meta Engineering
GenRecs Tokenization 通过将广告、产品等项用稳定语义词汇表表示,结合 Meta 生成式广告模型(GEM)和自适应排序模型,为广告主带来 0.35% 的转化率提升。该技术利用预训练大模型的世界知识,使推荐系统能理解新项目或无历史交互的用户偏好,并通过共享概念加速学习、实现跨活动迁移、随大模型规模提升性能,形成性能改进的反馈循环。
Meta EngineeringMeta工程师通过构建一个1,300行的精简路由器,将20+工作流分配给14个专业AI代理,路由器自身不执行任何领域工作,显著提升了数据管道代理的效率和准确性。
 Sakana AI5555
Sakana AI 提出了‘QD-Rec’,将候选与假设的组作为推荐单位,通过生成AI参考过去的优秀假设来生成新的假设的循环,积累高质量的多样化推荐。在并购、客户定位、论文推荐方面进行了实验,在许多设置中平均评估都很高,构建了规模较大的推荐集合。
 LangChain Blog
Nu公司在开发AI健康教练Nu时,优先构建了评估标准以避免越界医疗诊断,采用LangGraph框架和LangSmith工具,通过按类别评分的LLM裁判和开放式行为测试,确保系统在满足健康指导需求的同时符合监管要求。评估框架针对单一回复和完整对话分别设计,支持在两个前沿模型提供商间快速迁移,安全探针和守门节点实时审查对话内容,确保产品始终处于合规边界内。