Google DeepMind精选8787
Google DeepMind 发布 Gemini 4 Carbon 前沿模型
Google DeepMind 面向开发者、企业、科学家和消费者开放 Gemini 4 Carbon,称其在网络安全能力和长程智能体工作流上达到前沿水平。

推荐理由: 官方给出 Carbon 与 Argon 的定位分工、多项基准排名和每任务成本对比,便于判断何时该用更重的模型。
Google DeepMind精选8787Google DeepMind 面向开发者、企业、科学家和消费者开放 Gemini 4 Carbon,称其在网络安全能力和长程智能体工作流上达到前沿水平。
推荐理由: 官方给出 Carbon 与 Argon 的定位分工、多项基准排名和每任务成本对比,便于判断何时该用更重的模型。
 Amazon Science
Mitra-v2 在 TabArena 基准测试中领先单模型领域,在 33 个数据集上优于 Mitra-v1,并在 ScoringBench 排名第一。
Google DeepMindGoogle DeepMind 开源 AlphaProof Code 框架,用多 LLM 智能体首次实现广泛部署的 Signal 协议代码深层形式化验证,生成超 600 万行 Lean 证明,仅 1% 代码需人工复核,将专家团队数年工作压缩至四周,并成功识别出两处已知漏洞。
 Anthropic Research
Anthropic 与 Diode Computers 合作测试 Claude Fable 5.2 设计电子设备的能力,该模型能从设计到原型制作完成电子硬件。
 Codex releases00
GitHub Copilot rust-v0.169.0-alpha.8 发布,该版本包含最新功能改进和修复。
 OpenAI News
CodeRabbit使用OpenAI模型治理和信任AI生成代码,结合Codex将工程团队的软件交付量提升20倍。
 Claude.dev Blog同一件事 · 3 家
Anthropic 推出四种 Claude 模型供用户选择:Claude Haiku 5.5、Claude Sonnet 5.5、Claude Opus 5.5 和 Claude Fable 5.2。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
 Google Developers Blog5858
Google Cloud 发布 MaxText v0.2.4,支持在 TPU 上进行长上下文训练,通过 MaxText Context Parallelism 技术,在 TPU 5p 上使 Llama 3.1 8B 模型达到 4 百万 token 长度的序列 70% 的 MFU,在 TPU 5p 和 TPU 7 上可无缝扩展至 14 百万 token
 AWS Machine Learning Blog5858
NVIDIA Nemotron 3.5 Super VL 已在 Amazon SageMaker JumpStart 中可用,支持图像、视频和文本输入生成文本。
AWS Machine Learning Blog同一件事 · 3 家Anthropic 在 AWS 上推出 Claude Fable 5.2 和 Claude Mythos 5.2,Fable 5.2 是其最强大的通用模型,适用于编码和科学领域,支持长达数天的无监督运行;Mythos 5.2 通过验证计划提供,在网络安全和生命科学领域表现更可靠。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
 Claude · YouTube精选同一件事 · 3 家7575
Anthropic 发布 Claude Fable 5.2,称其在编码、推理和视觉方面有所改进,面向最复杂、开放式的技术工作。官方建议多数编码和知识任务从 Opus 5.5 起步,Fable 5.2 已在 Pro、Max、Team 和 Enterprise 套餐上线。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
Claude · YouTube精选6868Claude Mythos 5.2 预测出完整的 AAV 衣壳结构,该衣壳由 60 条相同的蛋白链组成。它编写代码让开源折叠模型处理相邻五链的重叠分组,再利用衣壳对称性把 60 条链拼接起来。在 AAV2 上,其预测与实验结构的偏差约为一个原子的宽度。
推荐理由: 原文给出了模型在真实科研任务中的具体做法与精度,读者可据此判断它在结构预测类工作里的可用边界。
Claude · YouTube精选同一件事 · 3 家7575Anthropic 发布 Claude Fable 5.2,面向最艰巨的技术挑战,在编码、推理和视觉方面有所提升,适合最具野心的开放式技术工作。官方建议多数编码与知识任务优先使用 Opus 5.5,Fable 5.2 已在 Pro、Max、Team 和 Enterprise 套餐上线。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
推荐理由: 官方说明了 Fable 5.2 的定位与适用场景,并给出与 Opus 5.5 的选择建议,便于判断该用哪个模型。
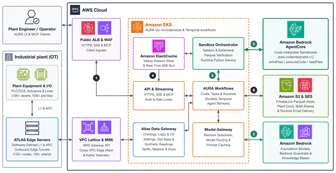
AWS Machine Learning Blog3838CrossnoKaye 通过其 ATLAS 平台和 AURA 智能体,在 Amazon Bedrock AgentCore 上实现工业物理 AI,将生产提效 11-17% 并降低能耗 21%。AURA 利用 AgentCore 的代码解释器能力,在隔离微 VM 中运行 Python 工作负载以验证数值计算,同时通过边缘集群和云优化系统实现闭环控制。
Codex releases00GitHub Copilot 发布 0.169.0-alpha.6 版本,该版本未提供具体更新内容。
 Meta Engineering3838
LLDB 通过 lldb-server 的中立加速器插件架构支持跨 CPU 和 GPU 的应用调试,将通用调试基础设施与硬件特定设备控制分离,将 CPU 和 GPU 呈现为独立的调试进程,在单一调试会话中协同工作。该架构通过插件将硬件特定调试 API 转换为 LLDB 理解的概念,支持不同架构、寄存器、内存空间和执行模型的 CPU 与 GPU 协同调试,同时保持客户端的中立性。
 Databricks Blog4040
Databricks 发布 Unity Catalog Dataset (UCDataset) Beta 版本,通过直接从云存储流式传输 Unity Catalog 表格数据到训练作业中的每个 GPU,将推荐模型工作负载的训练时间平均缩短 10 倍。
 Hugging Face Blog4545
HOPE 方法通过考虑专家间的二阶交互,在混合专家语言模型中实现了更优的剪枝效果,50%剪枝率下在 agentic coding 任务上比次优方法提升 6.1%。该方法基于 Qwen3.5-122B 等模型验证,每个 MoE 层有 256 个专家,剪枝后可减少约 250 GB 内存占用,且与量化兼容。
Codex releases00GitHub Copilot rust-v0.169.0-alpha.4 发布,该版本包含最新功能改进和修复。
 NVIDIA Newsroom3232
NVIDIA 发布针对韩国领先开源模型的 Dynamo 优化部署方案,支持 SK Telecom A.X K2、LG AI Research K-EXAONE 2.0、Upstage Solar Open 2 和 Motif Technologies Motif-3,通过优化多 GPU 协调和通信实现高达 2 倍性能提升,加速模型生产化部署。
 OpenAI Agents SDK releases2222
OpenAI Agents SDK v0.24.0-alpha.7 发布,支持经典工作流与原生执行,新增语音和托管工具,引入持久会话存储和上下文控制。新版本默认执行策略为严格模式,需更新现有环境;捆绑模型默认推理力度提升至中等。
 腾讯混元 · Hugging Face 新模型2222
混元发布 Qwen3.8-27B-DSpine-b16 预训练模型,包含 27B 参数、b16 精度、5 层 Draft 层和 8,192 token 滑动窗口,用于推理时提升效率,需配合 Qwen3.8-27B 模型使用。
 vLLM Blog3838
vLLM 自 v0.33.0 起 发布 LibTorch ABI Stable CUDA 轮,无需重建即可升级 PyTorch。
Databricks Blog2222Databricks 通过 OpenSharing 将共享 Delta 表暴露为实时数据源,接收方使用 Structured Streaming 读取增量变更,无需本地文件追踪。
AWS Machine Learning Blog4242AWS 为解决 AI 应用中 LLM 代理访问企业数据湖的集成挑战,在 Amazon ECS Fargate 上推出无服务器 Model Context Protocol (MCP) 服务器。该服务器通过元数据驱动的方式实现配置化数据湖访问,无需为每个数据集编写集成代码,并支持多租户环境下的弹性扩展。
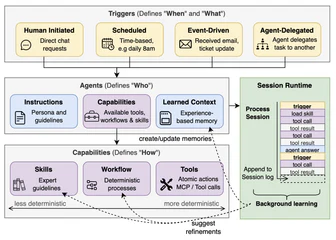
AWS Machine Learning BlogAWS Quick 将智能体工作分解为"何时"、"何事"、"何人"、"如何"四个原语,通过触发器启动任务、智能体执行并使用能力(工具、技能、工作流)完成工作。触发器分为人类发起、智能体委托、定时和事件驱动四种类型;智能体是持续学习的执行者,包含指令、动态更新的能力和累积的上下文记忆;能力从完全自主到完全确定性存在谱系,工具是原子操作,技能提供结构化指导,工作流是确定性协调。
AWS Machine Learning Blog5858Amazon SageMaker Inference 现支持 GPU 分区,通过 NVIDIA 多实例 GPU (MIG) 将物理 GPU 划分为独立分区,每个分区获得固定份额的 GPU 计算单元和专用内存块,实现隔离。部署更多模型且相互隔离,并按需选择合适大小的 GPU 单元以降低成本,最大支持每 GPU 7 个分区,无需自建 Kubernetes。
Databricks Blog3838Databricks Feature Views 通过统一定义实现实时欺诈检测模型训练与在线推理,防止数据泄露和训练-服务偏差;支持 Kafka 流实时特征计算,结合五分钟交易计数、三十天平均支出等特征,在欺诈检测应用中实现风险评分与实时交易监控。
Claude · YouTube4242Salesforce 将 Claude Code 扩展至数千名工程师,使有效产出翻倍且每行代码的 Bug 数减少。该公司工程领导与斯坦福研究人员共同构建的“有效产出”评分体系衡量 AI 编码 ROI,并通过智能体成熟度曲线引导工程师从简单提示词过渡到全自主智能体。
 Claude Code releases2222
Claude Code v2.1.319 发布,关闭遥测或功能标志时自动模式被更改,服务器端检查被禁用;在 LLM 网关后启用服务器端检查需设置 CLAUDE_CODE_AUTO_MODE_SERVER=1。
AWS Machine Learning Blog5252将 Claude Code 作为远程代理在 Amazon Bedrock AgentCore 上运行,每个任务在 AWS 账户内隔离的 AgentCore 运行时中执行。
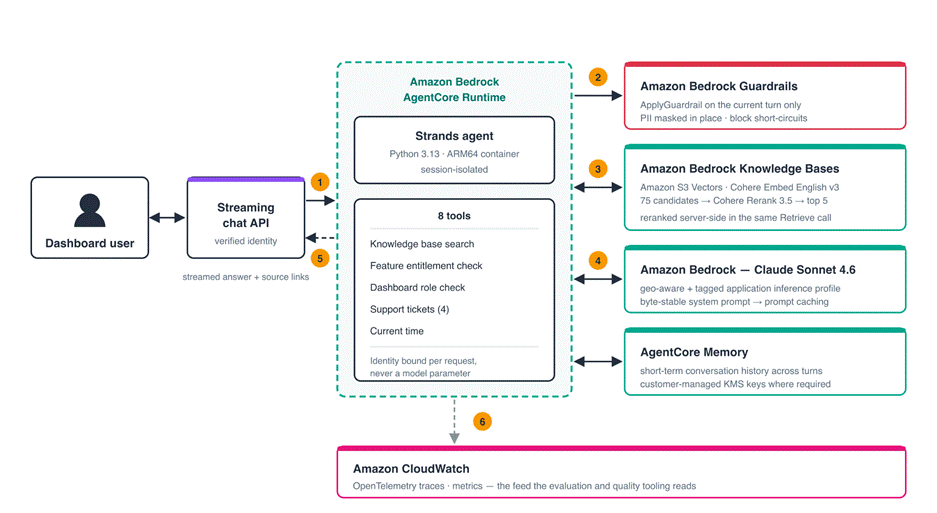
AWS Machine Learning Blog3838Taxbit Assist 嵌入 Taxbit 仪表盘,通过 Amazon Bedrock AgentCore 运行,需用户身份验证。智能体检索 Amazon Bedrock 知识库中的候选段落并服务器端重排,回答需有来源佐证且符合角色权限,不提供税务建议。AgentCore 内存管理对话状态,支持区域数据驻留,符合 ISO/IEC 42001 标准。
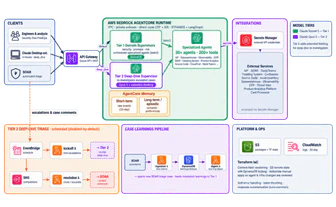
AWS Machine Learning Blog3838Greenlight Financial 每月自主处理超过 90% 的 4,000 个安全风险案例。其解决方案 Luna 使用 Amazon Bedrock AgentCore 运行,包含 30 多个专业智能体,通过 AgentCore 运行时和内存支持分层多智能体系统,实现秒级安全事件分诊,无需人工干预。
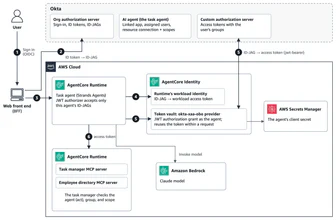
AWS Machine Learning Blog4848Okta Cross App Access 在身份提供商中管理 AI 代理的访问权限,Amazon Bedrock AgentCore 则在执行层面验证和转换授权决策。
NVIDIA Newsroom3838NVIDIA的开源Aerial和Sionna软件使全球开发者采用量增长10倍、下载量超100万次,被8000多个研究机构使用,支持目标语义通信使机器人任务完成时间缩短52.6%、AI接收器在干扰环境下提升60%上行吞吐量、需求预测系统降低45.6% RAN功耗、GPU加速模拟将仿真时间从3小时压缩至10-20分钟。
vLLM Blog精选7272NVIDIA Research 与 Inferact 的 REINFORCE Zero 提出先对齐 rollout 与训练 kernel,再用不裁剪的 token 级重要性采样修正权重滞后,在 16 张 GPU、12K 次更新下训练步吞吐为同步训练的 2.40 倍。
推荐理由: 论文把异步 RL 的 rollout 与训练差距拆成权重滞后和 kernel 不一致两项,并给出对齐后免裁剪重要性采样的做法。
Hugging Face Blog5858Hugging Face 发布 ToyBlocks 框架,为机器人学习与评估提供受控的模拟环境。该框架支持自动生成任务与训练演示,并包含衡量机器人行为随时间变化的指标,旨在研究模型如何随更多训练数据改进,以及如何结合高级推理与精确物理控制。
 ByteDance Seed · Hugging Face 新模型
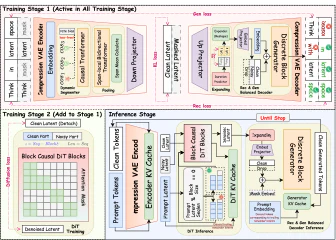
Cola2 是一个连续潜语言模型,结合动态压缩 VAE、块因果扩散 Transformer (DiT) 和跨段因果 token 解码器,动态将文本分组为语义片段,用紧凑的连续潜表示每个片段,生成潜块并实现为离散 token。
Codex releases00GitHub Copilot rust-v0.169.0-alpha.1 发布,该版本提供代码审查、协作等功能。
OpenAI NewsCult.fit 正在运用 Codex 协助跨部门团队构建工具、加速工作流程并改变工作方式。