AWS Machine Learning Blog3232
Amazon Quick 整合结构化与非结构化数据。
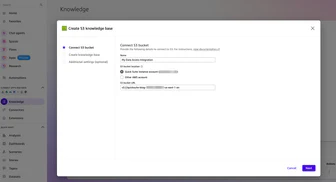
Amazon Quick 通过连接 Amazon S3 和创建知识库整合结构化与非结构化数据,用户可使用单一对话式 AI 代理查询。该解决方案包含数据层(存储在 S3 的非结构化内容和作为语义数据集的结构化数据)、工作空间层(将数据类型整合到单一工作空间)和代理层(自定义聊天代理链接到工作空间并返回组合响应)。
AWS Machine Learning Blog3232Amazon Quick 通过连接 Amazon S3 和创建知识库整合结构化与非结构化数据,用户可使用单一对话式 AI 代理查询。该解决方案包含数据层(存储在 S3 的非结构化内容和作为语义数据集的结构化数据)、工作空间层(将数据类型整合到单一工作空间)和代理层(自定义聊天代理链接到工作空间并返回组合响应)。
 PyTorch Blog
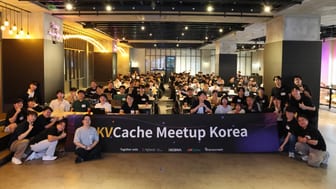
PyTorchKR 与 XCENA 于 2026 年 9 月 30 日联合举办 KVCache Meetup Korea,XCENA、SK hynix、FuriosaAI 和 LMCache 的演讲者分享了 LLM 推理及 KV 缓存优化的成果。
 Ai2 Blog
StateBench 是一个用于测试大语言模型追踪长文档中实体状态变化的基准,包含 R-trivial、非周期、可解和一般有限四个难度等级。研究发现,循环和混合模型在直接训练这些任务时泛化能力远超 Transformer,而 Gemini 3.8 Flash、Claude Opus 5.5 和 GPT-6 Sol 等前沿模型在输入变长时仍难以处理更复杂的状态追踪问题。
 Databricks Blog
Lakebase Postgres 在 Google Cloud 上正式发布,支持无服务器 Postgres 运行于 Databricks 数据与 AI 平台。
PyTorch Blog3434Ray 宣布加速器特殊兴趣小组(SIG),旨在联合硬件厂商、Ray 贡献者和应用开发者,制定中立的加速器支持路线图。初期聚焦开发测试基础设施、硬件感知能力和网络传输,优先支持共享硬件访问、可复现的开发测试环境及更广泛的 CI 覆盖。
Databricks Blog5858Databricks Lakebase 通过其基于复制-on-write 的数据库分支功能,将每个 PR 分支的创建时间缩短至秒级,支持峰值约 100 个并发分支,每分支独立读写,兼容标准 Postgres 并支持大型 JSONB/LOB 列,满足 Snorkel AI 在 CI/CD 流程中快速、安全、低成本地测试生产数据的需求。
 Microsoft Research4040
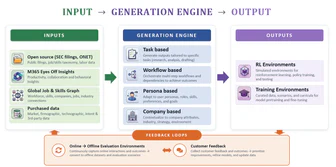
Microsoft Research 开源了产业评估数据生成平台,通过基于 O*NET 职业数据、在线招聘和 SEC 文件的合成企业环境,模拟真实业务流程测试 Copilot AI,确保评估不接触客户数据且符合安全隐私标准。该平台包含自动化查询生成管道和结构化质量框架,支持制药、资本市场和 IT 软件等行业的真实场景测试。
Databricks Blog4747Databricks 宣布 Spark Declarative Pipelines Real-Time Mode 正式可用,该模式通过持续流式处理、并行查询阶段和即时数据传递实现毫秒级端到端延迟。
 Hugging Face Blog
Project ProtoStar 项目发布,旨在通过使数据集、模型和代码更易获取和复用,解锁公共资助科学研究的潜力。该项目汇集了大学、研究机构、产业和开放科学社区,支持以 AI 兼容、机器可操作的格式发布科学成果,并通过一系列公开挑战展示其价值。首个挑战由卡内基梅隆大学主办,将于 11 月 2 日启动。
Hugging Face BlogHugging Face 发布 Granite Switch 4.1.1,在 4.1 基础上增量更新,保留完全向后兼容性。新增多语言语音转写模型(支持 10 种语言带原生标点)和 Jev 决策指数测试集性能提升的决策适配器。团队通过仅更新适配器未重新计算基础模型,实现快速部署,未来将支持第三方自定义适配器。
Databricks BlogProcore 通过 OpenSharing 将连接后的建筑数据以程序化方式共享至客户现有环境,支持 Power BI、Tableau、Snowflake、BigQuery、Databricks 工作空间或本地 SQL Server,用于报告和下游分析。
 Anthropic Newsroom
Anthropic 扩展 AI for Science 项目,向全球 20 家科研机构、基金会和研究中心提供免费 Claude 信用额度,支持高影响力科学项目研究。
 LangChain Blog
OpenWiki 使智能体在需要跨来源连接的问题上准确率比单独搜索高约 5 倍,添加证据图将准确率再提高 27% 并使引用一致性翻倍。
Databricks BlogDatabricks Lakehouse Federation允许用户通过标准SQL直接查询外部数据库(如SQL Server、PostgreSQL等)中的数据,无需迁移。
Databricks Blog4545Databricks Vital Skills 通过开源 Agent Skills 标准为 Genie Code 增强医疗健康与生命科学领域知识,使其在 BiomniBench 基准测试中得分提升。
AWS Machine Learning Blog3434Property Finder 在迁移视觉 AI 工作负载至 Amazon Bedrock 时发现其评估数据集 96.8% 的标签来自单一模型的预测而非人工验证,导致新模型客观比较受阻。该公司通过人工专家独立标注 356 张图像构建可信基准数据集,并采用进化式提示优化迭代 27 次后,在保持 86% 准确率的同时将成本降低 86%。
Hugging Face BlogHugging Face 发布 Old Ideas, Novel Problems 研究,评估六款 LLM(GPT-5.1至5.4、Claude Sonnet 4.5至4.6)判断科研创新性的可靠性。
 NVIDIA Blog
C-BRAIN 与 NVIDIA 正利用 AI 改变痴呆症研究进程。他们通过整合此前未公开的阿尔茨海默症研究数据,包括未发表结果和受管制的专有数据,加速新疗法研发。C-BRAIN 运用混合集中式和联邦式架构保护数据隐私,部署 64 块 NVIDIA 数据中心 GPU 及云端节点,并计划引入 NVIDIA Blackwell 系统以支持其扩展目标。
Ai2 BlogAi2 发布 Old Ideas, Novel Problems 研究,评估六款 LLM(GPT-5.1至5.4、Claude Sonnet 4.5至4.6)判断科研创新性的可靠性,发现微调提示词可致准确率差异超 50%。研究构建包含 154 人类原创及 154 AI 生成科研想法的基准数据集,证实模型判断稳定性不足,需更可靠方法评估 AI 提出的新想法。
 蚂蚁 inclusionAI · Hugging Face 新模型5858
SingProbe 是一个基于 Qwen/Qwen3.8-Flash-Next 的流式安全探针,通过复用基础模型的隐藏状态在生成时每一步评分查询意图、响应不安全性和幻觉风险,解码时开销不到 0.5%。
蚂蚁 inclusionAI · Hugging Face 新模型3838inclusionAI/Ling-3.0-flash-Sante-fp8 发布 FP8量化版本,保留124B参数(5.1B/Token)与BF16性能,降低内存并提升部署效率,支持医疗推理、研究及工具辅助工作流,需专业人工审核。在Healthbench、ReDisQA等基准上表现稳定,通过块状FP8量化(128×128块)实现高效推理。
Databricks BlogLakeflow Connect 通过原生连接器支持维基、项目管理工具和 AI 基础模型,使下游 AI 智能体获得完整业务上下文。该平台提供全面管理的原生连接器,支持 SaaS 应用、数据库和文件源,数据直接导入 Databricks 平台,通过点选式 UI 或 API 配置,增量导入 Unity Catalog 表格。
Databricks BlogDatabricks AI Search 现在原生支持使用 Iceberg v3+ 的 Streaming Tables、Materialized Views 和 Managed tables,除 Delta 表外。
Databricks Blog2222Databricks Free Edition 允许师生免费在浏览器中运行完整数据或 AI 课程,无需云合同或许可证管理,适用于全球学生和教育工作者。该平台提供协作笔记本、Spark、Delta Lake、Lakeflow、Databricks SQL、Genie 代码助手等功能,支持从入门编程到 AI 项目的各类课程,技能直接应用于行业标准工具,无生产环境与教学沙箱的转换成本。
 OpenAI News4040
OpenAI 分析了 ChatGPT 在近 100 个国家的 165 项工作活动中的使用数据,揭示了人们如何使用 ChatGPT 进行工作以及使用情况随时间的变化。
 vLLM Blog精选6262
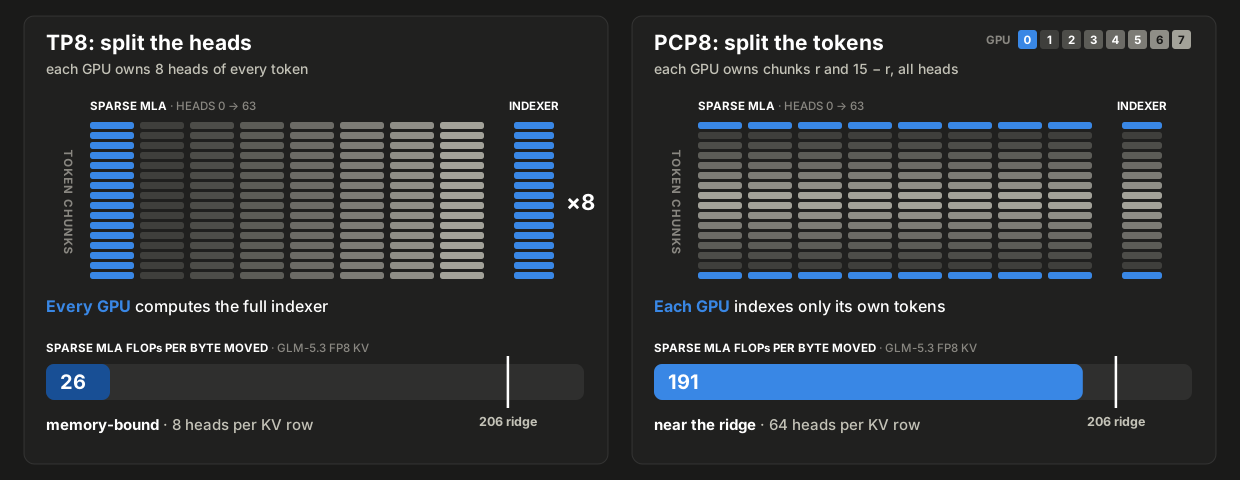
vLLM 团队发布 GLM-5.3 优化第二部分,在 16 张 H200 上以 1 个预填节点加 1 个解码节点部署,用 PCP 按 token 切分预填、DCP 按 token 切分 KV cache,使 1M 上下文可放入预填节点
推荐理由: vLLM 团队拆解了 PCP、DCP 与 Hybrid HiSparse 如何在 16 张 H200 上组合,读者可据此理解长上下文部署的内存与预填瓶颈。
Databricks Blog2222Databricks 通过整合 Spark Structured Streaming 实时模式、Lakebase Postgres 和 Databricks 应用程序
Databricks Blog5858Spark的声明式管道在22项数据工程任务中比过程式管道快34倍、代码量减半且错误更少。声明式管道通过运行前验证可提前捕获结构性错误,并将排序和结果保存等重复性任务卸载给Spark,而过程式管道需在集群上运行至错误步骤才能发现。两种方法在逻辑错误率上表现相当,但声明式管道的代码更简洁一致,便于维护。
Hugging Face BlogHugging Face 发布 torch-neuronx 模型支持查询 Space,检测 AWS Trainium 兼容性。该 Space 支持查询 Hugging Face Hub 上 175B 参数规模的主流模型(如 Qwen3-0.6B)是否能在 Trainium 上无修改运行,并提供运行脚本。
 Sakana AI
 发布 AI 智能体构建、执行、运行平台 Sakana Aquarium,通过本体论整合组织信息,支持 AI 智能体高效构建与安全运行。平台包含本体论、治理和智能体执行基座三核心机制,实现组织判断依据体系化与任务自动化。
Hugging Face Blog精选6666微软与 Hugging Face 发布 ThinkingBox-Training,把 ThinkingBox 对数据库终态的确定性校验直接当作强化学习奖励,用 GRPO 对 Qwen3.8-27B 训练 50 步。
推荐理由: 微软与 Hugging Face 把数据库终态校验直接当作强化学习奖励,并公开了任务筛选与训练代码,可迁移到其他有状态智能体训练。
Databricks Blog精选6060Databricks 高管 Patrick 复盘公司全面采用 AI 编码智能体后成本指数级上升、再通过控制层把单位成本最多降低 90% 的过程。他提到把流量迁到更便宜的新模型贡献了 50% 以上降幅,Smart Router 在接近最贵模型质量下把平均任务成本降低 30% 以上。这套内部方案后来产品化为 Unity Gateway,目前已有数千家客户使用。
推荐理由: Databricks 高管复盘自家 AI 编码成本从失控到单位成本降九成的过程,给出网关、路由与自建评测的可迁移做法。
Microsoft Research5858Flint-interactive 使 AI 生成的图表具有丰富的交互性,用户可通过点击、筛选、缩放、高亮和跨图表交互来探索数据。它通过高级语义事件和更新操作简化复杂交互的构建,并利用 Flint 编译器处理交互逻辑和视觉依赖,提高可靠性和开发效率。Flint-interactive 支持创建交互式数据故事、仪表板和连接体验,AI 代理可使用其生成带交互功能的图表,帮助用户更高效地分析数据。
 Google DeepMind
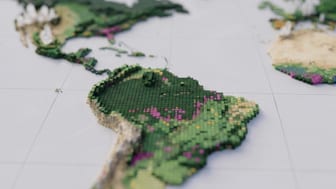
 与 Google Research 联合发布 Forest Typology (ForTy) 2020 全球地图,将地球每 10x10 米土地分类为六种森林和土地利用类型,并追踪 2017-2025 年变化。该地图基于联合国粮农组织定义,准确区分原生林、人工林、单一物种林浆、经济作物林和其它土地,支持欧盟防砍伐法规,准确率达 90%。
NVIDIA Blog企业正使用 NVIDIA DSX AI 工厂平台整合电网与 AI 工厂系统,从变电站到机架进行规划、模拟和运行,以解决电力成为基础设施最大瓶颈的问题。
NVIDIA BlogNVIDIA 扩展 Cosmos 平台,新增训练工具、模拟检查点和 Cosmos Data Factory 蓝图,帮助开发者快速构建世界模型。Cosmos Data Factory 提供 5 个云原生蓝图,通过 GitHub、Azure 等渠道支持自动驾驶数据生成、图像属性增强等任务,Porsche 和 ANYbotics 已应用以加速物理 AI 开发。
Hugging Face Blog精选7878NVIDIA 发布预训练关系型基础模型 Kumo Relational,可直接在企业数据库上做预测,无需任务特定训练、特征工程或表展平。模型在 15 个数据库的 41 个任务上超过监督式关系深度学习和专家特征工程梯度提升树,在 SAP SALT 基准上 MRR 比 AutoGluon 集成高 8%。
推荐理由: 原文给出预训练关系模型在 41 个任务上的对比结果与开源入口,读者可据此判断它能否替代现有 XGBoost 流水线。
Hugging Face BlogQwen3-4B的专精词汇表VocabX通过聚焦每个token的成本而非频率,在不改变基础模型的情况下将推理成本降低77%。该方法针对葡萄牙语作文评分器,将输出层词汇表从约152,000行缩减至约65,000行,显著减少token分割和未使用词汇项的计算开销。
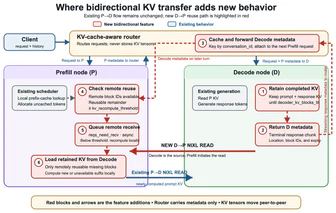
AWS Machine Learning Blog5858vLLM 的双向 KV 传输机制通过让解码节点在后续对话回合中返回先前计算的 KV 缓存给预填充节点,减少了重复计算,在 AWS EC2 P5en 实例上的多轮基准测试中将 Qwen3-32B 的 TTFT 提升了 1.6 倍,zai-org/GLM-5-FP8 提升了 3.3 倍。该功能通过扩展 NIXL KV 连接器实现,并利用 KV 缓存感知路由器协调跨对话回合的 KV 重用。
AWS Machine Learning Blog3232Deepgram 通过 AWS Trainium2 将 Nova-3 语音识别模型部署到 PyTorch,在单个 trn2.3xlarge 实例上运行 8 个副本,处理离线批处理工作负载时每美元可处理 11-70% 更多音频,并使用 NKI 库和 Neuron Explorer/NAD 工具链进行内核级调优,提升推理效率。