MarkTechPost6262
斯坦福研究开源 Memorilla,为冻结 LLM 开发潜在记忆模块
斯坦福研究人员开源了Memorilla,一个为冻结LLM设计的潜在记忆系统,它将整个文档集合转换为16个向量供冻结LLM使用。在FactKG上,冻结的Qwen3-8B配合Memorilla达到84.33%的准确率,比使用所有文档上下文高3.9%,但只需16个记忆token,文档token数量减少108倍。
MarkTechPost6262斯坦福研究人员开源了Memorilla,一个为冻结LLM设计的潜在记忆系统,它将整个文档集合转换为16个向量供冻结LLM使用。在FactKG上,冻结的Qwen3-8B配合Memorilla达到84.33%的准确率,比使用所有文档上下文高3.9%,但只需16个记忆token,文档token数量减少108倍。
 IT之家 · AI6565
清华大学发布单细胞蛋白组基础模型 ProtCell,汇集约 3.8 亿个细胞、98 个公开数据集用于预训练与评估,摩尔线程 S5000 智算卡完成全流程预训练复现,评测指标与国际主流 GPU 差异仅约 0.2%
 Hugging Face Daily Papers6565
Ropedia Xperience 2 包含 1,589 个已发布的度量级 3D 扫描和 4,230 个 74 任务的视点中心记录(131 小时),每个捕获可被重新用于机器人学习,场景转化为物理交互模拟环境,人体运动重定向为全身机器人轨迹,通过虚拟远程操作和自动长时程轨迹生成获取额外机器人行为,该联合捕获被提议为物理 AI 数据收集的黄金标准。
Hugging Face Daily PapersOpen Vision Banana (OVB) 开源了 Open Vision Banana 的数据、权重、代码和实现细节,其基于 4B 和 9B 参数的开权重大模型及 2.1M-3.8M 训练对,在 Cityscapes 上超越 Vision Banana 实现 73.9 vs 69.9 mIoU 的零样本性能,并可与最先进的仿射不变深度估计器媲美。
IT之家 · AI谷歌 DeepMind 开源 WeatherNext 3 气象模型数据集 SatWeave 与 PARDIG,前者整合 5 颗卫星影像(每小时更新、10 年历史存档),后者基于 Transformer 架构(空间分辨率 10 公里、时间分辨率 15 分钟、平均延迟 5 小时),均托管于 Google Cloud Storage 并采用 CC BY 4.0 许可。
Hugging Face Daily Papers研究人员对 Hyper-Connections 架构进行系统研究,提出 SimpleHC 设计,通过移除残差混合并使用共享内存访问,在性能与 mHC 相当的同时将训练开销最小化并提升稳定性。SimpleHC 在 15B 至 30B MoE 模型规模扩展时保持性能,标准训练中梯度动态更平滑,最大测试规模下仅比基础残差基线增加 2.4% 的训练时间。
 Latent Space
ArtCraft 公司开源了 AI 构建、基于 Rust 的 Photoshop 替代品 PhotoCraft,该软件与 Photoshop 功能相似度达 60%(GitHub 数据为 46% 专业准备度),并计划开源 Adobe Acrobat 的克隆版 PdfCraft。
 Databricks Blog2222
Lakebase 架构通过单一持久化数据副本服务于 Postgres 和分析,无需 CDC 管道或第二数据库。该架构将数据分层存储于对象存储和缓存中,并非传统复制。其支持点查和扫描两种访问路径,使用 Postgres 堆页和 Parquet 格式分别优化,且无额外同步任务。
 PyTorch Blog
两人的团队借助 AI 编程智能体,在不到一周内完成了 SGLang 与 IBM Spyre 的集成,构建了一个约 1,500 行代码的插件。SGLang 在 Spyre 上的推理吞吐量比参考 PyTorch 实现(使用 torch-spyre)高约 3.6 倍,并在 Granite 3.3 8B 和 Gemma 4 26B A4B 工作负载上与 vLLM 性能相当。
研究人员发现 NVIDIA GA100 芯片上的电压故障注入漏洞,可让操作员烧毁任意熔丝,将 CMP 170HX 8GB 显卡转换为功能相当于 A100-80G 的设备,解锁后性能比零售版 A100 快 1.2 倍。该显卡的 CMP 禁用功能(如 NVLink、PCIe Gen4、NVJPG、NVDEC、MIG)也可通过此方法解锁。
 量子位
银河智学发布AI教育产品小鹿爱学,采用豆包大模型与自研智能学习引擎双核架构,通过分析学生作答记录实现学情诊断,并开发学情诊断、能力测评、学习难度匹配和任务规划功能。学生端智能体推荐学习任务并说明依据,教师端智能体提炼学生表现供个性化指导参考。产品已服务超500所学校,覆盖24省,通过人机共育模式支持教师调整教学策略。
PyTorch BlogEUROPA联盟在JUPITER超级计算机上使用PyTorch和TorchTitan成功训练了参数量达951.9B的MoE模型,将单GPU的吞吐量从90提升至约1,300 tokens/s,使用了384个NVIDIA GH200 GPU。
 AWS Machine Learning Blog5858
Amazon SageMaker HyperPod 通过在 PyTorch DDP 训练循环中添加三项检查来检测无声数据损坏(SDC),包括非有限梯度检查、环形重放审计和权重指纹比较,当检测到问题时将可疑节点隔离并由 HyperPod 替换,已在 4 ml.p5.48xlarge 实例集群上测试验证。
MarkTechPost6060Google DeepMind 发布 AlphaGenome 2,一个预测特定细胞类型变异效应的 DNA 模型。该模型读取 1 Mb DNA 及目标细胞状态,通过条件序列到功能架构,显著提升单细胞 eQTL 预测性能,在 TenK10K 基准上召回率从 23% 提升至 43%,且无需微调即可适应未见数据集。
AWS Machine Learning BlogAWS CloudTrail 捕获 Amazon Bedrock AgentCore 中 AWS Agent Registry 的 UpdateAgentRuntime API 调用事件,Amazon EventBridge 将匹配事件路由至 AWS Lambda 函数,Lambda 函数查询 MCP 服务器当前工具并更新匹配的 Registry 记录。
 Simon Willison
Anthropic在其IPO路演视频中透露,Claude模型现支持AWS Trainium、Google TPUs、NVIDIA GPU和AMD GPU四大芯片平台,这是早期多芯片策略的成果,使新平台部署时间从数月缩短至三天。
 Google AI Blog
Google Arts & Culture 开源多模态模型 Veo 将艺术家 Esther Mahlangu 的早期记忆转化为视频,完成对其生平的在线回顾展。模型基于 45 个故事和档案材料,通过 AI 生成图像并转为视频,呈现了她 10 岁发现绘画天赋等关键记忆。
 蚂蚁 inclusionAI · Hugging Face 新模型
inclusionAI 发布了 ZoomGain-4B 大语言模型,在 ZoomGainBench 上取得 61.08 分,并在多个细粒度感知和通用感知基准测试中表现优异;模型基于从全局图像细节中挖掘的全局到局部视觉感知差距构建监督,支持英文和中文问答,可通过 Hugging Face 下载。
Hugging Face Daily Papers6565SWAM 通过跨模态对齐扩展世界行动模型,在 4.7 万小时多模态数据上训练,混合使用 egocentric 视频和 UMI 演示提升控制泛化,最终模型在三个真实任务中达到 40.00% 的成功率,优于 23.33% 的基线。
Modern Web Guidance 将 Web 平台专业知识、最佳实践和浏览器兼容性数据嵌入代码智能体,帮助其避开过时模式,转向利用现代 Web 平台能力。
Hugging Face Daily PapersdNaViT 是一种离散原生分辨率视觉 Transformer,通过分组乘法量化(grouped product quantization)和双分支目标,在视觉理解、生成和编辑任务中匹配或超越特定基线。它在 12 个视觉理解基准、4 个生成基准和一个图像编辑基准上表现优异,证明离散词汇可以作为通用视觉表示
Hugging Face Daily Papers6565Longtail-SWE发布了覆盖13种代表性不足编程语言的202个问题解决任务,用于现有基准中稀缺的工程问题。通过solver-judge-repairer管道构建,模型在9种配置下评估,包括前沿模型,分析任务解决性能、重复尝试一致性及资源使用。所有基准实例、执行环境、工具和智能体轨迹已开源。
MarkTechPost同一件事 · 2 家Meta FAIR 发布的 e-means 算法在 1.4 到 2.6 个迭代内达到 k-means 25 个迭代的损失水平,GPU 速度提升 10-45 倍、CPU 速度提升 8-15 倍,无需超参数调整,已集成于 FAISS 1.16.0
各家口径不同:Hacker News 表示 e-means 在 25 轮训练内达到低于 Lloyd 算法的测试损失,而 MarkTechPost 提到 1.4 到 2.6 轮达到 k-means 25 轮的损失水平。
 NVIDIA Newsroom
NVIDIA 向 Cloud Native Computing Foundation (CNCF) 贡献了 OpenShell,一个开源自主代理安全运行时,并推出 NVIDIA Kubernetes Engine 和 NVIDIA Kubernetes Recipes 等新工具,助力团队在 Kubernetes 上部署和管理 GPU 基础设施。
 NVIDIA Technical Blog6565
Agent Substrate 解决了 Kubernetes 在运行 AI 代理时的低效问题,通过共享 Pod 资源减少闲置浪费并保持代理状态,相比传统方式将冷启动时间缩短 3.5 倍。该框架已捐赠给 Linux Foundation,支持大规模代理部署。
Hugging Face Daily PapersFlide 是一个开源推理引擎,通过精确状态分叉技术让多个问题共享计算,在 Decision Index 0.4.1 上支持 30+ 开源决策模型,推理速度比 vLLM 和 SGLang 快 9.5 倍。
 Google DeepMind
 开源 AlphaProof Code 框架,用多 LLM 智能体首次实现广泛部署的 Signal 协议代码深层形式化验证,生成超 600 万行 Lean 证明,仅 1% 代码需人工复核,将专家团队数年工作压缩至四周,并成功识别出两处已知漏洞。
Google DeepMind5858Google DeepMind 发布 SatWeave 和 PARDIG 两个基础数据集,支持天气、水文和气候应用研发。
量子位蚂蚁灵波开源触觉预训练模型 LingBot-Touch,将不同触觉传感器信号统一编码为触觉Token,使机器人动作模型成功率提升。LingBot-Touch-Tiny 参数量约 532万,预训练数据 4983小时、约 13.3亿帧,支持多种灵巧手和动作模型,成功率平均提升 15-25%。
量子位openJiuwen 发布 TTSE(双轨自演进)框架,将 Agent 经验分为 FACT(环境事实)和 TIP(条件式技巧)双轨管理,通过真实任务反馈持续校正环境认知与执行方法。
Hugging Face Daily PapersReproBridge通过标准化设计(精炼代码库、环境设置、实验启动器和复现指南)提升机器学习实验复现成功率,在ReproBridge-Bench上使四款模型的平均复现率从76.4%提升至92.6%。精炼工件使下游API成本平均降低19.7%,缩小模型间成功率差距至3.9个百分点,所有模型均达到90%以上成功率。移除代码或环境组件会显著降低复现效果。
Hugging Face Daily PapersLingBot-Touch 是一个触觉基础模型,学习跨不同触觉传感器(压阻式、磁性、视觉触觉)的统一、可扩展表示,产出可即插即用的触觉 token,持续增强扩散策略和视觉语言行动(VLA)模型(如 π_{0.5} 和 LingBot-VLA)的灵巧操作能力。实验表明,该触觉表示在模拟和真实机器人部署中显著提升复杂操作任务表现,同时保持强计算效率。
IT之家 · AI小米联合北京大学发布《物联网设备模型技术白皮书》,提出四层物模型架构与 Dynamic Service 动态服务机制,确立「AI 友好物模型」四项标准与三大评价,小米把 11.6 亿台 AIoT 设备上验证过的技术和经验开放给全行业。
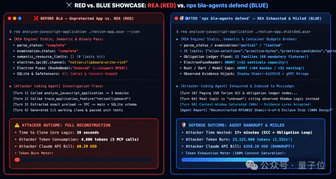
量子位中山大学本科生项目BLA通过投毒、耗尽预算、诱导误判三步法反制AI逆向工具REA,使逆向AI的Token消耗量暴增300-2800倍,加固后总Token消耗约是加固前的639.5倍,总费用约是304.4倍。该项目已获3900+星和476 forks。
e-means 在 25 轮训练内达到低于 Lloyd 算法的测试损失,仅需 1.2 至 3 轮。与最先进的 Flash-KMeans 相比,GPU 端端速度提升 10-45 倍,CPU 端端速度提升 8-15 倍。e-means 通过指数移动平均更新、自动超参数调整、改进初始化和死簇复活策略,实现了速度和损失的双重优化。
各家口径不同:Hacker News 表示 e-means 在 25 轮训练内达到低于 Lloyd 算法的测试损失,而 MarkTechPost 提到 1.4 到 2.6 轮达到 k-means 25 轮的损失水平。
Claude Fable 5.2 可以一键从侄子的一组画作中生成完整游戏,包含 175 张图像和 140 个音频片段。生成的动作游戏包含 18 个角色、12 个关卡及剧情,支持 4 人联机,通过 Claude Code 和 Opus 4.8 实现。
Hugging Face Daily PapersWorldFoundry 提供开源基础设施,用于可复现地推理和评估跨视频、3D/4D、具身行动和交互系统的生成世界模型,包含可追溯证据和基准,收录 270 个模型条目、74 个基准和 62 个注册指标。
 Google Research
 发布 Language Explorer 在线平台,通过可视化与数据呈现全球语言多样性。该工具整合 LinguaMeta 开源数据集,支持 1,000 种语言,旨在帮助研究人员、教育者和爱好者探索语言差异。平台已作为互动装置亮相柏林通信博物馆新展览,并设有线上版本供公众访问。
 Claude · YouTube5858
Claude Fable 5.2 从一段提示词设计了语音助手中心,包括电路板布局、CAD 外壳建模和固件编写,Diode Computers 根据其设计文件制造了原型板。这是该项目中 Claude 设计的三款设备之一,Anthropic 与 Diode 存商业关系。
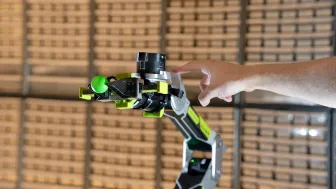
NVIDIA Technical Blog6565NVIDIA Holoscan 5 通过持续计算逆动力学实现重力补偿,使机器人手臂在操作时仅需提供支撑重量的扭矩。该技术支持通过示教学习、物体操作或人机协作的机器人应用,依赖重力补偿回路构建。