量子位精选同一件事 · 2 家8282
MiniMax开源图像模型H3-Image:原生4K、支持16张参考图
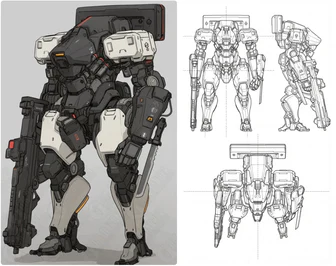
MiniMax开源图像模型H3-Image支持原生4K(4096×4096像素)生成,最多可输入16张参考图。作者实测其能根据产品外观图推演正交三视图和机械爆炸图,并在人脸毛孔、雀斑等细节上减少塑料感。API价格为主流竞品的50%到70%,首周16MP请求再打五折。
同一件事 · 2 家
量子位精选同一件事 · 2 家8282MiniMax开源图像模型H3-Image支持原生4K(4096×4096像素)生成,最多可输入16张参考图。作者实测其能根据产品外观图推演正交三视图和机械爆炸图,并在人脸毛孔、雀斑等细节上减少塑料感。API价格为主流竞品的50%到70%,首周16MP请求再打五折。
 MiniMax News精选同一件事 · 2 家8080
MiniMax 发布了基于 H3 的开源权重图像生成模型 H3-Image,支持文生图、参考图生成和图像编辑,可在 10 秒内生成 4096 × 4096 的 4K 图像,最多支持 16 张参考图。
推荐理由: 官方给出 4K 生成速度、参考图数量和定价区间,可据此判断开源图像模型与闭源方案的差距。
 MiniMax · Hugging Face 新模型
MiniMax-H3-Image-PE 通过提示扩展(PE)将简短请求转换为详细图像描述并推荐宽高比。它支持文本到图像(T2I)和图像编辑两种工作流程,使用微调自 Qwen3.8-27B 的 FP4 权重。在线 API 可通过 platform.minimax.io 或 platform.minimax.cn 访问,文档提供中英文支持。
MiniMax · Hugging Face 新模型MiniMax-H3-Image 是 MiniMax H3 家族的一款开源图像生成与编辑模型,支持 16MP 图像生成、图像编辑及最多 16 张参考图像,采用 H3 架构并使用 Qwen3-VL 文本编码器,在 Hugging Face 上提供 68.65GB 的 BF16 精度模型权重。
MiniMax NewsMiniMax 发布 H3 模型,支持文本、图像、视频和音频的统一上下文理解,能生成带原生立体声的 2K 分辨率视频(最长 15 秒)。
MiniMax · Hugging Face 新模型MiniMax-H3 是一个通用多模态生成系统,支持统一理解文本、图像、视频和音频,能生成最高 2K 分辨率、最长 15 秒的带立体声音频的视频。其 H3-Context-IR 模块用于深度理解输入指令并转化为 H3-Base 可理解的中间表示,但未开源。H3-Base 和 H3-Regenerate-2K 模块分别负责 768p 和 2K 分辨率的音频视频生成,前者开源,后者需 API 调用。
 MarkTechPost
Elo排名显示Alibaba Wan 3.0(1175 T2V Elo)居首,每秒价格0.20美元;Utopai X(1170 T2V Elo)并列第二但无API;MiniMax H3(1161 T2V Elo)为首个开源视频模型,每秒0.08美元,但受地域限制。排名依据盲测人类偏好,结合每秒API价格与权重许可状态。
 蚂蚁 inclusionAI · Hugging Face 新模型
inclusionAI 发布 Duo 1.0 causal-base 模型,这是一个用于实时音视频交互的全双工多模态世界模型,包含实现权重和主干、意图模型和适配器、音视频编解码器、语音识别器和强制对齐器。该模型权重基于 MiniMax H3 初始化,并已开源。
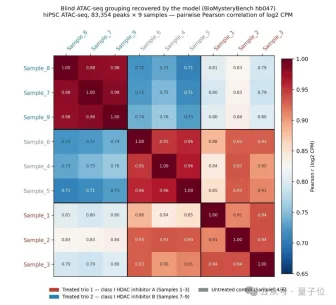
量子位无界前沿开源生物信息大模型Fx-Bio-1031,在BioMysteryBench基准测试中,困难子集Pass@5达到70.59%,大幅领先GPT-6-Astra(47.06%)和Claude Opus-5(52.94%)。Fx-Bio-1031采用125B参数的高效MoE架构,支持本地化部署,适用于药物研发、多组学分析等场景。
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI 发布 Duo 1.2 causal-base 模型,这是一个用于实时音视频交互的全双工多模态世界模型,包含改进的生成质量,模型权重可在 Hugging Face 下载。
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI 发布 Duo-1.0-distill,一个用于实时音视频交互的全双工多模态世界模型,包含四步蒸馏的 Realization 权重,需与 causal-base 套件叠加使用。
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI 发布 FP8-量化四步蒸馏的 Duo 1.0 Realization 权重,用于其因果基础模型,支持全双工实时音视频交互,需与因果基础模型权重叠加使用。
MarkTechPost精选同一件事 · 3 家7171Thinking Machines Lab 发布第二代 Inkling 的首个模型 Inkling 2 Small,为 594B 总参数、17B 激活参数的稀疏 MoE,支持文本与图像输入和可变推理强度,上下文 1M token。