Google DeepMind 发布 Gemini Robotics 2.5 视觉-语言-动作模型
谷歌 DeepMind 发布了 Gemini Robotics 2.5,称其为目前能力最强的视觉-语言-动作(VLA)模型,在 200 项任务上相比此前基线成功率提升 30% 至 100%,完成任务速度快 20% 至 30%。
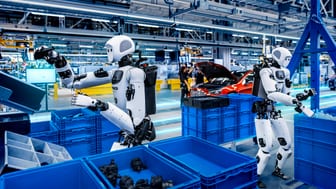
推荐理由: 官方披露了 200 项任务评测与奔驰产线 96% 成功率的实测数据,可据此判断 VLA 模型在真实工业场景的落地程度。
今天最值得读的 AI 新闻,来自正在塑造 AI 的实验室、创业公司和研究者。
谷歌 DeepMind 发布了 Gemini Robotics 2.5,称其为目前能力最强的视觉-语言-动作(VLA)模型,在 200 项任务上相比此前基线成功率提升 30% 至 100%,完成任务速度快 20% 至 30%。
推荐理由: 官方披露了 200 项任务评测与奔驰产线 96% 成功率的实测数据,可据此判断 VLA 模型在真实工业场景的落地程度。
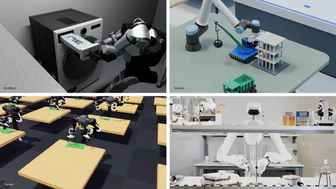
NVIDIA 在 CoRL 上发布开源世界动作模型 GR00T 2,基于 NVIDIA Cosmos 构建,使用 10 万小时 NVIDIA 开源人类第一视角数据训练,可在无任务专属演示的情况下完成 50 项评测任务中的 40 项。
推荐理由: 原文给出 GR00T 2 在少样本任务上的成功率与 Isaac Lab 3.0 的训练吞吐提升,可据此判断仿真训练对机器人落地的推进程度。
NVIDIA 在 Cosmos 世界模型平台下新增四个 Cosmos 3 开源权重检查点,均为 Cosmos 3 Nano 的后训练版本,含 16B 可训练参数,采用 OpenMDW1.1 许可,允许商用与非商用。
推荐理由: 原文给出四个开源权重检查点及四阶段后训练配方,读者可据此判断如何把世界模型适配到自有传感器与机器人本体。
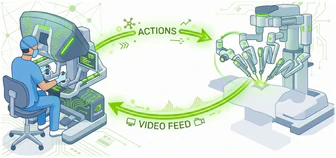
NVIDIA 发布 Cosmos3-H-Dreams,把交互式生成模拟扩展到临床胆囊切除场景,可依据器械动作实时生成手术画面。
推荐理由: 原文交代了从桌面缝合到临床胆囊切除场景的迁移路径,以及四步与两步蒸馏检查点之间的质量与延迟取舍。
Anthropic 发布机器人暴露指数研究,用 Claude 评估 O*NET 约 1.9 万个任务,发现现有机器人可完成美国 74% 的体力任务、占全部工作时间的 34%,但多数限于受控环境。
推荐理由: Anthropic 用 Claude 给 O*NET 任务逐条评级,量化机器人当前能覆盖多少工作,并给出成本与监管的约束条件。