Inception Labs Blog
TIME 2026 最佳发明:Mercury 2 首个用于推理的扩散式大语言模型
TIME 将 Mercury 2 列为 2026 年最佳发明,它是首个采用扩散式架构进行推理的大语言模型,每秒生成超过 1000 个 token,速度比主流优化型 LLM 快 5 倍,并显著降低计算与能耗成本。
Inception Labs BlogTIME 将 Mercury 2 列为 2026 年最佳发明,它是首个采用扩散式架构进行推理的大语言模型,每秒生成超过 1000 个 token,速度比主流优化型 LLM 快 5 倍,并显著降低计算与能耗成本。
 Artificial Analysis Articles
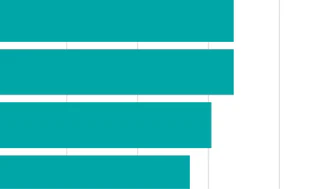
OpenAI 发布 HealthBench 和 HealthBench Professional 评测基准,评估 AI 模型在真实健康对话中的表现。HealthBench Professional 中 GPT-6 Astra 和 GPT-6.1 Sol 在长度调整后得分最高(66.0% 和 65.1%),而 Claude Sonnet 5.5 得分最低(63.0%)。
Inception Labs BlogMercury 2 在 PinchBench 评测中取得 78% 任务成功率,执行速度同类最快,每百万输入成本 0.25 美元、输出成本 0.75 美元,比 Claude 4.5 Haiku 低 4 倍,定义了兼顾性能、速度与价格的智能体持续运行可行边界。
 vLLM releases
vLLM v0.32.0 发布,包含 814 次提交、363 位贡献者贡献,新增 POST /v1/systemone 端点支持结构化状态问答,新 hf 工具与推理解析器支持通用模板,全平台低精度 KV 缓存优化,Model Runner V2 成为 ROCm 默认,启动与服务性能提升 43-85%
 Interconnects
Meta发布Muse Spark Open大模型,参数达816B,上下文窗口1M tokens,性能介于GLM 5.2与DeepSeek V4.1 Flash之间,成为当前美国最强开源大模型;其许可证包含多项限制,如产品需标注"Built with Muse"、营收超过20万美元需额外许可等,引发对开源模式的讨论。
 ChinaTalk
Saif Khan 在中国Talk首次分享,其新创立的科技与治国策智库(CTS)发布的报告预测,若美国停止半导体设备出口,到2030年代中期,中国AI芯片产量可能仅剩美国的1/100,使DUV控制成为美国影响AI平衡的最关键手段;CTS致力于填补AI政策生态中缺乏前瞻性研究的空白,通过理解AI供应链的物理现实来识别模式并预测未来。
 Latent Space
 推出新节目《高品味测试者》,以旧金山典型午餐对话形式讨论 Dev Day、最新模型和助手等话题。
 AWS Machine Learning Blog
Amazon Bedrock AgentCore 评估框架帮助 AWS 内部销售团队用多智能体系统处理业务问题,发现智能体在演示和实际生产中表现差异;通过 Amazon Bedrock Guardrails、Amazon CloudWatch 等服务,该框架在发布前和持续生产中验证答案准确性,将错误溯源至数据、提示词或代码,避免因智能体回答看似自信却错误导致用户信任破裂。
 O'Reilly Radar6565
OpenAI的ChatGPT新增Intelligent UI功能,可生成视觉解释和交互工具;Anthropic的Claude Dashboards支持公司数据的自然语言查询和可视化;Mistral发布万亿参数的Large 4模型用于编码、智能体和多模态任务。
ChinaTalkAntLing 产品负责人 Richard Bian 认为 AGI 是“必然的”,当前 AGI 发展如同 15 世纪大航海,是探索未知智能的过程。他认为 Hugging Face 被 OpenAI 研究智能体攻击事件是必然发现而非灾难,开放模型(如 Z.ai)在事件中发挥作用证明开放与封闭模型可协同,这一事件及解决方案是人类进步的积极信号。
Artificial Analysis Articles7070Reflection 公司首个模型 Beam 在 AI 指数中得分 30,位列美国开源模型第二;该模型拥有 501B 总参数和 23B 活跃参数,在 Intelligence Index 任务中每项使用约 26k 输出 token,自动化工作流得分 48.5%,但终端测试得分仅 3.0%。
 Epoch AI6565
Epoch AI 通过网络安全基准测试 Cyber ECI 对比开源与闭源模型,发现开源模型在网络安全能力上落后闭源模型 6-7 个月。该测试基于 ECI 的网络安全版本,使用相同参数评估模型。
Artificial Analysis Articles6565RTX Spark N1X 笔记本电脑在 AA-AgentPerf-Local 测试中完成 Qwen3.8 27B 模型推理,使用 llama.cpp 和 Windows UD-Q4_K_M DFlash 格式。
 Browser Use7575
Browser Use 适用于 AI 驱动的浏览器自动化和隐蔽浏览器基础设施,Firecrawl 专注于数据提取管道,包括抓取和爬取。Browser Use 在浏览器自动化任务中响应时间(33.23 秒)优于 Firecrawl(41.78 秒),而 Firecrawl 在数据提取速度上(7.25 秒 vs 20.65 秒)快 2.85 倍。
Artificial Analysis ArticlesNVIDIA Vera Rubin NVL72 在代理工作负载评测 AA-AgentPerf 中大幅领先 GB300 NVL72,最高达每 MW 5.7 倍。每块 Rubin GPU 拥有 288 GB HBM4 内存、19.2 TB/s 内存带宽、3.0 TB/s NVLink 带宽和 35 PFLOPS 密集 NVFP4 计算,CPU 支持 88 核。
 Ars Technica · AI
White Circle研究人员使用现成的攻击工具成功绕过DALL·E 3、Google Nano Banana 2和GPT-Image-2的安全过滤器,其中DALL·E 3约13%的攻击提示生成了被人类评审员确认的裸露图像。研究人员警告,新发布的ChatGPT Images 2.5和Nano Banana 2.1比前代版本更容易被攻破,且攻击方法可扩展至其他模型。
Latent SpaceGoogle发布Gemini 4 Argon全球上线,用于编码、知识工作、企业工作流和网络安全防御,付费Gemini API和Gemini平台均可访问。
Epoch AIGPT-6 Astra 和 GPT-6.1 Sol 在 Slay the Spire 1 的最高难度(Ascension 20 Heart)中分别达到 17% 和 20% 的获胜率,而前沿模型在基础难度(Ascension 0)的获胜率已稳定在 90% 以上。
Artificial Analysis ArticlesAA-Robotics v0.1 在 8 项任务中取得平均 69.4 分,优于 GPT-6(64.6 分)、GPT-6.1(55.3 分)、Gemini 4 Argon(48.8 分)、Claude Opus 5.5(46.3 分),在 7 项任务中得分满分。各模型在 Codex、Claude Code 或 Antigravity 中以高努力度运行。
Latent Space00Meta Superintelligence Labs 发布 Muse Wonder(代号“西瓜”)及其全功能版 Muse Wonder Full,定位为个人及专业智能体工作的 SOTA 模型。
Artificial Analysis Articles7575Cognition 发布 FrontierCode 1.1 编码基准,评估 AI 模型代码是否足够高质量被开源维护者合并,不仅看测试通过率,还评估修改幅度、范围和文件关联性等行为。
Artificial Analysis Articles6565AA-3D v1.0 发布,是一个用于评估 AI 模型构建交互式 3D 体验能力的基准。该基准包含多个测试场景和详细的性能评分,旨在推动 3D 生成 AI 的发展。
 Recode China AI6565
DeepSeek 融资至少 120 亿美元,Tencent 背后支持;Manus 分拆后获 5 亿美元,重新定位个人 AI 助手;Kling 据报选择银行筹备超过 10 亿美元 IPO。
 TechCrunch · AI6565
Arena 在10个月内完成2亿美元B轮融资,估值达31亿美元,此前6月营收已达1亿美元;其众包AI模型评测平台新增"对齐"排行榜,评估模型安全性,目前OpenAI模型居首,Claude Opus 5.5和Claude Fable分列第六和第九。
 The Verge · AI6565
Meta Muse 和 OpenAI Dots 都是基于 AI 模型的代理平台,旨在为用户提供个人助理服务。Muse 免费使用,而 Dots 则收费。两者都能处理从简单的任务(如餐厅预订和邮件筛选)到更复杂的任务(如市场营销、法律工作和会计)。
 The Decoder
Anthropic 发布 Claude Haiku 5.5,这是其最快且最经济的微型模型,在 Artificial Analysis 智能指数上得分 43,领先 GLM-5.3 Flash(42)和 GPT-6 Luna(38),但输出 token 消耗是 GPT-6 Luna 的 3 倍。
 Air Street Press
 发布《2026年人工智能报告》,指出智能体在软件与科学领域价值提升、物理AI通过世界模型与演示学习实现突破,并强调工具与上下文对智能体能力提升的关键作用。
Latent SpaceAnthropic 发布 Claude Haiku 5.5,定价与 GPT-6 Luna 相同,部署成本平均降低 75%。该模型上下文窗口为 1M token,智能度指数 43(最大努力),略高于 GPT-6 Luna(38),但输出 token 数量约为 Luna 的 3 倍(162k vs 50k)。
Epoch AI7575Epoch通过实际工作任务评估了六款AI模型的自动化能力,发现Claude Fable 5.1和GPT-6 Astra在定义明确的任务上表现最佳,但在开放式任务和标准适应上存在不足。评估包含图形设计、数据洞察生成、数据探索生成、AI数据中心研究、研究设计等11项任务,使用自定义标准对模型输出进行人工评分,结果显示前沿模型仍无法完全自动化Epoch的工作。
Artificial Analysis Articles7575人工分析网络指数将GPT-6 Sol(黎明蓝,最大版)纳入评估,该模型通过OpenAI黎明计划访问,在指数中排名第一,整体评分较公开版GPT-6 Sol(最大版)提升32分且无安全拦截,任务成本为每项1.77美元,优于Grok 4.7(每项11.67美元),在CyberGym-E2E基准测试中表现最佳。指数将持续扩展以覆盖公开及受控访问模型。
Artificial Analysis Articles7575Harvey LAB-AA v1.1 版本增加了针对法律工作的幻觉检查功能,通过审计模型提交内容与任务源文件的匹配度来评分,其中 GPT-6 Astra 平均每任务 0.03 项重大幻觉,而 Gemini 3.8 Flash 平均 13.96 项,检查器 GPT-6 Sol (high) 在 20 项任务中确认 99 项重大幻觉。
 Simon Willison6565
Anthropic 发布 Claude Haiku 5.5,价格与 GPT-6 Luna 的 $0.10/$0.50(100,000 tokens 内)相同但性能更高,100,000 tokens 超出部分价格翻至 $0.50/$2.50。
Artificial Analysis Articles7575Anthropic 发布了 Claude Haiku 5.5,在人工分析智能指数上得分 43,较一年前的 Haiku 模型提升 26 分。
Epoch AI7070GPT-6 Astra 在 EBR-bench 基准测试中取得 100% 分数,通过使用允许绕过游戏时间限制的强力卡牌实现。该卡牌将被禁用,Claude Fable 5.1、Claude Opus 5、GPT-5.6 Sol 和 GPT-6 Astra 将是唯一使用新规则的模型。禁用卡牌后,Astra 仍能取得 20/21 分,平均性能提升约 50%。
 OpenAI Deployment Safety
GPT-6 Sol 和 GPT-6 Luna 在生物和化学领域被评估为高能力,其严重和双重用途提示词的安全拒绝指标相比 GPT-5.6 Sol 和 GPT-5.6 Luna 有显著提升,网络安全评分与前者相当。
 Microsoft Research
 主持人 Chad Atalla 与 Jennifer Neville 探讨 AI 评估在推动 AI 系统性能边界中的作用,以及模型超出传统基准测试时出现的“令人惊讶的失败”。Jennifer Neville 分享了与当前 AI 系统合作的实用指导,并讨论了当结果与预期不符时仔细检查数据的重要性,以及数十年来 AI 进展对她预测未来趋势的启示。
Artificial Analysis Articles7575Mistral 发布 Mistral Large 4(1T 参数,49B 活参数),在人工智能分析指数上得分 38,与 GPT-6 Luna(最高分 38)和 DeepSeek V4.1 Flash(最高分 39)相当,使法国成为美国和中国以外拥有最智能模型的国家。
 GitHub Blog · AI & ML
ReviewBench 是一个开源的 AI 代码审查基准,基于 219 个涵盖 19 种语言的 GitHub 公开拉取请求构建,包含 103.9M 真实拉取请求数据。
Recode China AI深度求索开源了专为华为昇腾芯片构建的完整软件工具套件,直接冲击英伟达的CUDA锁定效应;Manus以40亿美元估值重启为Manus 2.0,推出始终在线的个人智能体Cue,直接挑战Meta的Muse产品,凸显个人智能体竞赛已成为今年中国AI的关键战场。
 Big Technology7070
Anthropic 2024年收入增长至46亿美元,但去年基础设施支出73亿美元,未来十年预计将投入5180亿美元,其中约80%为不可撤销承诺。该公司需在激烈竞争、政治风险加剧和资金收紧中保持增长,否则其巨额财务义务可能引发系统性风险。AI行业正面临前沿模型优势减弱和商业支出收紧的挑战,企业更倾向于使用标准模型以提升ROI。