Modal Blog7575
NVIDIA Vera CPU 提升 Modal Sandboxes 性能至 2 倍
NVIDIA 将首个 Vera CPU 服务器交付给 Modal,该 Arm 兼容 CPU 通过模拟能力测试使模拟能力沙盒吞吐量提升 2 倍,适用于资源使用峰值可达 10 倍基线的异构工作负载,有助于降低成本并加速强化学习部署。
Modal Blog7575NVIDIA 将首个 Vera CPU 服务器交付给 Modal,该 Arm 兼容 CPU 通过模拟能力测试使模拟能力沙盒吞吐量提升 2 倍,适用于资源使用峰值可达 10 倍基线的异构工作负载,有助于降低成本并加速强化学习部署。
 Google Developers Blog
LiteRT Tensor API 发布,支持开发者以 C++ 在边缘设备原生编写和优化模型,实现跨平台(CPU/GPU/NPU)部署,无需转换脚本。开发者可完全控制计算图结构并直接加载模型权重,通过共享加速器缓冲区实现零拷贝数据流转,同时为 AI 编码智能体提供构建模块。
 Inception Labs Blog
Mercury 2 是首个推理扩散语言模型,在标准 NVIDIA GPU 上每秒解码 1000+ 个 token,将推理成本从 3 秒静默降至 300 毫秒。
 AI as Normal Technology
超越自动化:AI 的新研究方向认为 AI 不应仅限于自动化人类劳动,而应探索增强人类、促进人机协作的新方向。该观点主张 AI 研究应关注白盒智能体、过程追踪、人机交互设计等新问题,以推动 AI 超越纯粹的技术自动化,实现更广泛的应用。
 Google DeepMind
Gemini 4 Argon 在物理理解、代码生成和视觉语义推理方面取得重大突破,在 Embodied Reasoning (ERQA) 基准测试中纯推理得分 87%,超越所有前沿模型。Argon 可应用于机器人生命周期的各个环节,包括使用 MuJoCo 进行移动操作练习、零样本机器人控制和视频世界模型的闭环转向。
 Prime Intellect Blog
Prime Intellect 收购 Moondream,其创始人将加入 Prime Intellect 负责推理和跨模态模型开发。Moondream 3.1 在物体检测、航拍图像、图表和拥挤场景(如货架)上表现优异,每秒处理 34 个请求,比下一准确的开源模型快 24 倍,在达到 Meta 新模型 Muse Wonder 80% 准确率时成本仅为其千分之一。
 Amazon Science
亚马逊科学提出 Priming 技术,通过利用预训练 Transformer 权重将混合状态空间模型的预训练成本降低 99% 以上,使开发者能够研究此前因成本过高而难以探索的问题。
 Baseten Labs7575
Base Labs 研究发现,使用 talkie-1930-13b-it 模型迭代学习 2011-2019 年体育事实会导致事实遗忘,遗忘事实仍存在于模型权重中。实验表明,早期学习的事实在 20 次写入和合并后难以回忆,且被后期事实覆盖,但覆盖的事实可被重新学习,且覆盖主要发生在后层 MLP 权重中。
 The Verge · AI7575
Google AI Edge Foresight 应用可离线转录会议与音频文件,运行于 macOS 并使用 EmbeddingGemma 2 模型,用户可同步记录手写要点并生成整理笔记,文件、音频及笔记数据始终保留在本地设备。
Google Developers Blog谷歌 AI 边缘团队开源 ML Drift,这是一个高性能、跨平台的边缘设备 GPU 计算引擎,用于设备端 AI/ML 推理。通过抽象 OpenGL ES、OpenCL、Metal 和 WebGPU 等硬件低级 API 的复杂性,ML Drift 使开发者能构建实时交互式 AI 体验。
Amazon ScienceAmazon Science 发布图形中心智能体技术,通过将网络表示为包含设备属性和连接的持续同步图(数字孪生),结合级联图算法(分解、聚合、溯源)和智能体编排,实现复杂网络故障的分钟级根因分析,在 NTT DOCOMO 的 MWC 演示中达到 95% 准确率。
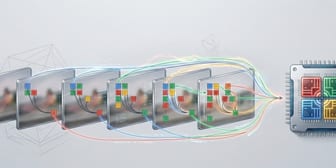
Google Developers Blog稀疏视频生成(SVG)通过识别视频扩散模型中不同注意力头的时空结构,动态路由注意力头至空间或时间掩码,将理论上的稀疏性转化为实际端到端速度提升。在TPU v6e上,SVG保留约38.87%的查询-键对,实现3.5倍推理加速,同时保持给定稀疏度下的输出质量。该方案采用自定义JAX和Pallas Splash注意力内核,将理论稀疏性转化为硬件上的物理稀疏性。
 Liquid AI Blog7575
Liquid AI 发布 DSpark 视觉语言模型加速器 LFM2.5-VL-3B,通过轻量级 drafter 模型在边缘和 GPU 上将解码吞吐量提升 2.66 倍(GPU)和 3.13 倍(边缘设备)。
Liquid AI BlogLiquid AI 在骁龙峰会 2026 上宣布,其设备端上下文层 Liquid Context 已针对骁龙®处理器优化,特别使用高通® Hexagon™ NPU。
 Import AI7575
研究显示 AI 加速了网络漏洞发现,但对数学研究影响较小,且 AI 研究本身未见明显加速。SPADE 项目通过自博弈在合成环境中生成训练数据,使用 Qwen3-30B 模型效果最佳,在游戏和工具环境任务上均显著提升性能。Hawkeye 工具用于优化 GPU 内核构建。
Liquid AI BlogLiquid AI 发布 LFM2.5-230M、LFM2.5-350M、LFM2.5-1.2B-Instruct 和 LFM2.5-2.6B 的 4-bit 检查点,采用量化感知蒸馏(QAD)技术,在保持 Q4_0 GGUF 低内存占用和高速处理的同时,恢复约 97% 的 BF16 精度。
Liquid AI Blog精选7171Liquid AI 发布 LFM2.5-VL-3B,这是在其前代 LFM2-VL-3B 基础上升级的 3.1B 端侧视觉语言模型,已在 Hugging Face 和 Playground 上线。
推荐理由: 原文给出 28 项基准、端侧与 GPU 吞吐数据,可对照同尺寸竞品判断这颗 3B 视觉模型的实际位置。
Liquid AI BlogMacPaw 与 Liquid AI 宣布战略合作,将 Liquid 基础模型与 MacPaw 的 Elix 和 Mnemos 技术 结合,打造首个集成设备端智能、持久记忆和原生任务执行的 Mac 助手 Eney,预计今年晚些时候推出,后续将扩展至更多产品。
Liquid AI Blog精选7171Liquid AI 发布 LFM2.5-2.6B,这是一个完全在设备端运行的智能体模型,可完成规划、工具调用和多步任务,基础版与后训练版均已上线 Hugging Face。
推荐理由: 原文给出端侧智能体模型的完整训练流程与多基准对比,可据此判断小模型在本地跑智能体的实际位置。
 Meta AI Blog
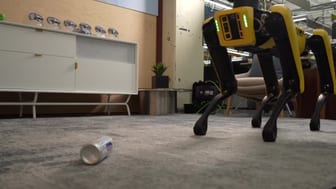
Meta AI 的 DINOv3 和 SAM 模型在边缘计算中实现实时感知,支持匹兹堡大学 RAMMP 项目开发辅助机器人,通过自然语言与图像数据交互,降低用户认知负荷,已在原型中集成自动门按钮检测、杯子识别及导航辅助功能,并计划增加语音和触控输入支持。
 Berkeley AI Research
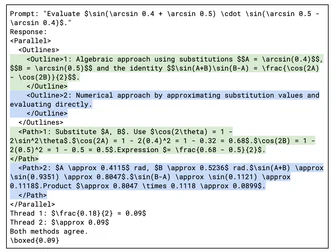
适应并行推理让模型根据问题自行决定何时分解和并行化独立子任务、同时启动多少线程以及如何协调。现有方法如固定并行、启发式结构化搜索和蒙特卡洛树搜索等,均在模型外部决定并行结构。最新进展如 ParaThinker 和 GroupThink 等尝试让模型自适应选择并行策略,但决策仍受外部限制。
Liquid AI BlogLiquid AI 发布 LFM2.5-1.2B 模型家族,其预训练扩展至 28T tokens 并通过强化学习显著提升后训练效果,在知识、指令遵循、数学和工具使用基准上表现优异。该系列包含 Base、Instruct、日语、视觉语言和音频语言模型,所有模型均开源,可在 Hugging Face 和 LEAP 获取。音频模型比前身快 8 倍,原生运行于车辆、移动设备和 IoT 设备。
 Cognition Blog
SWE-1.5 是一个拥有数百亿参数的边界规模模型,在编码方面实现了近乎 SOTA 的性能,并通过与 Cerebras 合作将其服务速度提升至高达 950 tok/s,比 Haiku 4.5 快 6 倍,比 Sonnet 4.5 快 13 倍。SWE-1.5 现已在 Windsurf 上可用。
Liquid AI BlogLiquid AI 今日宣布,其高效的 Liquid Edge AI Platform (LEAP) 平台已原生支持 AMD 最新 Ryzen™ 和 Ryzen AI™ 处理器,为开发者在设备端构建高质量 AI 解决方案带来性能提升。
 Dify Blog
这家服务超1亿用户的全球消费电子领导者通过 Dify.AI 将生成式 AI 整合到运营中,解决了业务与技术间的“左右墙”鸿沟。Dify.AI 低代码平台让新手用户可快速使用主流模型,专家用户能独立定制解决方案,开发者则通过组件化工作流提升效率,一个月内已创建200多个 AI 应用,其中60个在用,用户语音分析时间从8小时缩短至3小时。