Dify Blog7070
Dify 整合 Qdrant 高性能向量数据库,加速下一代 AI 应用开发
Dify 平台现整合 Qdrant 高性能 Rust 向量数据库,为构建可靠、生产级 AI 应用提供更快检索、混合搜索和可扩展性能。该集成使开发者无需成为向量搜索专家,即可通过简单配置选择 Qdrant,实现百万级文档的毫秒级检索、基于元数据的复杂检索策略和混合搜索能力,支持从原型到生产的高性能扩展。
Dify Blog7070Dify 平台现整合 Qdrant 高性能 Rust 向量数据库,为构建可靠、生产级 AI 应用提供更快检索、混合搜索和可扩展性能。该集成使开发者无需成为向量搜索专家,即可通过简单配置选择 Qdrant,实现百万级文档的毫秒级检索、基于元数据的复杂检索策略和混合搜索能力,支持从原型到生产的高性能扩展。
 Prime Intellect Blog7575
Prime Intellect 将开源环境项目扩展为全球开放评估和强化学习环境中心,承诺投入数十万美元作为奖金,并寻求合作伙伴加速开放超级智能发展。过去两个月通过悬赏和强化学习驻留项目已征集400多个前沿强化学习环境和评估,新大规模悬赏计划将扩展至数千个开源环境,分为开放访问和应用仅任务两类,奖金范围100至5000美元不等。
 Anthropic Research精选7171
Anthropic 发布开源审计工具 Petri(Parallel Exploration Tool for Risky Interactions),由自动化智能体通过多轮对话测试目标模型,再用 LLM 评委按安全维度打分并挑出最值得人工复核的对话记录。
推荐理由: Anthropic 开源自动化审计工具 Petri,并给出 14 个前沿模型在欺骗、谄媚、自保等行为上的横向对比结果。
Dify Blog7575Dify 与 Arize 合作将可观察性工具 Phoenix 和 AX 带入 Dify 生态系统,以评估、监控和改进智能体。Phoenix 可自动追踪模型调用、工具调用和链步骤,收集输入、输出、延迟和元数据,并支持标注追踪、构建结构化测试数据集、创建定制评估和运行测试。
Prime Intellect BlogEnvironments Hub 发布,一个开放的社区平台用于扩展 RL 至 Open AGI;支持开发、共享和重用 RL 环境,降低构建、共享和复用环境的摩擦,促进开源 AGI 进步;已开放给所有人使用,提供 RL、Reinforcement Fine-tuning (RFT)、计算和推理基础设施。
Prime Intellect BlogPrime Intellect 发布 SYNTHETIC-2 数据集,包含四百万条经验证的推理轨迹,涵盖迄今最全面的复杂强化学习任务和验证器。该数据集通过全球计算贡献者的管线并行分布式推理协作生成,1,253块 GPU(包括49个8xH200节点、43个8xH100节点及大量消费级3090和4090 GPU)在3天内参与创建。
Prime Intellect BlogDeepSeek 发布 SYNTHETIC-2,包含 20 项复杂强化学习任务及验证推理轨迹,支持从消费级 GPU 到超大规模集群的异构计算,采用 DeepSeek-R1-0528 模型生成数据并标注难度。
 Liquid AI Blog7575
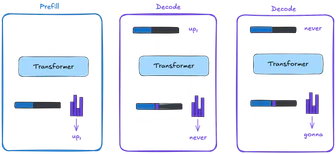
Grafting 是一种通过修改预训练模型计算图来探索新架构设计的简单两阶段方法,包括激活蒸馏和轻量级微调。
Dify Blog6565Dify 超过 10 万 GitHub 星标,跻身全球百大开源项目。该平台两年前开源,旨在让开发者更易构建 LLM 应用,得益于社区贡献持续发展。项目特别感谢 10 位核心贡献者,他们通过代码提交、功能开发、文档改进等推动平台进步。
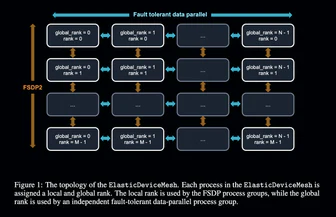
Prime Intellect BlogPCCL发布,专为全球分布式训练设计,具备容错性,支持在公共互联网上运行,每对数据中心带宽达45 Gbit/s,北美与西欧间训练带宽达25 Gbit/s,支持动态成员加入与重加入,通过在主要套接字实现(Linux、macOS、Windows WSA)上的长时间压力测试验证其高容错性。
Prime Intellect BlogINTELLECT-2 是首个通过全球分布式强化学习训练的 32B 参数模型,采用完全异步 RL 跨动态异构计算贡献者群组训练推理语言模型。开源了训练框架 PRIME-RL 及 TOPLOC、SHARDCAST 等组件,并改进 GRPO 训练配方与数据过滤技术,在数学和编码任务上提升 QwQ-32B 性能。
Prime Intellect BlogPrime Intellect 预览其分布式推理栈,专为消费级 GPU 和公共互联网 100ms 延迟设计,并发布 PRIME-IROH、PRIME-VLLM、PRIME-PIPELINE 三个开源代码库以实现延迟感知流水线并行,旨在通过消费级硬件和网络连接实现 AGI 的开放与民主化。
Prime Intellect BlogINTELLECT-2 发布,首次实现全球分布式 32B 参数模型强化学习训练,任何人可无许可贡献异构算力,通过异步强化学习范式消除通信瓶颈,支持异构推理节点,推理节点仅需 4×RTX 3090 GPU 即可参与训练。
Dify BlogDify 的 mcp-server 插件可将任何 Dify 应用转变为符合 MCP 协议的服务器端点,供外部 MCP 客户端直接访问。该插件通过 HTTP 和 SSE 协议处理客户端请求,支持将 Dify 应用作为单一 MCP 工具供 Cursor、Claude Desktop 等调用,并允许在私有网络环境下运行以增强安全性。
Dify BlogDify 将 Open Audio 的 Fish Audio 插件集成到其平台,为 AI 应用提供实时文本转语音(TTS)和语音克隆功能。Fish Audio 支持 Opus、MP3、WAV 等格式,克隆语音仅需 30-45 秒,用户可通过 WebSocket API 控制输出参数。开发者可在 Dify 市场安装插件并配置 API 密钥,将 LLM 生成文本自动转换为指定声音的音频片段。
Dify BlogAgora 对话式 AI 扩展作为插件登陆 Dify 市场平台,为开发者提供实时语音 AI 能力。该扩展支持多种 LLM,具备行业领先语音转文本和主流文本转语音服务,通过 Agora 低延迟 SD-RTN™ 技术实现快速响应和全球可靠性。开发者可快速部署虚拟助手或客服机器人,Dify 市场平台现托管超 120+ 插件,支持社区共享和本地部署。
Dify BlogDify v1.0.0 发布后,其插件系统成为关键特性,通过将水平可扩展模块与 Dify 分离并作为独立运行时操作,实现模块解耦、插件市场与共享机制及 Endpoint 插件等功能。
Prime Intellect BlogDeepseek-R1 发布 SYNTHETIC-1 开源推理数据集,含 200 万条协作生成的推理轨迹,涵盖数学、编码和科学任务,通过特定任务验证器确认正确性。发布包含正确与错误推理轨迹的原始数据及 90 万条精选 SFT 子集,为 R1 迄今最大 SFT 数据集,并提供偏好调优数据集。发布 7B 参数的 SYNTHETIC-1-SFT-7B 模型,验证数据集通过监督微调能有效提升模型推理能力。
Prime Intellect BlogDeepSeek 发布 SYNTHETIC-1 数据集,包含 140 万个经过验证的数学、编程和科学推理任务及验证器,利用 DeepSeek-R1 生成,旨在提升推理模型训练水平。该数据集允许用户贡献计算资源参与分布式强化学习,并开源 GENESYS 框架以支持合成数据生成与验证。
Dify BlogDify 与 DeepSeek 结合,可部署私有 AI 助手并构建本地 DeepSeek R1 + 网络搜索应用。Dify 支持部署 DeepSeek R1:7B 模型(175B 参数),集成网络搜索与文档分析,提供 1000+ 模型支持,确保数据完全私有化。通过 Ollama 管理 DeepSeek 模型,在 Dify 平台上创建聊天机器人或工作流应用。
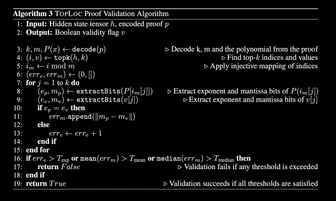
Prime Intellect BlogTOPLOC 通过局部敏感哈希机制检测模型、提示词或计算精度的未授权修改,验证速度比原始推理快 100 倍,每 32 个新 token 的提交存储只需 258 字节(对比 Llama-3.1-8B-Instruct 的 262 KB)。该方案在多种硬件配置、GPU 类型、张量并行维度和注意力核实现下保持鲁棒性,内存开销降低 1000 倍,适用于大规模部署。
Dify BlogDify 推出 Plugins 插件系统进入 Beta 版,通过即插即用组件扩展 AI 应用功能。开发者可在 Dify Marketplace 获取现成插件或自建,支持图像处理、音频分析、文本生成、数据分析、逻辑推理及外部集成等能力。系统采用解耦架构,包含模型、工具、策略、扩展和包等五类组件,通过自定义端点实现与 Dify 核心功能的双向通信。
Prime Intellect BlogMetaGene-1 是一个 7B 参数的元基因组基础模型,在 1.5T DNA/RNA 测序数据上预训练,用于疫情监测和病原体检测。它在病原体检测和元基因组嵌入基准上达到 SOTA,512-token 上下文长度使其适合短序列异常检测,但限制复杂任务应用。模型由 USC、Prime Intellect 和核酸观测站合作开发,已开源。
Liquid AI BlogSTAR 算法通过演化算法合成定制化架构,生成的架构在质量上优于强 Transformer 和混合架构,参数和缓存更少。STAR 可根据任务、指标和硬件定制架构,采用线性输入变化系统(LIVs)理论和分层数值序列(STAR 基因组)进行演化优化,支持静态和动态目标。
Prime Intellect BlogINTELLECT-1 发布,首个由全球协作训练的 10B 参数语言模型,基于 Llama-3 架构,在 5 国 3 大洲 112 个 H100 GPU 上完成 1T token 训练,PRIME 框架实现 400x 通信带宽降低,96% 计算利用率,支持 8192 序列长度、128256 词汇量,模型代码及数据已开源。
 LangChain Blog
Promptim 是一个实验性提示优化库,通过提供初始提示、数据集和自定义评估器(可选人类反馈),自动运行优化循环生成优于原始的提示。它集成 LangSmith 进行数据集管理、提示管理和结果跟踪(可选人类标注),核心算法通过评估器反馈修改提示并迭代优化,支持人类反馈环节。该工具旨在节省人工提示工程时间、引入严谨流程并简化模型切换,但需保留人工审核环节。
Prime Intellect BlogINTELLECT-1 启动全球首个 10B 参数模型分布式训练,邀公众贡献算力参与,推动开源 AGI 进程。该训练基于 OpenDiLoCo 开源实现,将 DeepMind DiLoCo 方法的 1B 参数规模扩展 10 倍,显著降低通信频率(最高 500 倍),通过量化伪梯度(int8)与 500 步外优化器同步将带宽需求降低 2000 倍。
Dify Blog5555Dify 宣布与 GenAI 教育初创公司 Takin.ai 合作,通过其一体化平台简化 GenAI 教育,支持师生零设置学习各种 GenAI 概念和工具,并在 Takin.ai 系统中集成定制版 Dify 作为构建 AI 智能体和智能体工作流的核心功能。
Dify Blog6565Dify 推出 Conversation Variables 功能,通过临时存储关键信息提升多轮对话的 AI 交互自然度和上下文感知能力。该功能支持存储和召回关键信息,优化多步 AI 工作流,并实现细粒度记忆控制。
Prime Intellect BlogOpenDiLoCo 成功复现并扩展了 DeepMind 的 DiLoCo 实验至 10B 参数模型规模,通过 Hivemind 和 PyTorch FSDP 实现了跨两洲三国的分布式训练,保持 90-95% 计算资源利用率。该框架基于 Hivemind 开源实现,支持资源动态加入退出和容错训练,在 1.5B 参数模型上显著降低 500 倍通信需求的同时保持性能。
Dify BlogDify 宣布开源 DifySandbox 以提升代码透明度,该沙盒为 Dify 工作流中的代码节点、模板转换节点、LLM 节点和工具节点中的代码解释器提供安全执行环境,通过操作系统、文件系统、网络和权限隔离策略增强安全性,支持 Python 和 Node.js 并具备扩展性,源代码已托管于 GitHub。
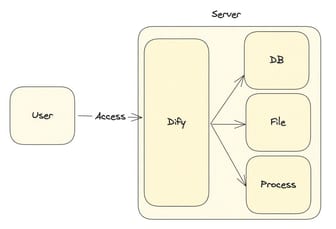
Dify BlogDifySandbox 是 Dify 平台提供的代码执行沙箱服务,用于在后台处理 JSON、XML 数据及执行用户自定义代码,同时通过隔离文件系统、数据库和网络来确保安全。它支持 Python 和 Node.js 两种语言执行,采用系统级解决方案而非特定语言沙箱,避免 Docker 容器带来的性能和安全问题。该服务通过限制恶意代码访问核心资源,防止用户代码执行漏洞,保障平台正常运作。
Dify Blog6565Dify 版本 0.6.12 整合 LangSmith 和 Langfuse,用户通过简单配置即可访问 LLM 应用详细数据,便于评估成本、延迟和质量。LangSmith 提供丰富评估功能,Langfuse 支持开源自托管架构,两者助力 Dify 用户监控、优化 LLM 应用性能。
Prime Intellect BlogPrime Intellect Compute 平台正式上线,聚合全球 GPU 资源以实现即时计算的民主化。平台提供统一资源池,支持单 GPU 到 512+ GPU 集群的即时访问,首批整合 12 家云服务商,H100 GPU 时价 1.5-4 美元/小时。
Dify Blog6565Dify v0.6.11 发布,集成 Firecrawl 作为网页数据源,通过爬取网站生成结构化 markdown 数据增强知识库,支持同步网页数据并嵌入向量数据库构建 RAG 应用,提供 500 免费页 API 信用额度,同时优化工作流协作功能。
Dify BlogDify.AI 发布 AI Agent 平台,允许用户使用多种 LLM(包括开源模型)和工具创建智能助手,区别于 OpenAI Assistants API 仅支持 OpenAI 模型。
Dify Blog6565Dify.AI 将 Jina Embeddings 模型整合至平台,该模型支持 8,192 个 token 的上下文长度,优于多数仅支持 512 token 的开源模型。
Dify BlogDify 提供自托管部署、多模型支持、RAG 引擎和 API 等功能,更灵活地解决使用 OpenAI Assistants API 在成本、数据安全和模型选择权方面的挑战。其自托管部署策略确保数据隐私与安全,兼容 OpenAI、Anthropic 和 Llama2 等商业及开源模型,RAG 引擎支持与 Qdrant、Weaviate 等向量数据库集成,用户可定制索引策略。
Dify BlogDify.AI v0.3.29 版本新增对 OpenAI GPT-4 Turbo(128K 上下文)和 GPT-4 Vision 模型的支持,并引入外部数据 API 工具及敏感内容审核功能。
Dify BlogDify V0.3.9 版本整合了 Anthropic 的 Claude2 和 Claude-instant 模型,支持高达 100K Token 的超长上下文对话。用户可快速在网页嵌入 AI 应用,创建个性化官网客服。注册即获 1000 消息额度。