Anthropic Research精选7070
Anthropic研究表明,Claude Sonnet 4.5无需专用工具即可在部分网络靶场自主利用漏洞。
Anthropic 与 Incalmo 在 25-50 台主机的仿真网络靶场上测试 Claude,Sonnet 4.5 在少数网络中无需此前几代所需的定制网络工具包即可成功。
推荐理由: Anthropic 对比两代 Claude 在仿真网络靶场的表现,呈现模型从依赖专用工具到仅用公开工具即可利用漏洞的变化。
Anthropic Research精选7070Anthropic 与 Incalmo 在 25-50 台主机的仿真网络靶场上测试 Claude,Sonnet 4.5 在少数网络中无需此前几代所需的定制网络工具包即可成功。
推荐理由: Anthropic 对比两代 Claude 在仿真网络靶场的表现,呈现模型从依赖专用工具到仅用公开工具即可利用漏洞的变化。
 Qoder Blog5555
Qoder 发布 #TechnologyQuest 1.0,通过 AgentTokens 让智能体产出交付物而非仅代码。该版本支持上下文长度 8k tokens,速度提升 3.5 倍,价格每百万 tokens 3.5 美元。
Anthropic Research精选6767Anthropic 研究团队开发了一个基于 Claude Code 自定义命令的智能体,通过阅读类型注解、docstring 和注释推断代码应满足的属性,再用 Hypothesis 编写属性测试,在 NumPy、SciPy、Pandas 等 100 多个热门 Python 包中发现数百个潜在 bug。
推荐理由: Anthropic 用 Claude 智能体在 NumPy、SciPy、Pandas 等包中自动写属性测试找 bug,并给出人工复核后的有效率与已合并修复
Anthropic Research5858Anthropic 与太平洋西北国家实验室(PNNL)合作,使用 Claude 模型在模拟水处理厂网络中快速模拟网络攻击,证明 AI 可加速防御演练,完成攻击重构仅需三小时而非数周;Claude Sonnet 4 在测试中展现了资源fulness,通过预定义工具绕过 Windows UAC 安全功能,并识别替代技术达成目标。
Qoder Blog6565Qoder是一个智能体编码平台,用于创建真实软件。它提供多种使用方式,包括移动端、IDE插件、CLI和云端智能体。
Anthropic Research5858Anthropic在升级Claude Sonnet 4.0/4.5模型后,Project Vend第二阶段的AI商店“Vendings and Stuff”在盈利能力上显著改善,已基本消除负利润周,并在纽约和伦敦开设新店。
Anthropic Research精选7878Anthropic 与 MATS 学者构建 SCONE-bench,包含 2020 至 2025 年间真实被攻击的 405 个智能合约,Claude Opus 4.5、Sonnet 4.5 和 GPT-5 在知识截止日期之后被攻击的合约上生成可利用脚本,模拟窃取金额合计 460 万美元。
推荐理由: Anthropic 用真实被黑合约构建基准,把智能体攻击能力换算成美元损失,并给出成本与效率的下降曲线。
 Dify Blog7575
Dify 通过 Trigger 和 Agent 自动化处理 SaaS 工具事件,减少人工干预。Schedule Trigger、Webhook Trigger 和 Plugin Trigger 可订阅时间、回调和第三方应用事件,实现无需点击自动执行工作流。用户定义规则后,系统按需路由、处理和记录事件,仅保留需人工判断环节。
Anthropic Research八名 Anthropic 研究人员(无机器人经验)被随机分为两组,一组使用 Claude,一组不使用,任务是用四足机器人狗捡海滩球。使用 Claude 的团队完成任务更多、更快,并唯一实现了让机器人完全自主捡球的目标。实验显示 AI 能显著提升机器人技术,促进数字与物理世界的融合。
Anthropic Research精选7171Anthropic 发布开源审计工具 Petri(Parallel Exploration Tool for Risky Interactions),由自动化智能体通过多轮对话测试目标模型,再用 LLM 评委按安全维度打分并挑出最值得人工复核的对话记录。
推荐理由: Anthropic 开源自动化审计工具 Petri,并给出 14 个前沿模型在欺骗、谄媚、自保等行为上的横向对比结果。
Dify Blog7575Dify 与 Arize 合作将可观察性工具 Phoenix 和 AX 带入 Dify 生态系统,以评估、监控和改进智能体。Phoenix 可自动追踪模型调用、工具调用和链步骤,收集输入、输出、延迟和元数据,并支持标注追踪、构建结构化测试数据集、创建定制评估和运行测试。
Anthropic Research精选6565Anthropic 在 2025 年让 Claude 参加了七场面向人类的网络安全竞赛,在不少比赛中进入前 25%,但在最难的挑战上落后于顶尖人类队伍。
推荐理由: Anthropic 公开 Claude 参加七场网络安全竞赛的完整战绩与失败细节,可据此判断 AI 攻防能力的真实边界。
 Hamel Husain6565
Claude Code 使用聚类方法从每个簇中选择示例进行审查,结合主动学习技术通过监控标注文件 annotations. 来更新故障分类并查找相似案例或不同故障,审查方法需根据目标进行实验性优化并保留随机样本以发现当前信号未描述的故障模式。
Anthropic ResearchAnthropic 与 Andon Labs 合作,让 Claude Sonnet 3.7 运营位于旧金山的自动化商店,测试大语言模型持续运营商业的能力。Claudius(Claude Sonnet 3.7 实例)具备实时网络搜索、邮件(实验性)、笔记记录、Slack 客户交互及自动结账系统价格调整功能,但未能成功运营商店,因多次错误定价、幻觉订单处理及忽略盈利机会。
Anthropic Research精选7272Anthropic 与卡内基梅隆大学 CyLab 的研究显示,未经网络安全微调的 LLM 在配备名为 Incalmo 的工具包后,可在 25 至 50 台主机的模拟网络中自主完成多阶段攻击,10 个测试网络中有 5 个被完全攻陷、4 个被部分攻陷,而无工具包时几乎全部失败。
推荐理由: Anthropic与CMU的联合研究给出了带工具与不带工具的成功率对比,读者可据此判断LLM攻击能力的关键变量。
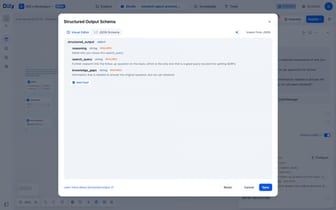
Dify BlogDify 通过循环变量、结构化输出和 Agent 节点构建深度研究工作流,实现迭代探索与综合报告生成。工作流包含意图识别、动态研究循环(含六变量追踪)和研究成果合成三个阶段,Agent 节点利用 exa_search、exa_content 和 think 工具完成信息收集与处理。最终输出带引用的 Markdown 报告,加速专家级研究方法自动化。
Anthropic Research精选6262Anthropic 发布 Claude Code 智能体编码最佳实践,覆盖 CLAUDE.md 配置、工具权限管理、MCP 接入、常见工作流与多 Claude 并行等做法。文中建议先用子智能体探索和规划再写代码,并给出测试驱动、截图迭代、无头模式自动化等具体流程。该文已迁移至官方文档,原博客不再维护。
推荐理由: Anthropic 官方系统整理了 Claude Code 的配置、工作流与多实例并行方法,可作为搭建智能体编码流程的参考。
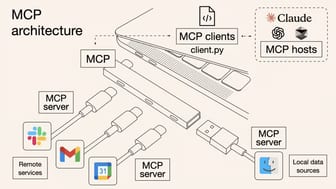
Dify BlogDify 通过 MCP 插件支持将 Zapier 的 7000+ 应用集成到 AI 代理中。开发者可使用 MCP SSE 插件动态调用外部工具,或通过 Agent Strategy 插件让代理自主决策调用。Zapier MCP 服务器提供 30000+ 行动,支持如 Gmail 发送邮件等自动化任务,需配置服务器端点并设置 GPT-4o 提示词控制调用。
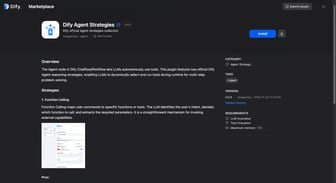
Dify BlogDify 正式推出 Agent Strategy 插件,使工作流节点能将固定流程外的步骤交由 LLM 自主决策。Agent Node 作为执行单元,管理资源与推理过程;Agent Strategy 是可插拔的推理算法模块,定义工具使用与问题解决逻辑。
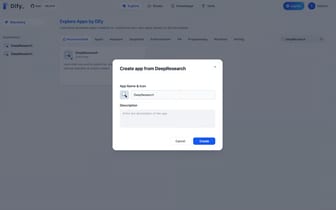
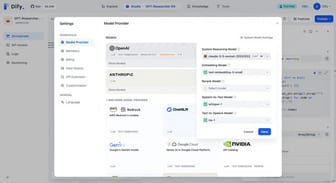
Dify BlogDify 通过节点迭代、搜索和总结,实现多步研究自动化应用 DeepResearch。该应用使用 LLM 生成查询和总结,支持 8k 上下文窗口,需 DeepSeek 和 Tavily API,部署在 Dify 平台。
Dify Blog6565Dify Workflow 通过并行模式和高级迭代功能,加速 GPT-Researcher 的研究任务,将问题分解为 4-6 个独立子问题,并行提取主题形成子标题、调用 Tavily API 搜索并分析结果,最终整合为结构化报告,显著缩短研究时间并隔离错误处理。
Dify Blog6565Dify.AI 和 LangChain 是两种流行的 AI 应用构建工具。Dify.AI 通过可视化工作流界面使非技术人员也能快速开发 LLM 应用,显著降低开发时间和复杂度;LangChain 则需要用户自行编码调试。Dify.AI 拥有 BaaS 架构、RAG 和丰富 API 等功能,并依靠专家团队确保高负载下的可靠性能,而 LangChain 依赖第三方代码贡献可能存在维护问题。
Dify Blog6565Dify通过可视化提示词编排、操作、数据集管理及内置RAG引擎,让开发者快速构建AI应用。用户可输入目的地、天数或预算,AI旅游顾问能结合维基百科和谷歌搜索生成行程,并提供当地住宿餐饮信息、价格和评价。Dify支持部署类似Assistants API的功能,基于任何流行LLM运行,并采用gpt-4-1106-preview模型效果更佳。
Dify Blog开发者利用 OpenAI 的 GPT API 时,AI 可能无法产生预期输出或表现“不合作”,为应对这些挑战并提升 GPT 性能,需遵循三个关键步骤:通过提示工程指导模型行为,使用单点或少样本学习技术,以及利用嵌入扩展模型上下文,并可通过微调使模型适应特定领域。
Dify Blog6565开发 ChatGPT 插件可扩展 AI 客户端功能,通过 API 集成附加功能。开发者需创建描述插件功能的 ai-plugin. 文件,并部署到 Serverless 平台,如 AWS Lambda。Dify 支持集成内部和第三方插件,实现 AI 应用编排。