Ollama releases
Liquid AI 发布 LFM3 小模型家族及 d1 决策模型 v0.40.12-rc1
Liquid AI 发布 LFM3 小模型家族,包含 1.7B 参数文本模型 lfm3 及支持图像、音频功能的变体,上下文窗口达 256K tokens;d1 决策模型升级至 2B 参数,支持文本、图像及音频推理,Apple 硬件已支持 rc1 版本。
Ollama releasesLiquid AI 发布 LFM3 小模型家族,包含 1.7B 参数文本模型 lfm3 及支持图像、音频功能的变体,上下文窗口达 256K tokens;d1 决策模型升级至 2B 参数,支持文本、图像及音频推理,Apple 硬件已支持 rc1 版本。
 NVIDIA Blog
C-BRAIN 与 NVIDIA 正利用 AI 改变痴呆症研究进程。他们通过整合此前未公开的阿尔茨海默症研究数据,包括未发表结果和受管制的专有数据,加速新疗法研发。C-BRAIN 运用混合集中式和联邦式架构保护数据隐私,部署 64 块 NVIDIA 数据中心 GPU 及云端节点,并计划引入 NVIDIA Blackwell 系统以支持其扩展目标。
 Hugging Face Daily Papers6565
AV-FABLE 引入一个用于长视频稀疏篡改的音频视觉基准,表明冻结的音频视觉大语言模型的感知特征包含最佳通过分离时间解码器而非语言输出恢复的取证证据。长视频中的局部 AI 篡改通常影响其他内容真实的短暂事件,使视频级分类不足以进行取证分析。
 Browser Use
 和 Browserless 都支持现有脚本和 AI 工作流,但价格、API 和部署选项不同。Browser Use 提供 Chromium 基础设施和托管浏览器代理,价格按小时 $0.02 计算,免费层级提供 $1 信用额度;Browserless 则支持 Firefox/WebKit,提供专用截图/PDF API,价格基于单位,原型层级每月 $25。
 Codex releases55
GitHub Copilot rust-v0.166.0-alpha.2 发布。
 量子位6666
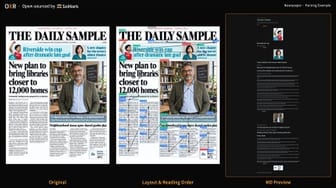
OXR开源模型在OmniDocBench、olmOCR-Bench和DocParsingBench三项基准测试中全部登顶,完整解析速度超过PaddleOCR-VL-1.6和MinerU2.5-Pro
量子位6262Hi3D V1.0模型生成效果优于GPT-6 Astra,是首个可商用2048³超高精度国产自研AI 3D模型,基于约200万个筛选3D资产训练,多视图保真度0.75、细节丰富度0.841排名第一,已开源代码并支持在线Demo。
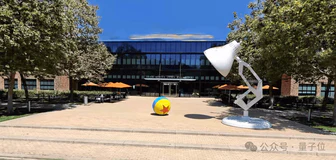
量子位5858皮克斯官方3D渲染教程感谢中国公司禾赛科技提供的3D场景扫描方案Kosmo,该终端集成激光雷达、超高清影像系统、一英寸大底CMOS、高精度IMU,可在15-20分钟内采集100平米空间的真实3D高斯泼溅数据,直接输出可用于AI模型训练、可操控编辑、空间关系/色彩形状不失真的3维数字模型,为影视娱乐和具身智能领域提供真实世界数据引擎。
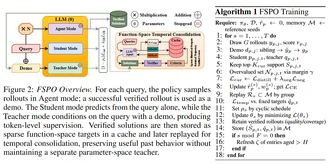
Hugging Face Daily Papers6565函数空间策略优化(FSPO)框架通过存储稀疏历史下一词分布作为固定时间目标,结合特权适应与函数空间时间整合,显著改进了 SDPO 方法,无需维持持久教师模型即可实现时间分离。
 MarkTechPost精选同一件事 · 2 家7171
百度开源 Unlimited OCR 2,一个 3.34B 参数的 OCR 视觉语言模型,可在单次请求中解析数百页书籍、财报和报告,权重以 MIT 协议发布,代码在 GitHub。
推荐理由: 原文给出 SR-SWA 的稀疏注意力机制与百页文档基准对比,可看长文档 OCR 的上下文成本如何被压平。
MarkTechPost5858vLLM Semantic Router 团队发布 d3-ultra,这是一款 26.09B 参数(含 0.46B 视觉编码器)、上下文长度 131,072 token 的 27B 开源多模态决策模型。
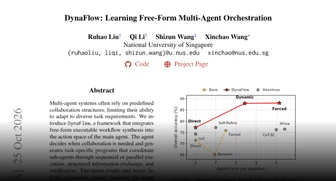
Hugging Face Daily Papers3838DynaFlow 通过让主智能体合成可执行的流程来协调子智能体,实现自适应多智能体协作。该框架在主智能体的动作空间中集成了自由形式的可执行流程合成,主智能体决定何时需要协作并生成特定任务的程序,通过顺序或并行执行、结构化信息交换和验证来协调子智能体。
 蚂蚁 inclusionAI · Hugging Face 新模型5858
SingProbe 是一个基于 Qwen/Qwen3.8-Flash-Next 的流式安全探针,通过复用基础模型的隐藏状态在生成时每一步评分查询意图、响应不安全性和幻觉风险,解码时开销不到 0.5%。
蚂蚁 inclusionAI · Hugging Face 新模型5858inclusionAI 发布基于 GLM-5.3-Flash 的轻量级流式安全探针 SingProbe,通过复用基础模型的隐藏状态实时评分查询意图、响应不安全性和幻觉风险。
Codex releases00Rust v0.165.0-alpha.1.2 发布,包含 143 个主要提交。
 Sakana AI
2026年,Sakana AI 发布了 Sakana Chat、Sakana Marlin、Sakana Fugu、Sakana Translate 等产品,从研发公司转向产品交付阶段,其 GTM 团队于 2026 年 9 月正式启动。
蚂蚁 inclusionAI · Hugging Face 新模型3838inclusionAI/Ling-3.0-flash-Sante-fp8 发布 FP8量化版本,保留124B参数(5.1B/Token)与BF16性能,降低内存并提升部署效率,支持医疗推理、研究及工具辅助工作流,需专业人工审核。在Healthbench、ReDisQA等基准上表现稳定,通过块状FP8量化(128×128块)实现高效推理。
 Gemini CLI releases1212
Gemini CLI v0.67.0-nightly.20261027.g363a13119 发布,修复了项目支出上限错误分类、MCP服务器和工具元数据权限请求、命令行聊天列表自动补全和数值设置编辑器验证问题,新增贡献者 @duvanka-prasad
 Databricks Blog
Lakeflow Connect 通过原生连接器支持维基、项目管理工具和 AI 基础模型,使下游 AI 智能体获得完整业务上下文。该平台提供全面管理的原生连接器,支持 SaaS 应用、数据库和文件源,数据直接导入 Databricks 平台,通过点选式 UI 或 API 配置,增量导入 Unity Catalog 表格。
Codex releases1010GitHub Copilot rust-v0.166.0-alpha.1 发布,版本号 0.166.0-alpha.1。
Browser Use使用 JSON Schema 定义目标数据结构,并在所有网站上应用。对于静态页面,获取干净的页面文本(Markdown),让 LLM 填充该 Schema。仅对需要登录、点击或 JavaScript 流程的页面使用浏览器代理。
 Claude Code releases1515
Claude Code v2.1.311 发布,新增 --hold-idle-file 和 --max-hold-min 参数以保持空闲会话,同时修复了启动时和文件读取/编辑后的卡顿问题。
 LangChain Deep Agents releases1212
LangChain QuickJS 0.3.10 发布,修复了 PTC 提示词缓存问题,现在按槽位和工具身份缓存提示词。
 LangChain Blog5858
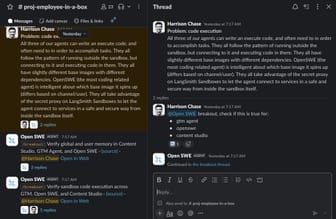
LangChain 内部智能体通过 Slack 集成,以用户身份或固定凭证执行任务,具备全局与用户级记忆,在沙盒中执行代码,并支持后台调度运行。其架构包含 GTM、OpenSWE 和 Content Studio 三种智能体,分别处理 GTM 活动、工程代码审查和营销内容创作,通过“ breakout”功能优化用户体验,并解决身份认证等核心问题。
 Transformers releases6565
OpenBMB 的 MiniCPM-OCR 模型发布 v5.21.0 版本,采用 SigLIP 视觉编码器和 Qwen3.5 语言模型,专用于读取扫描页、截图。
 Apple Machine Learning Research
GHARP 方法通过少量输入图像和表情信号实时动画化 3D 人头,分为离线的身份阶段(构建几何与外观表示)和运行时的动画阶段(预测表情残差)。该方法在预训练重建模型的语义结构潜在空间中执行动画,使表情变化空间受限,实现高效残差预测,并在 Ava-256 基准上达到 SOTA 质量,A100 GPU 速度提升 13 倍、高斯数量减少 8 倍。
LangChain Deep Agents releases55LangChain Modal 0.0.7 发布,修复了文件权限和目录错误。此次更新提升了包的稳定性。
 AWS Machine Learning Blog4848
使用 AWS CDK 在 Amazon Bedrock 管理知识库上构建企业级智能检索,通过 AgentCore 提供的推理代理和 AgenticRetrieveStream API 实现多轮规划和工具驱动检索,返回带引用的答案。该方案部署包含 Amazon S3 语料库、知识库和推理代理的 CDK 应用,支持语义路由和多次检索,并内置 Amazon CloudWatch 监控和评估功能。
 Meta Engineering5858
Meta 在 2026 OCP 全球峰会上分享了支持其最新 AI 模型 Muse Wonder 和 Muse Spark 及 Prometheus 集群的网络创新。
 IBM Research Blog5858
IBM 和 PyTorch 基金会宣布 Spyre 加速器将成为 PyTorch 的第一类后端并支持多加速器调度。torch-spyre 编译器、Spyre vLLM 插件及持续集成工作使模型和流程能运行在 Spyre 上,该架构针对推理优化,适合 IBM Z、LinuxONE 和 Power 系统。
量子位精选7878岩山科技旗下岩芯矩阵联合港科大、CMU 等高校发布并开源 EdgeRock-4B,在 256K 上下文下 KV Cache 固定为 72MiB,相比源模型 Qwen3.5-4B 减少 99.1%。
推荐理由: 原文给出固定内存下的吞吐与基准对比,可据此判断长上下文推理的显存成本走向。
MarkTechPost6666清华大学和港大研究人员开源 AKV,为 LLM 智能体提供 KV 缓存工程服务。通过丢弃选定缓存条目并重用其余部分,在 3 个模型和 4 个智能体基准测试中,平均成本降低 27.7%,平均任务分数提升 1.7 分。
Hugging Face Daily Papers3131Omni-Woodpecker 是一种无需训练的框架,通过识别模态冲突并重平衡隐藏表示来减少全模态大模型的跨模态幻觉,在 CMM 和 AVHBench 上将 Qwen2.5-Omni-7B 提升了 12.9 和 8.6 分,并在四个通用 OLLM 推理基准上持续提升 0.67-2.25 分,代码开源。
 Hacker News · AI 热帖
OpenAI 和 Anthropic 在数月内将 LLM 价格最高下调 80%。OpenAI 将 GPT-5.6 Luna 的价格下调 80% 至 $0.20 / $1.20 / $0.02,GPT-6 Sol 和 Luna 的输入输出价格分别下调 50% 至 $2 / $10 / $0.20 和 $0.10 / $0.50 / $0.01。
蚂蚁 inclusionAI · Hugging Face 新模型1010inclusionAI 发布 LBS-27B 大语言模型,参数规模为 27B,但未提供 README 内容和具体基准分数,当前未部署任何推理提供商。
Hugging Face Daily Papers4949RSIHub 是一个开源框架,通过提供可重用组件和一致评估的标准基础设施,规范智能体进化研究,用于构建、比较和扩展相关方法。研究人员可专注于进化策略,而评估保持在外部,结果与候选者和评估条件相关联。
 IT之家 · AI精选7171
小米技术委创新产品团队孵化的开源 AI 硬件 HachimoDock 在 2026 观猹大会亮相,硬件自制成本约 150 元。该设备集桌宠、语音操控电脑端 Agent、智能家居联动和自定义组件生成于一体,可将语音意图分发给 Codex、WorkBuddy 等 Agent,并联动小米 Miloco 控制家居。软件源码已在 GitHub 公开,同时提供硬件物料清单、结构件模型和装配教程。
推荐理由: 小米公开了这款桌面 AI 硬件的源码、物料清单和装配教程,读者可据此判断低成本自制 AI 硬件的门槛。
 Mastra Blog6565
Mastra 通过在 Slack 中部署智能体,将公司级知识图谱 Knowledge 应用于内部问答,提升代码生成质量;该工具整合团队协作系统信息,支持按功能分区和权限控制,已与多家企业合作,现向更多设计伙伴开放。
 36氪 · AI6565
Vivix发布实时交互模型W1和A1,目标降低互动内容生成成本至YouTube水平。W1模型实时生成成本接近YouTube每小时约0.2美金的CDN带宽成本,与目前最头部的视频生成模型相比,实时互动内容的生成成本可低1-2个数量级,用户操作后模型能在300-600毫秒内生成下一帧画面。Vivix团队规模已达150-160人。
MarkTechPost5252斯坦福和伯克利研究者推出 TokenGate 模块,通过学习型 token 剪枝技术,使长上下文预填充速度提升 1.4 至 11.3 倍且不损失精度,峰值预填充内存消耗降低 1.5 至 3.4 倍,在 5 项任务上优于 6 个基线模型,最佳表现时 NIAH 16k 任务速度提升 11.3 倍、内存降低 3.42 倍,代码和检查点已开源。