AWS Machine Learning Blog3434
在 Amazon SageMaker JumpStart 上部署 OpenFold3:预测生物分子结构
OpenFold3-preview 可在 Amazon SageMaker JumpStart 上部署,该开源生物分子结构预测模型由 OpenFold Consortium 和哥伦比亚大学的 AlQuraishi Lab 开发,支持蛋白质、DNA、RNA、小分子配体及其复合物的 3D 结构预测。
AWS Machine Learning Blog3434OpenFold3-preview 可在 Amazon SageMaker JumpStart 上部署,该开源生物分子结构预测模型由 OpenFold Consortium 和哥伦比亚大学的 AlQuraishi Lab 开发,支持蛋白质、DNA、RNA、小分子配体及其复合物的 3D 结构预测。
 Codex releases00
GitHub Copilot 发布 0.171.0-alpha.5 版本,提供代码审查、漏洞检测和秘密扫描等功能,支持企业级代码安全和 AI 特性。
 LangChain Deep Agents releases1515
LangChain Deep Agents 的 deepagents-code 模块发布 0.2.8 版本,新增在本地 shell 环境中设置 `DEEPAGENTS_CODE=1` 的功能,并修复了重定向输出中的不可编码字符问题。
LangChain Deep Agents releases1212langchain-modal 0.0.8 发布,修复了 `ModalSandbox` 文件 I/O 问题,更新为使用 `Sandbox.filesystem` API
AWS Machine Learning Blog4242Amazon SageMaker HyperPod 现在提供 Data Capture 功能,将实时推理输入输出记录到 Amazon S3,分为三个独立层级,最小化延迟影响。
 Hugging Face Blog
使用 UR17G 手臂、Robotiq 2F-140 夹爪和饮料罐在 Isaac Sim 中构建抓取放置模拟,需检查关节、运动和接触行为。SimReady Central 提供资产模型和模拟设置,并使用 GPT-6 Sol 生成任务代码。
 Meta Engineering
Meta 将 Android 虚拟设备框架 Cuttlefish 原生移植到 macOS,通过支持 QEMU 和 vhost-user,解决在 Apple Silicon 上运行虚拟设备的技术难题,提升开发效率并统一测试环境。新版本支持 macOS 的显示、签名和构建流程,并扩展了蓝牙、Wi-Fi、3D 图形等特性,使 Mac 开发者可使用与 CI 相同的高保真虚拟设备。
Codex releases00GitHub Copilot 0.171.0-alpha.4 发布,包含代码审查、漏洞检测和秘密扫描等安全功能。
LangChain Deep Agents releases2020LangChain Deep Agents 0.7.38 发布修复了当软链接解析超出批准搜索范围时,`ls`、`grep` 和 `glob` 会错误返回结果的问题。
Hugging Face Blog精选6565llama.cpp 与 ggml 发布 v1.0.0,将公共 C API 的破坏性变更与主版本号绑定,后续两者都按语义化版本规则发布。项目已支持超过 150 种模型架构和主流投机解码方法,并提供 Linux、macOS、Windows、Android、iOS 的预发布产物及 Docker、Homebrew、conda-forge 等分发渠道。
推荐理由: llama.cpp 与 ggml 同步发布 v1.0.0,并明确主版本号对应 C API 破坏性变更,下游依赖者可据此规划升级节奏。
 NVIDIA Newsroom
Dyania Health的Synapsis AI通过分析患者全部病历记录,连接多年间隔的发现以回答临床问题,帮助医护团队识别需要关注的患者及原因;该系统基于NVIDIA NeMo、TensorRT和TensorRT-LLM构建,在医疗机构内部运行以保护数据安全,已在克利夫兰诊所支持超过7800名主动脉瓣置换患者的长期随访研究。
 蚂蚁 inclusionAI · Hugging Face 新模型
inclusionAI 发布 Duo 1.2 causal-base 模型,这是一个用于实时音视频交互的全双工多模态世界模型,包含改进的生成质量,模型权重可在 Hugging Face 下载。
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI 发布 Duo-1.0-distill,一个用于实时音视频交互的全双工多模态世界模型,包含四步蒸馏的 Realization 权重,需与 causal-base 套件叠加使用。
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI 发布 Duo 1.0 causal-base 模型,这是一个用于实时音视频交互的全双工多模态世界模型,包含实现权重和主干、意图模型和适配器、音视频编解码器、语音识别器和强制对齐器。该模型权重基于 MiniMax H3 初始化,并已开源。
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI 发布 FP8-量化四步蒸馏的 Duo 1.0 Realization 权重,用于其因果基础模型,支持全双工实时音视频交互,需与因果基础模型权重叠加使用。
Codex releases00GitHub Copilot 0.171.0-alpha.2 发布,该 AI 编码智能体用于任务、项目和自动化工作,支持代码审查、协作和云端开发环境。
Codex releases00GitHub Copilot rust-v0.171.0-alpha.3 发布,该版本用于代码审查和协作。
蚂蚁 inclusionAI · Hugging Face 新模型SingVL-4B GGUF 是基于 Qwen3.5 的 4B 参数多模态决策模型 Sing VL S1 的 GGUF 版本,可对文本或 JSON 及最多四张图像回答命名问题,并使用完整前向传递评分选项,在 Text 评测中得分为 69.76,Vision 评测中得分为 73.94。模型使用 llama.cpp 适配器,默认上下文容量为 4096 token,支持文本和图像输入。
Codex releases00GitHub Copilot 发布了 0.171.0-alpha.1 版本,提供代码生成、审查、安全检测等功能,支持企业级集成与支持服务。
 Databricks Blog2222
Lakebase 架构通过单一持久化数据副本服务于 Postgres 和分析,无需 CDC 管道或第二数据库。该架构将数据分层存储于对象存储和缓存中,并非传统复制。其支持点查和扫描两种访问路径,使用 Postgres 堆页和 Parquet 格式分别优化,且无额外同步任务。
AWS Machine Learning BlogSGLang-Neuron 通过 AWS Deep Learning Container 公开可用,支持在 AWS Trainium 上使用 SGLang 推理和强化学习部署,采用与 SGLang 相同的接口,运行在原生 PyTorch 上,支持 PD disaggregation 和 10240 token 上下文长度。
LangChain Deep Agents releases1515LangChain Deep Agents SDK 修复了可选提示词缓存的查找缓存问题,更新了依赖项最低版本要求。
Databricks BlogEclipse Aerospace 与 Databricks 合作,通过 PySpark 自定义数据源将近 20 年的专有飞行数据(总计 3TB)更便捷地用于服务中心和工程师,无需额外基础设施。
Codex releases00GitHub Copilot 发布 0.170.0-alpha.4 版本,提供代码审查、安全漏洞检测和密钥扫描等功能。
Hugging Face Blog精选7171IBM 在 Hugging Face 发布 LLMON(LLM 对象符号)标记语言,并推出基于 Granite 4.1 的 granite-4.1-3b-LLMON-preview 和 granite-4.1-8b-LLMON-preview 两个实验性预览模型,同时开源 GitHub 工具包。
推荐理由: 原文给出 LLMON 标记语言的设计动机与两个预览模型,读者可据此理解指令与数据分离如何降低间接提示注入风险。
Databricks BlogH6.ai 在客户现有 ERP 上自动化应付账款处理,通过读取发票、匹配采购订单、分配会计科目并对照公司政策执行,结合 AI 辅助理解与确定性政策执行。其采用 Lakebase Postgres 为每位客户建立专用数据库,存储采购订单、供应商、会计科目、历史交易和政策等财务上下文,支持频繁回归测试。
Codex releases00GitHub Copilot 发布 0.170.0-alpha.3 版本,提供代码审查、安全漏洞检测和密钥扫描等功能。该版本适用于企业级用户,包含高级 AI 功能和 24/7 支持。
Databricks BlogBlock 公司推出 Buzz 开源协作空间,让员工与 AI 智能体在共享工作区互动。通过 Databricks Unity Gateway,用户可访问 OpenAI、Anthropic、Google 等前沿模型及开源模型(原文未提具体数量),实验不同智能体框架组合。员工能创建 AI 智能体并选择模型(如包含 Goose 轻量版),实现多人协作开发、分析等任务。
LangChain Deep Agents releases3535LangChain Deep Agents v0.7.36 发布,修复了 `FilesystemBackend.download_files` 在 FIFO 文件上挂起的问题,并新增了将代理后端传递给请求它的中间件、记录子代理检查点命名空间到 `task` 工具消息等功能。
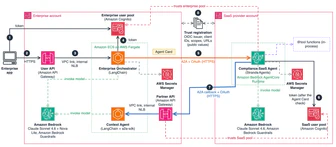
AWS Machine Learning Blog5555AWS 推出 Agent-to-Agent (A2A) 协议,使跨组织边界运行的多智能体系统能够通过标准化协议发现彼此、通信和交换任务,无需暴露内部细节或依赖相同框架。
 PyTorch Blog
两人的团队借助 AI 编程智能体,在不到一周内完成了 SGLang 与 IBM Spyre 的集成,构建了一个约 1,500 行代码的插件。SGLang 在 Spyre 上的推理吞吐量比参考 PyTorch 实现(使用 torch-spyre)高约 3.6 倍,并在 Granite 3.3 8B 和 Gemma 4 26B A4B 工作负载上与 vLLM 性能相当。
PyTorch BlogEUROPA联盟在JUPITER超级计算机上使用PyTorch和TorchTitan成功训练了参数量达951.9B的MoE模型,将单GPU的吞吐量从90提升至约1,300 tokens/s,使用了384个NVIDIA GH200 GPU。
 vLLM Blog精选6060
vLLM-Omni 团队将 MiniMax H3-Image 接入 NVIDIA Vera Rubin,四卡 SP4 配置下原生 4096×4096 文生图短提示词基准中位延迟 0.87 秒,四副本 SP1×DP4 吞吐达 6115 张/小时。
推荐理由: 原文给出 H3-Image 在 Vera Rubin 上的实测延迟、吞吐与跨硬件部署配置,可据此判断 4K 图像生成的部署成本。
 LangChain Blog
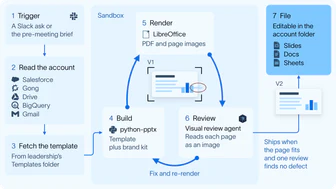
LangChain 内部 GTM Agent 在 12 周内为销售代表生成 1540 份售前物料,使销售效率提升 47%(发送物料交易进入下一阶段的概率从 16% 提升至 47%),平均每份物料节省 3.37 小时人力成本。
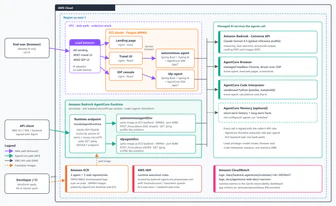
AWS Machine Learning BlogJava 团队可以利用 Amazon Bedrock 和 Spring AI 构建自主 AI 智能体,解决可扩展性、治理、安全和运维问题。Spring AI 通过 Spring 模式(自动配置、依赖注入、可组合顾问)为 JVM 带来 AI 能力,而 Amazon Bedrock AgentCore 平台支持框架和模型无关的智能体构建、连接和优化。
Codex releases00GitHub Copilot 发布 0.170.0-alpha.2 版本,提供代码审查、漏洞检测和密钥保护等功能。
AWS Machine Learning Blog5858Amazon SageMaker HyperPod 通过在 PyTorch DDP 训练循环中添加三项检查来检测无声数据损坏(SDC),包括非有限梯度检查、环形重放审计和权重指纹比较,当检测到问题时将可疑节点隔离并由 HyperPod 替换,已在 4 ml.p5.48xlarge 实例集群上测试验证。
AWS Machine Learning Blog3838Claude Haiku 5.5 发布,成本比 4.5 版本低 75% 并支持成本控制;GPT-6.1 Terra 在 OpenAI 评测中表现与 GPT-6 Astra 相当且速度更快三倍。
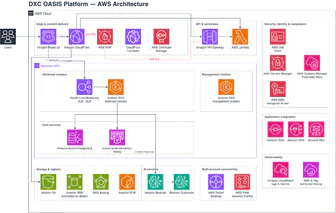
AWS Machine Learning Blog3838DXC Technology 在 Amazon Bedrock 上构建的多模型 AI 基础设施通过统一 API 访问 Anthropic Claude、Amazon Nova、Meta Llama 和开源模型族,并使用 Amazon Bedrock Guardrails 实施内容过滤和 PII 匿名化。
AWS Machine Learning BlogAWS CloudTrail 捕获 Amazon Bedrock AgentCore 中 AWS Agent Registry 的 UpdateAgentRuntime API 调用事件,Amazon EventBridge 将匹配事件路由至 AWS Lambda 函数,Lambda 函数查询 MCP 服务器当前工具并更新匹配的 Registry 记录。