Claude Code releases4040
Claude Code v2.1.305 发布
Claude Code v2.1.305 发布,新增 sandbox.allowNestedUserNamespaces 支持 Linux 下用户命名空间创建,修复了 Vertex、Bedrock 等平台因工具搜索被拒绝导致请求失败的问题,以及 /effort 和 /autocompact 设置未生效等 Bug。
Claude Code releases4040Claude Code v2.1.305 发布,新增 sandbox.allowNestedUserNamespaces 支持 Linux 下用户命名空间创建,修复了 Vertex、Bedrock 等平台因工具搜索被拒绝导致请求失败的问题,以及 /effort 和 /autocompact 设置未生效等 Bug。
 Hugging Face Blog精选6666
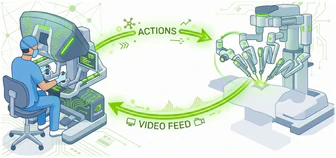
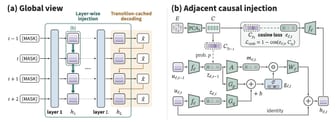
NVIDIA 发布 Cosmos3-H-Dreams,把交互式生成模拟扩展到临床胆囊切除场景,可依据器械动作实时生成手术画面。
推荐理由: 原文交代了从桌面缝合到临床胆囊切除场景的迁移路径,以及四步与两步蒸馏检查点之间的质量与延迟取舍。
 AWS Machine Learning Blog3838
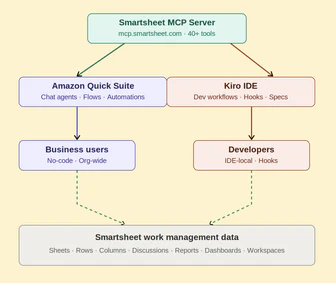
Smartsheet 推出通用模型上下文协议 (MCP) 服务器,使 AI 助手能通过标准化协议读写管理 Smartsheet 数据;支持 Amazon Quick 和 Kiro 连接,Quick 供知识工作者和运营团队自然语言查询更新 Smartsheet,Kiro 让开发者能参考项目规格和更新任务状态,无需离开编码环境。
Hugging Face Blog5858ALTK-Evolve 使用 GPT-4.1 学习并应用客户服务剧本,在 τ²-bench 客户服务代理基准测试中超越零售领域所有零售条目,得分达 67.5% Pass^4,且无需更新模型权重。该模型基于基本 ReAct 代理和 GPT-4.1,通过分析任务尝试并使用 GPT-4.1 将成功与失败蒸馏为简短行为规则,然后将这些指南添加到代理的系统提示中,无需权重更新或人工标注。
 Sakana AI
 举办第二次工程师开放日,涵盖五个职种,介绍各部门工作内容,展示金融和防务领域应用,强调AI主权战略及产品线扩展。
 IBM Research Blog
llm-d 项目宣布发布 1.0 版本,这是一个 Kubernetes 原生的分布式推理服务网络,支持在任何加速器上、任何云中部署任何模型的推理栈。该版本增强了多租户服务质量、零停机操作和智能体感知服务,以在常见生产操作中实现持续性能。通过前缀缓存感知路由和 KV 缓存卸载等技术,llm-d 1.0 可捕获 97% 的可用缓存重用,降低大规模 AI 服务的成本。
 Gemini CLI releases77
Gemini CLI v0.66.0-nightly.20261020.g76e4d7c04 发布,修复了视口刷新时保留终端滚动回溯的 UI 问题,以及解码流式 Node HTTP 活动块的 CLI 问题。
Hugging Face Blog5858AnyLanguageModel 1.0 发布,一年支持苹果平台本地模型进展。新增支持 OpenAI Chat Completions、Anthropic Messages、Google Gemini 等云端模型,本地模型支持 llama.cpp、MLX、Core ML,工具调用与引导生成功能扩展。云端模型具备本地模型相同功能,API 密钥支持闭包动态获取。
 Google Developers Blog
Meta 的 TorchTitan 集成 TorchTPU 使 PyTorch 模型可在 Google Cloud TPU 上原生训练,仅需少量代码更改。
Google Developers BlogCoral NPU 发布了完整的 32 位架构,包含新的矩阵执行单元,支持高达 1 TOPS 性能和 10mW 平均功耗;推出基于 IREE/MLIR 的 Coral Compiler v1.0。
Google Developers BlogArm 利用 Google AI Edge Model Explorer 的分层图可视化和插件架构,开发了支持 TOSA、VGF 和 PTE 等格式的开源适配器,帮助开发者更便捷地检查边缘模型转换流程。
Hugging Face BlogHugging Face 发布 TorchTPU,使 TPU 成为 PyTorch 的原生后端设备。Transformers、Diffusers 和 Kernels 现可直接在 TPU 上运行,用户只需从 Hugging Face Hub 选择模型,指定 device_map="tpu" 即可。
 Claude · YouTube
Claude 推出 Claude Dashboards 和 Claude Motion,前者在所有付费计划中支持将数据平台或 CRM 数据实时转化为仪表盘,后者在 Team 和 Enterprise 计划中支持将报告或图表生成动画解释视频,两者均以代码形式生成无需视频模型,可修改内容后导出 MP4 或编辑。
 腾讯混元 · Hugging Face 新模型
Tencent 混元发布的 Hy-Memory-30B-A3B-GGUF 模型量化文件采用 imatrix 校准和 MoE 感知的混合精度量化方案,在 llama.cpp 上实现高效本地推理,其中 ~8 GB 的 expert-mixed 构建文件大小降至约 24.71 GB,性能仅比 Q6_K 下降 1.53%。
 Together AI Blog
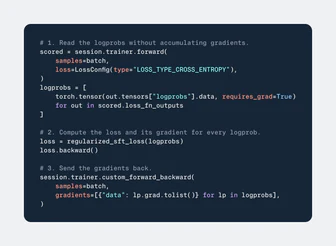
Together AI 推出 Post-Training 服务,支持通过强化学习和监督微调构建定制模型,无需复杂基础设施。该服务提供灵活的训练循环定义能力,并优化底层系统与基础设施以提升模型质量与训练速度。支持 Muse Spark Open、GLM 5.3、Kimi K3 和 Qwen 3.8-27B 等主流开源模型,运行在专属 GPU 资源上,确保高效且数值一致的训练。
 NVIDIA Blog
NVIDIA RTX Spark 笔记本电脑开始发售,配备 Blackwell RTX 显卡、最高 128GB 联合内存和完整的 NVIDIA AI 平台,起售价 2399 美元,由华硕、戴尔、惠普、联想、微软和微星推出,为便携设备带来强大的本地 AI、内容创作和游戏能力。NVIDIA 在全球举办发布会庆祝,包括柏林活动,创始人黄仁勋惊喜现身。
 LangChain Deep Agents releases1717
LangChain Deep Agents 发布 0.1.86 版本,新增 NVIDIA OpenShell 作为沙盒提供者,修复了多个 Bug,包括改进别名匹配、准确报告工作区拒绝、替换重复线程恢复错误、在调回提示时替换聊天输入、在页脚显示过期提示缓存、在 Groq 工具限制时提供可操作错误、比较有效解释器权限等。
AWS Machine Learning BlogAmazon Bedrock AgentCore 评估框架帮助 AWS 内部销售团队用多智能体系统处理业务问题,发现智能体在演示和实际生产中表现差异;通过 Amazon Bedrock Guardrails、Amazon CloudWatch 等服务,该框架在发布前和持续生产中验证答案准确性,将错误溯源至数据、提示词或代码,避免因智能体回答看似自信却错误导致用户信任破裂。
LangChain Deep Agents releases1010LangChain Deep Agents 0.7.28 发布,修复了 `ContextHubBackend.glob` 方法未正确处理 `path` 参数的 Bug。
LangChain Deep Agents releases3535LangChain Deep Agents 0.7.27 发布,修复了将子智能体名称传递给子智能体的 Bug,并新增了向主智能体异步报告子智能体状态更新的功能。
腾讯混元 · Hugging Face 新模型混元发布 Qwen3-8B-DSpine-b16,采用并行草稿与深度条件注入的推测解码技术,在 Qwen3-8B 上实现 10.55 的平均接受长度分数。模型支持 8192 token 上下文长度,使用 bfloat16 数据类型和 fa3 注意力后端,安装需 git clone 并 pip 安装,通过 sglang serve 运行。
腾讯混元 · Hugging Face 新模型混元发布的 Hy-Memory-30B-A3B-FP8 是一个 3B 活跃参数的紧凑长期记忆写入模型,用于高效 vLLM 部署,在固定 20% 基准矩阵的跨 harness 宏平均得分中表现优于 Claude Opus 5 和 DeepSeek V4.1 Flash。
 Ollama Blog
Reflection 的首个开源权重模型 Beam 已于今晨全面推出,Ollama 作为首发合作伙伴限时免费提供该模型,其 Beam 端点支持完全零数据保留(ZDR)。
NVIDIA BlogNVIDIA RTX Spark 首次亮相,专为创作者、游戏玩家和 AI 智能体打造,性能惊艳,支持本地 AI 工作流、创意应用和游戏,获多家评测机构高度评价,全球多地举办发布活动。
 Google DeepMind
Google Antigravity 平台通过其智能体工作台和 ProtNLM 模型,帮助生物学家快速发现、结构评估和优先排序有潜力的抗菌肽靶点,将以往分散在多个数据库的搜索压缩为单次会话。该平台利用 ProtNLM 预测蛋白质功能,并支持研究人员扫描 UniProt 数据库中数百万个未表征的蛋白质。研究人员与 AI 代理在共享的 3D 画布上协作,将抗菌肽发现流程所需时间从数天压缩至单次会话。
 LangChain Blog
LangChain 推出 LangSmith AI Search、Managed Deep Agents v0.9、LangSmith Engine v2 等新功能,帮助团队更灵活构建、理解和优化生产环境中的 AI 智能体;开源 LangChain v1.4.0 支持 FastMCP,并分享 Jev 与 LangGraph 结合构建高效智能体的案例。
NVIDIA BlogNVIDIA 发布 120B 参数的 Nemotron 3.5 Super VL 开源模型,在多模态智能体任务中实现最快任务完成速度和最高准确率;同时推出 Nemotron 3.5 Bolt 74B-A9B 24GB 和 Nemotron 3.5 Bolt E4B 4GB 边缘模型。
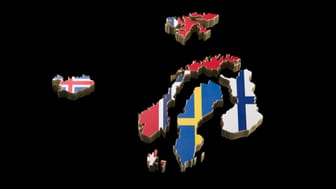
NVIDIA Blog北欧地区已成为欧洲独角兽企业密度最高的地区,每百万人口诞生最多价值10亿美元的初创公司。NVIDIA在过去一年中投资了北欧的技术生态系统,包括瑞典的Lovable和Legora等领先初创企业。
Together AI BlogMeta Muse Spark Open 已在 Together AI 平台上线,这是目前最强大的美国开源重量模型,专为需要将整个代码库保存在上下文中的长时间运行智能编码工作流程而构建。
Google Developers Blog谷歌推出 ADK-Recipes 仓库作为 Agent 平台内容单一事实来源,包含核心模式、插件技能和服务,支持终端构建长时程记忆代理、一键安装零售垂直技能,并部署到 Cloud Run 或 Gemini Enterprise。
LangChain Deep Agents releases1717deepagents-code v0.1.85 发布,修复了在根安装时抑制所有权警告的 bug,并通过避免在插入消息时重置转录历史提升了性能。
 Mistral AI · Hugging Face 新模型
Mistral AI 发布 Timestral-123M 时间序列基础模型,参数量 123M,采用 patch-based Transformer 架构,上下文长度 32,768 时间步,单次预测可覆盖 1,024 时间步,输出 21 个分位数。该模型在 GIFT-Eval、TIME 和 fev-bench 评测中实现零样本预测的最优精度,并采用 Modified MIT 许可证。
 Google Research
谷歌发布Geospatial Reasoning智能体,集成Earth AI基础模型(含WeatherNext、PDFM等)及Google Maps等数据源,通过模块化技能与规划能力处理行星级地理数据。
Google Research谷歌发布Deep Review智能文档验证系统,提供复杂文档的严格反馈和技术验证,支持PDF和纯文本输入,每周免费2次审核,通过API高级集成,已与STOC 2026、ICML 2026等4个顶级计算机会议合作,处理超16,000篇论文预提交反馈。
Google ResearchGoogle Research发布10项新成果,包括Google Earth AI(集成70种地理空间工具,含RSFM和PDFM基础模型,支持公共卫生威胁预测等)。
 蚂蚁 inclusionAI · Hugging Face 新模型
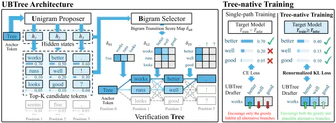
inclusionAI 发布 Ling-3-Flash-UBTree-B16 模型,结合五层 DFlash 主干和学习的 bigram 选择器,为 Ling3-Flash 提出多个候选延续用于目标模型验证,参数量 482M,在 MMLU 等基准上实现 3x+ 的 E2E 速度提升,目前 UBTree 适配尚未开源,SGLang 集成支持预计即将推出。
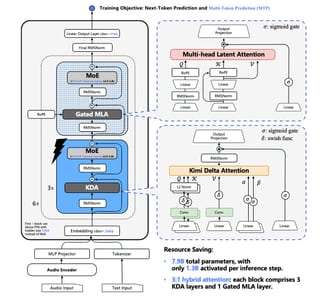
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI/Ming-3.0-asr-tiny 结合 Ling-tiny-v3 语言主干和音频编码器,支持单轮中英语音转写及15种方言识别,通过热词或对话上下文提升专业术语识别率,模型参数量未提及,在嘈杂语音和5个应用领域完成评测,提供PyTorch/Transformers推理示例及MIT授权。
Google DeepMindGoogle DeepMind 与新加坡政府技术局(GovTech Singapore)合作,微调了隐私保护型设备端诈骗检测模型 Gemma,用于应对新加坡超过一半的犯罪(超 40 亿新元损失),该模型通过在设备上分析对话模式实时发出警告,且因运行在设备端,用户隐私不受侵犯。
LangChain Deep Agents releases3535LangChain Deep Agents 0.7.25 发布,支持从模型配置读取内联技能工具,修复文件系统权限规则和中断批准检查问题,提升沙盒搜索性能。
 Apple Machine Learning Research2727
Whisper-small 在 CS-FLEURS 基准测试中实现 14 种语言对的平均 F1 分数 0.798,优于 CNN 的 0.776 和 HuBERT 线性基线的 0.751。该方法通过识别预训练语音编码器中的语言选择性隐藏状态维度,直接从语音中检测语言转换,仅需少量代码转换数据集即可微调决策规则。