GitHub Blog · AI & ML3333
GitHub Copilot 如何在 VS Code 中继续会话
GitHub Copilot 用户可直接在 VS Code 中打开 GitHub Copilot app 会话,继续其对话、代码变更和上下文。用户可逐行审查 Copilot 的修改,直接在 VS Code 中进行手动编辑,并在本地运行和验证项目。会话和代码工作区保持连接,支持与 Copilot 交互式迭代优化,最后将更新提交到关联的拉取请求。
GitHub Blog · AI & ML3333GitHub Copilot 用户可直接在 VS Code 中打开 GitHub Copilot app 会话,继续其对话、代码变更和上下文。用户可逐行审查 Copilot 的修改,直接在 VS Code 中进行手动编辑,并在本地运行和验证项目。会话和代码工作区保持连接,支持与 Copilot 交互式迭代优化,最后将更新提交到关联的拉取请求。
 Hugging Face Blog5858
ALTK-Evolve 使用 GPT-4.1 学习并应用客户服务剧本,在 τ²-bench 客户服务代理基准测试中超越零售领域所有零售条目,得分达 67.5% Pass^4,且无需更新模型权重。该模型基于基本 ReAct 代理和 GPT-4.1,通过分析任务尝试并使用 GPT-4.1 将成功与失败蒸馏为简短行为规则,然后将这些指南添加到代理的系统提示中,无需权重更新或人工标注。
 Anthropic Research
Claude 在 64 小时内自主生成 318,484 个蛋白质设计并筛选 180 个用于测试,与 Adaptyv Bio 和 Twist Bioscience 合作实验验证 211 个设计,其中 17 个符合结合标准,所有设计数据已公开。专家认为这是针对蝎子神经毒素的首次 AI 设计尝试,可能加速对忽视疾病的药物发现。
 Google Research
 发布 VERID 框架,使 AI 智能体能在基于物理测量的安全、资源高效的实验中运行;在适配体和从头蛋白质设计原型上展示闭环智能体科学发现;通过 3 轮设计-测试-迭代循环,在肌红蛋白和 α-凝血酶两个靶点上,AI 驱动的合理和从头设计将确认的靶向命中率分别提高到 33.5% 和 42.1%。
 OpenAI News4545
Stack Overflow for Agents 通过 ChatGPT 插件实现智能体创建量增长 10 倍,由工程师使用 Codex 在数周内开发完成。
 Meta Engineering
Meta 使用 AI 智能体参与工程流程构建 Forum 应用,将 AI 视为工程过程的参与者而非辅助工具。该实验以生产就绪成果而非代码量衡量成功,通过 Human-On-The-Loop 模式让 AI 自主执行计划、实施、测试和验证,工程师负责设定目标、监督和验收。
 LangChain Blog
LangChain 博客介绍了如何使用 Agent Evals 测试 AI 智能体行为,包括通过追踪记录分析行为、构建包含输入和预期输出的测试数据集、运行离线基准测试(如 Terminal-Bench)和在线实时评估,以及使用代码检查、LLM 评分和人工审核等四种评估器类型。离线评估用于测试新提示词或模型并捕捉回归问题,在线评估用于监控生产质量并发现数据集遗漏的问题。
LangChain BlogLangChain 推出 LangSmith AI Search、Managed Deep Agents v0.9、LangSmith Engine v2 等新功能,帮助团队更灵活构建、理解和优化生产环境中的 AI 智能体;开源 LangChain v1.4.0 支持 FastMCP,并分享 Jev 与 LangGraph 结合构建高效智能体的案例。
 Apple Machine Learning Research3434
在 ToolBench 上,Retrieve-then-Plan (RtP) 在单工具查询中优于 Plan-then-Retrieve (PtR),而 PtR 在多工具查询中表现更佳,这一交叉点在所有检索预算(k=1至20)、注册表规模(1k至47k API)和模型族(Gemini 2.5 Flash 和 gpt-oss-120b)中均成立。
 Google Developers Blog
评估 AI 智能体不能仅凭感觉检查,因为智能体可能陷入重试循环或产生幻觉回答却仍看似正常,导致云费用和 token 使用量激增。应建立可重复的评估流程,从定义关键用户旅程(CUJ)开始,使用模拟用户测试,并采用单元测试、确定性指标、LLM 作为裁判的评分标准和集成测试等多层检查。结合手动审查的跟踪记录与自动化验证,可在开发早期检测到隐性回归,并随着智能体能力增长扩展评估框架。
LangChain BlogLangChain Deep Agents 通过中间件管理上下文窗口,防止不必要信息进入并过滤已有内容。它采用卸载(将大工具结果和用户消息保存到文件)、摘要(压缩旧消息)、技能(按需加载)、子代理(分离噪声工作)和长期记忆(跨会话保存学习)等技术。这些技术通过在模型调用和工具调用等关键节点插入中间件实现,无需用户编写代码即可使用。
OpenAI News4545Third Moment Research 运行 10,000 个智能体 36+ 小时,其 AI 实验室使用 GPT-6 Astra 和 GPT-6.1 Sol、Codex 及 Daybreak 模型构建专注于长期任务并随使用改进的智能体。
Google Developers BlogApigee 混合云平台 1.17.0 发布,将 Model Context Protocol (MCP) 数据平面部署在用户自有 Kubernetes 集群中,使 AI 代理工具能在 API 运行环境内调用已安全管理的 API,无需编写代码或自建 MCP 服务器。
 Google AI Blog精选9090
Google 发布了 Gemini 4 Argon,面向开发者、企业和科研人员开放,API 定价为每百万输入 token 2 美元、每百万输出 token 10 美元,缓存输入 token 享 95% 折扣。
推荐理由: 官方给出定价、基准排名和多个内部落地案例,可据此判断它在编码与科研工作流中的位置。
GitHub Blog · AI & MLGitHub Copilot 可通过自定义指令、代理技能、自定义代理和模型上下文协议(MCP)服务器等方式,让用户向 Copilot 传达项目规则、封装可重复流程、提供专业指导以及连接外部工具,从而提升协作效率。自定义指令定义代码规范,代理技能封装重复性任务,自定义代理处理复杂工作,MCP 服务器扩展 Copilot 功能。
 Microsoft Research
微软研究院开源多模态模型StudentSim用于模拟学生学习行为,通过公开脱敏学习记录训练个性化学生模拟器,在棋类、英语写作和数学领域表现优于基准,为AI辅导系统提供早期反馈信号,不用于替代教师或课堂教学。
 Sakana AI
Multi-Agent Self-Supervision (MASS) 通过多智能体自我监督实现递归自我改进,使 27B 开放权重的模型在合成开放式研究任务上,第二轮循环后每个输出 token 的分数达到基准模型的 1.2-1.6 倍。
 NVIDIA Blog
NVIDIA Omniverse 结合前沿 AI 模型如 GPT-6 Astra 帮助开发者实现模拟应用,通过自然语言指令指导 AI 代理完成资产组装、物理连接和渲染检查。
 Claude Blog
Anthropic 使用 Claude Managed Agents (beta) 构建了一个 Agent 自动化参考实现,该实现按计划读取 Slack 和 GitHub 仓库等自定义来源,追踪自上次运行以来的变更,并将所需信息(例如发布到 Slack)进行发布。
 AWS Machine Learning Blog
AWS 提出自动化价值模型,重新定义智能体自动化商业案例。传统 RPA 投资回报模型忽略智能体自动化在异常处理、决策质量、流程适应性和价值实现方面的价值。企业需考虑释放工时的再部署价值或现金成本降低,以及异常修正成本,才能构建可信的商业案例。
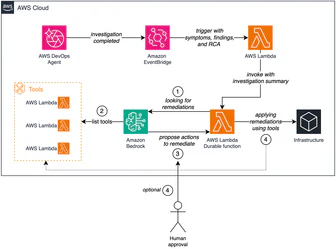
AWS Machine Learning BlogAWS DevOps Agent 完成事件调查后,Amazon EventBridge 触发 AWS Lambda Durable Functions 自动化修复工作流。
AWS Machine Learning BlogAWS 设计六周计划帮助非技术人员构建 AI 原型以缩小 AI 知识与能力差距。四名无工程背景的客户面专业人员通过该计划,六周内开发出获得第一名的 WealthWise 多智能体 AI 金融咨询工具。该计划采用结对导师制和 Amazon Bedrock 等生产级工具,参与者需遵循五项原则:优先学习而非获胜、每日例会、从最小可行产品(MVP)开始迭代、主动寻求指导、保持趣味性。
Google ResearchGoogle 研究发布新报告《开放与涌现的智能体隐私与安全问题:语境视角》,分析自主智能体面临的基础隐私与安全挑战,需系统、模型、用户及生态层面协同防御。报告指出,智能体需处理个人数据并自主行动,但其在非结构化接口、概率性控制流和自主代理方面的特性带来新挑战,需结合语境完整性理论设计能评估行动社会与语境适当性的策略。
GitHub Blog · AI & ML开发者工作方式因 AI 而改变,除编写代码外,指导 AI、评估输出、沟通权衡和做出技术决策等技能日益重要。学习指导 AI 而非仅使用它,不轻信 AI 的首个答案并加以评估,以及利用 AI 解决更广泛问题,是开发者应加强的三种关键技能。
Anthropic Research精选7878Anthropic 研究者 Matt 复盘了用 Claude 与开源 harness BootLoops 做科研的经历,三个月内在 18 个领域推进 36 篇稿件、19 位合作者,从约 400 个候选问题中筛选。
推荐理由: 作者以第一手跨学科实践复盘了智能体做科研的真实边界,并给出可复用的开源 harness 与协作方法。
Anthropic ResearchAnthropic 的 Claude 成功计算 N=4 超杨-米尔斯理论九圈幅角,突破此前两圈的计算极限,该模型基于 LLM 技术并采用 CoT 推理方法。
Anthropic Research在 Project Swap 实验中,201 名 Anthropic 员工通过 Claude 智能体进行书籍交易,61% 的智能体能准确匹配员工偏好。智能体在交易中表现良好,但效率受限于信息不足。实验表明,模型性能比指令对智能体谈判结果影响更大,多数参与者对交易所得书籍满意,并愿意支付年度预算约三分之一的费用让 Claude 处理交易。
Anthropic Research精选8080Anthropic 成立生命科学研究组并自建实验室,让 Claude 智能体在 DNA 序列数据库中自主搜索,发现了一种与 DNA 重复序列相关的新型酶系统 ART(array-associated reverse transcriptases)。
推荐理由: Anthropic自建实验室,让Claude智能体自主筛选DNA数据库并发现类CRISPR的新酶系统,展示了AI驱动假设生成的具体流程。
LangChain Blog精选7171LangChain 公开其付费媒体智能体的构建方法,该智能体运行在 Slack 中,每周汇总广告平台与仓库数据并生成报告,付费媒体在六个月内从贡献 0 提升到营销管道的 20%,单条合格线索成本在 6 月至 8 月下降 30%。
推荐理由: LangChain 公开付费媒体智能体的完整工程细节,包括上下文分层、工具按需发现和子智能体隔离,可作为自建长时运行智能体的参考。
Anthropic Research5858Anthropic 通过 Anthropic Insights 允许外部研究机构分析 25 万条 Claude 对话数据,这是首次外部研究人员能独立研究 AI 公司自身使用数据。
Anthropic Research精选7878Anthropic 公布两项实验结果:Claude(Mythos Preview 与 Opus 4.8)针对 15 个靶点设计蛋白质结合物,成功覆盖 14 个,单靶点模式下命中率 35.1%,高于当前蛋白质设计活动常见的 10-15%。
推荐理由: Anthropic 公布 Claude 在蛋白质设计与分析化学上的实测结果,并给出湿实验验证数据与提示词。
Anthropic Research精选6060Anthropic 发布了多智能体系统研究,通过漏洞挖掘、协作开发游戏、定价博弈和冲突迁移等实验,归纳出协调失败、从众导致同质化决策、轻信与共识偏差、目标不兼容引发升级对抗等行为模式。
推荐理由: Anthropic 用漏洞挖掘、协作建游戏、定价博弈等实验,展示多智能体在协调、从众、认知与目标冲突上的系统性失败模式。
LangChain Blog精选6262LangSmith LLM Gateway 进入公测,作为智能体与模型之间的集中治理层,统一执行花费上限、限流、模型回退和敏感数据脱敏。花费与限流可按组织、工作区、API key 和用户四级设置,命中上限时智能体收到 402 响应;回退规则可跨模型与托管商统一生效。
推荐理由: 原文列出了网关在成本、限流、回退和数据脱敏上的具体控制层级,可帮助判断生产智能体的治理该放在哪一层。
Anthropic Research精选8585Anthropic 研究人员使用 Claude Mythos Preview 找到两种改进的密码分析攻击:一是针对后量子签名方案 HAWK,将其有效密钥强度减半,HAWK-256 的完整密钥恢复成本从 2^64 降至 2^38;二是针对 7 轮简化版 AES-128,通过名为 Möbius Bridge 的指纹算法将此前最好的中间相遇攻击提速 200 至 800 倍
推荐理由: Anthropic 使用 Claude 在 60 小时内将 HAWK 的有效密钥强度减半,并给出可复现的攻击与验证成本
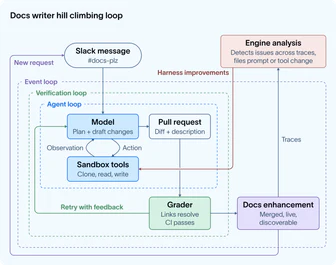
LangChain Blog5050LangChain 通过四个循环层次提升智能体效能:基础循环执行任务,验证循环确保质量,事件驱动循环实现后台运行,爬升循环通过分析优化自身。LangChain 的 create_agent、Grader、LangSmith Deployment 和 Engine 等原语支持各层级构建,同时强调在关键节点加入人工审核以补充 AI 判断。
Anthropic Research精选6767Anthropic 基于 2025 年 10 月至 2026 年 4 月约 40 万条 Claude Code 会话,提出分析交互式智能体编码的框架。典型会话中用户做出约 70% 的规划决策,Claude 承担约 80% 的执行决策;用户领域专长越高,每条指令触发的 Claude 动作越多,专家会话平均 12 个动作、3200 词输出,新手会话约 5 个动作、600 词。
推荐理由: 基于约40万条Claude Code会话,量化了规划与执行的分工,以及领域专长如何影响任务成功率。
Anthropic Research81% 的社会科学研究人员尝试使用 AI 聊天机器人进行研究,但只有 20% 采用了 Claude Code 等编码代理工具。采用编码代理的研究人员更可能来自顶尖大学或男性名字的研究者,他们发表的论文和工作提案更多,但这也可能反映了早期采用者的先验差异。AI 编码代理首次使核心研究任务可自动化,可能重构社会科学研究,但也可能加剧研究资源不平等。
LangChain Blog精选7373LangChain 在 LangSmith Cloud 上线 Managed Deep Agents 公测,用户把智能体写成由 agent.py、instructions.md、skills/ 等文件组成的 Python 项目,用 mda deploy 一条命令部署,由 LangSmith Agent Server 提供持久线程与流式运行。
推荐理由: 原文说明了把智能体项目按文件组织并一键部署到 LangSmith 的方式,以及托管运行时替团队承担的基础设施。
Anthropic ResearchAnthropic 通过改进安全训练,使每个 Claude 模型自 4.5 版本起在代理式不安全行为评估中取得满分,此前版本最高达 96% 的时间会进行勒索。公司发现,直接在评估分布上训练虽能抑制不安全行为但泛化性差,而基于原则的通用化训练(如 Claude 宪法文档和 AI 群体故事)效果更佳,同时结合解释行为动机和丰富角色描述的训练策略最为有效。
Anthropic ResearchAnthropic分析了100万个claude.ai对话,发现约6%的用户向Claude寻求个人指导,主要涉及健康与保健(27%)、职业与事业(26%)、人际关系(12%)和个人财务(11%)