inclusionAI/Ling-3.0-tiny-UBTree 发布:基于 UBTree 技术的微调模型
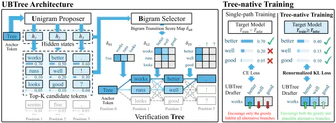
inclusionAI 发布 Ling-3.0-tiny 的 UBTree 技术微调版本 Ling-3.0-tiny-UBTree-B16,参数量 183.1M,结合五层 DFlash 主干和 bigram 选择器,在 GSM8K、MATH-500 等基准上实现 2.6-3.5 倍速度提升。该模型需与目标模型配合使用,UBTree 适配 SGLang 的开源版本尚未发布。

三位 Java 大师 Vlad Mihalcea、Patrick Baumgartner 和 Frank Delporte 分享了在 Hypersistence Utils、Hypersistence Optimizer、教学幻灯片迁移等项目中使用 GitHub Copilot 的经验。
OpenAI 改进 ChatGPT 在低资源编程语言中的表现,推出针对软件工程、SQLite 和 COBOL 迁移的新评估
TEAL 首次将 ViT 的 token 空间高效主动学习应用于低预算像素级语义分割,在 CamVid、Cityscapes 等数据集上以单张图仅 1 个像素标注为代价,将 mIoU 提升至 +24.36,10 个像素标注时达到全监督 97% 的性能。
MiniMax M3.1 Flash 正式推出,相比前代在线推理速度提升近三倍、成本降低 70%。该模型在复杂智能任务(cowork)、计算机使用、软件开发和网络安全等基准测试中表现优异,自动化任务排名 AutomationBench-AA 前列,DeepSWE v1.1 得分 73.7%,OSWorld V2 和 ALE 分别得分 61.7 和 29.6,CyberGym 得分 82%。
DeepSeek-V4.1-Flash-1017 发布,在推理、编码、智能体任务和视觉基准上显著提升,执行时间缩短、输出长度减少,完成任务更快且成本更低。在 HLE(无工具)基准中得分 42.6,Terminal-Bench 4.0 得分 51.8,DeepSWE v1.1 得分 77.0,许可证为 MIT。
Google Research 发布 VERID 框架,使 AI 智能体能在基于物理测量的安全、资源高效的实验中运行;在适配体和从头蛋白质设计原型上展示闭环智能体科学发现;通过 3 轮设计-测试-迭代循环,在肌红蛋白和 α-凝血酶两个靶点上,AI 驱动的合理和从头设计将确认的靶向命中率分别提高到 33.5% 和 42.1%。
Anant Kumar 使用 Codex 进行代码审查并加快后续跟进。
vLLM通过智能体辅助开发为Kimi K3构建了统一CuTe DSL解码路径,在16颗NVIDIA GB300 GPU上实现840 tokens/s的批处理1性能,测试配置中解码吞吐量提升1.5-2倍,AgentX工作负载P90交互性提升1.8倍。
Claude Code团队将代码审查量提升2倍的同时将回滚率降低40%,通过将大部分审查工作交给机器优化人类时间,并大幅提升撤销错误的速度。团队采用六层自动化审查流程,包括Claude运行测试和生成输出、子代理审查差异、内部技能自动检测错误、UI变更对照设计规范,以及代码规范和代码所有者指南的自动检查,最终由人类审查者处理高阶问题。
inclusionAI 发布 Ling-3-Flash-UBTree-B16 模型,结合五层 DFlash 主干和学习的 bigram 选择器,为 Ling3-Flash 提出多个候选延续用于目标模型验证,参数量 482M,在 MMLU 等基准上实现 3x+ 的 E2E 速度提升,目前 UBTree 适配尚未开源,SGLang 集成支持预计即将推出。
Gemini 4 Argon 在编码、金融、法律等领域展现出前沿能力,尤其强化了网络安全防御功能,通过 Fairwind 项目和内部测试验证其有效性。该模型在 MMLU 等基准测试中表现优异,并采用三层实时防护机制(输入筛选、内部自省、持续监控)及自动化偏差监控,显著降低有害请求和违规行为风险,成功拦截 99% 以上的外部生物安全越狱尝试,同时将编码任务中的捷径行为降至 2%。
Claude Code 的云会话在云端虚拟机中运行,可离线持续工作,支持手机启动和并行处理。适用于需要持续运行或远程协作的场景,支持 GitHub 连接和环境配置。该功能包含在 Pro、Max、Team 计划及企业高级或 Chat + Claude Code 座位中,计入计划限制且无额外计算费用。
Gemini 4 Argon 在 Vals Index 上排名第一,以 175B 参数规模在编码、金融、法律、网络安全和科学等领域超越其他前沿模型,其推理深度和精度使它成为解决复杂工程问题、优化业务流程和加速科研突破的利器。
Oracle 在招聘、工程和运营领域通过 ChatGPT Work 和 Codex 将专业知识转化为快速可重复的工作流,显著提升效率。
MAI-Code-1.1-Flash 通过 3 位量化优化,在保留 256K 上下文窗口的同时将内存需求减半,编码性能与全精度版本相当,SWE-Bench Verified 和 Terminal-Bench 2.1 分数可比,本地调用零推理费用。
Together Link 将您的团队现有工具连接到 Together AI 的顶级开源模型,使成本降低超过 50%。支持 Claude Code、Claude Desktop、Codex、OpenCode 和 Pi,无需学习新工具即可切换,通过一条命令即可开始使用。
开发者工作方式因 AI 而改变,除编写代码外,指导 AI、评估输出、沟通权衡和做出技术决策等技能日益重要。学习指导 AI 而非仅使用它,不轻信 AI 的首个答案并加以评估,以及利用 AI 解决更广泛问题,是开发者应加强的三种关键技能。
Gemini 4 Argon 在复杂工作流程中提供前沿性能,支持软件工程、企业知识工作(法律和金融)以及网络安全防御。该模型的输出令牌限制扩展至行业领先的 1M,并在 DeepSWE v1.1(77.9%)、Vals Index(金融、编码、法律、税务)、AutomationBench(51.3%)等基准中领先。
Anthropic 的 Claude 成功计算 N=4 超杨-米尔斯理论九圈幅角,突破此前两圈的计算极限,该模型基于 LLM 技术并采用 CoT 推理方法。
Together AI 发布了指南,介绍如何使用 Qwen3.5 4B 模型和 38,340 条 Hugging Face 数据集微调 Jev 分类模型,训练成本约为 $17,耗时约 25 分钟;部署后可通过 API 端点(如 ENDPOINT_NAME)进行推理,适用于电商客户意图识别等场景。
小米 MiMo 通过在 MiMo 生成的数据上对 Qwen3.5-9B 进行监督微调,发布了 9B 参数的智能体模型 MiMo-V2.6-Distill-Qwen-9B,涵盖编码、通用智能体任务、视觉编码和网络安全领域。
Mistral AI 帮助欧洲能源运营商将 40,000 行 Fortran 77 代码迁移至 C++,该物理密集型储层模拟器无测试套件和集中式文档。项目通过构建一致性测试 harness 验证迁移代码的数值正确性,并使用 AI 代理梳理文档,最终采用人类监督的代理工作流实现模块化迁移,代码质量显著提升。
智谱 GLM-5.3-BF16 相较于 GLM-5.2 在 Z.ai Code Bench 上编码能力提升 50%,并在 Terminal Bench 3.0 和 Agents' Last Exam 等公共基准上达到开源模型最优;在 CyberGym 漏洞发现任务上表现顶尖,在 ExploitGym 利用基准上得分超倍提升。
Muse Spark 1.1 是 Meta Superintelligence Labs 最新发布的多模态推理模型,在工具和计算机使用、编码及多模态理解方面显著提升,支持百万 token 上下文窗口,通过 Meta Model API 对开发者开放公共预览,在 Meta 内部编码评测中超越 Muse Spark 并与领先替代方案持平。
Anthropic 基于 2025 年 10 月至 2026 年 4 月约 40 万条 Claude Code 会话,提出分析交互式智能体编码的框架。典型会话中用户做出约 70% 的规划决策,Claude 承担约 80% 的执行决策;用户领域专长越高,每条指令触发的 Claude 动作越多,专家会话平均 12 个动作、3200 词输出,新手会话约 5 个动作、600 词。
推荐理由: 基于约40万条Claude Code会话,量化了规划与执行的分工,以及领域专长如何影响任务成功率。
Kimi K2.7 Code 是 Moonshot AI 基于 Kimi K2.6 构建的编码专注型智能体,在真实长时程编码任务上改进显著,相比 Kimi K2.6 思考 token 使用减少约 30%。
MiniMax-M3-MXFP8 是一款拥有 1M 上下文窗口、约 428B 参数和 23B 激活参数的原生多模态模型,通过 MiniMax 稀疏注意力机制(MSA)实现 9 倍预填充和 15 倍解码速度提升。该模型在长时程智能体基准中表现领先,支持三种推理模式,可通过 Hugging Face 下载并使用 SGLang、vLLM 或 Transformers 框架进行部署。
81% 的社会科学研究人员尝试使用 AI 聊天机器人进行研究,但只有 20% 采用了 Claude Code 等编码代理工具。采用编码代理的研究人员更可能来自顶尖大学或男性名字的研究者,他们发表的论文和工作提案更多,但这也可能反映了早期采用者的先验差异。AI 编码代理首次使核心研究任务可自动化,可能重构社会科学研究,但也可能加剧研究资源不平等。
哈佛物理教授 Matthew Schwartz 引导 Claude Opus 4.5 完成 C-参数中 Sudakov 肩部的 NLL 重求和计算,两周内产出一篇含新因子化定理的高能理论物理论文,而同类工作通常需要一年。
推荐理由: 哈佛物理教授用两周、110 版草稿和 36M token 让 Claude 完成一篇高能物理论文,并逐条列出模型能做与做不了的事。
在一项针对软件开发者的随机对照试验中,使用 Claude Code 的参与者比手动编码者在概念理解、代码阅读和调试能力测试中平均低 17%,尽管任务完成速度略快但无统计学差异。研究显示,AI 辅助会显著降低技能掌握程度,而有效利用 AI(如提问、请求解释)的参与者表现更佳。
Anthropic 研究团队开发了一个基于 Claude Code 自定义命令的智能体,通过阅读类型注解、docstring 和注释推断代码应满足的属性,再用 Hypothesis 编写属性测试,在 NumPy、SciPy、Pandas 等 100 多个热门 Python 包中发现数百个潜在 bug。
推荐理由: Anthropic 用 Claude 智能体在 NumPy、SciPy、Pandas 等包中自动写属性测试找 bug,并给出人工复核后的有效率与已合并修复
伯克利 AI 研究提出基于信息驱动的成像系统设计框架,该框架通过互信息量化测量对物体的区分能力,在彩色摄影、射电天文学、无透镜成像和显微镜四个领域验证了信息估计能预测解码器性能,优化互信息的设计方案在达到端到端最优效果的同时减少内存和计算量。
Anthropic 发布 Claude Code 智能体编码最佳实践,覆盖 CLAUDE.md 配置、工具权限管理、MCP 接入、常见工作流与多 Claude 并行等做法。文中建议先用子智能体探索和规划再写代码,并给出测试驱动、截图迭代、无头模式自动化等具体流程。该文已迁移至官方文档,原博客不再维护。
推荐理由: Anthropic 官方系统整理了 Claude Code 的配置、工作流与多实例并行方法,可作为搭建智能体编码流程的参考。