Microsoft Research
RetroChimera 发布:Nature 期刊报道的分子逆合成预测新框架
RetroChimera 在 Nature 上发布,结合 R-SMILES 2 和 NeuralLoc 模型进行逆合成预测。该框架通过学习型集成策略排名,在盲测中优于现有模型,专家更认可其复杂分子拆解建议。模型开源,旨在加速新医药分子和先进材料开发。
Microsoft ResearchRetroChimera 在 Nature 上发布,结合 R-SMILES 2 和 NeuralLoc 模型进行逆合成预测。该框架通过学习型集成策略排名,在盲测中优于现有模型,专家更认可其复杂分子拆解建议。模型开源,旨在加速新医药分子和先进材料开发。
 Qwen · Hugging Face 新模型
Qwen/Qwen-Image-2.1-PE-I2I 发布,一个 7B 参数的统一文本到图像生成与编辑模型,包含 32 层单流 DiT 架构,支持生成常规或透明图像、编辑透明图层、提取照片主体,并具有 10 张参考图像编辑能力。
Qwen · Hugging Face 新模型Qwen/Qwen-Image-2.1-PE-T2I发布,一款7B参数的统一文本到图像生成与编辑模型,包含32层单流DiT架构,支持生成常规或透明图像、编辑透明图层、提取照片主体,并可通过圆形、涂鸦标注或独立掩码进行局部编辑。其文本到图像提示词重写模型Qwen3.5-VL 9B可将多语言请求转化为详细英文提示词并推荐宽高比。
 Mistral AI
Mistral 模型已为 Mozilla 的 AI 浏览助手 Firefox Smart Window (beta) 提供动力,帮助用户处理复杂搜索、记忆重要信息和基于浏览器标签页获取信息,目前服务于法国和北美用户,英国和德国预计今年晚些时候加入。
 Google · Hugging Face 新模型
谷歌发布了EmbeddingGemma 2,一个包含740M参数的多模态嵌入模型,支持文本、图像、视频和音频的统一768维向量表示。该模型可在消费级硬件上运行,提供低延迟的语义表示,适用于搜索、检索增强生成等应用。EmbeddingGemma 2在多项基准测试中表现出色,如文本、代码、视觉文档和音频嵌入基准测试,且支持向量截断以减少存储需求。
 LangChain Blog精选7171
LangChain 公开其付费媒体智能体的构建方法,该智能体运行在 Slack 中,每周汇总广告平台与仓库数据并生成报告,付费媒体在六个月内从贡献 0 提升到营销管道的 20%,单条合格线索成本在 6 月至 8 月下降 30%。
推荐理由: LangChain 公开付费媒体智能体的完整工程细节,包括上下文分层、工具按需发现和子智能体隔离,可作为自建长时运行智能体的参考。
Mistral AICloudera 与 Mistral 合作,将 Mistral 模型集成 Cloudera 混合数据平台,使企业可在私有云、公有云、本地及完全隔离环境中部署 AI 模型并保持完全控制权;Mistral 允许企业在受控环境中使用专有数据训练 AI 模型,将数十年机构数据转化为定制 AI 模型,同时保留数据和智能的所有权。
 DeepSeek · Hugging Face 新模型
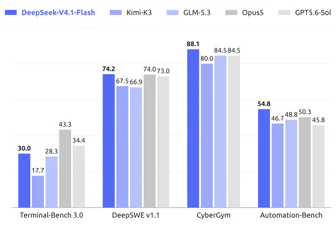
DeepSeek-V4.1-Flash 是一个 552B 参数的多模态 MoE 模型,支持高达一百万 token 的上下文,原生处理图像和文本并自回归生成文本。它采用 Causal Encoder-Decoder 架构,通过 CSA2 和 FP4 主 KV 缓存等技术将全局 KV 缓存占用降至 890 字节/token,相比 DeepSeek-V4-Flash 减少 75%。
 Google DeepMind
 发布 AlphaGenome Atlas 平台,包含对人类基因组 90 亿个单核苷酸变异的预测结果,为学术研究提供免费网站入口。
 Microsoft AI News
MAI-Image-2.6 成为迄今最强图像模型,在 Arena 排名第二,在 Artificial Analysis 排名第一;MAI-Image-2.6-Flash 生成图像速度比 GPT-Image-2-Medium 快 2.8 倍,效率提升 72%。两者均支持多图像参考编辑、网络接地和动态宽高比,MAI-Image-2.6 以最佳每 Elo 性价比表现帮助生产团队控制成本。
LangChain BlogLangChain 将 MCP 支持移入主包并升级到 FastMCP 协议,实现无状态交互、工具列表缓存和中断式提取功能。新协议通过 LangGraph 支持 98 倍增长的 ChatGPT 工具调用,客户端可缓存工具目录并处理模型请求参数。MCPAdapter 支持多服务器连接和 OAuth 2.1 认证,服务器可独立配置认证和传输层。
Google · Hugging Face 新模型Google 发布 GNM-v3 3D 人体头模型,提供精细控制面部身份、表情和姿态的参数化模型,包含可控内部解剖结构。模型支持 NumPy、JAX、PyTorch 和 TensorFlow,采用 Apache 2.0 许可证。
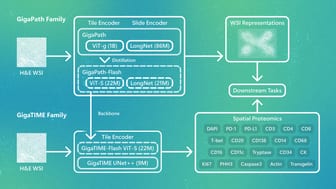
Microsoft ResearchGigaPath-Flash 和 GigaTIME-Flash 通过精简的 ViT-S 编码器显著降低了计算需求,在保留性能的同时使大规模病理学研究更易实现。
DeepSeek · Hugging Face 新模型DeepSeek-V4-Flash-Vision-Exp 发布,DeepSeek-V4 家族首个实验性多模态模型,在 DeepSeek-V4-Flash 架构基础上集成视觉模块并持续训练以解锁视觉理解能力。
 Anthropic Research5858
Anthropic 通过 Anthropic Insights 允许外部研究机构分析 25 万条 Claude 对话数据,这是首次外部研究人员能独立研究 AI 公司自身使用数据。
 智谱 Z.ai · Hugging Face 新模型
智谱推出 GLM-5.3-Flash,首个原生多模态 GLM-5 系列,320B 总参数仅 18B 活性参数,基准测试与实际任务表现优于 GLM-5.2,价格仅为其十分之一,编码与智能体测试接近 Claude Opus 4.8
智谱 Z.ai · Hugging Face 新模型智谱发布 GLM-5.3-Flash,首个原生多模态 GLM-5 系列模型,拥有 320B 总参数和 18B 活性参数,在基准测试和实际工作负载中超越 GLM-5.2,价格仅为其十分之一,编码和智能体基准测试接近 Claude Opus 4.8。
Google · Hugging Face 新模型Google 发布预训练时间序列基础模型 TimesFM 3.0,采用 Stacked Mixing Transformer 架构,上下文长度 32+64,20 层 Transformer,参数量 1280,支持量化中位数预测,使用 GiftEvalPretrain 预训练,遵循 TimesFM Non-Commercial License v1.0。
 Thinking Machines
 发布开源语言模型 Inkling 和 Inkling-Small,允许用户拥有、运行和定制。为降低滥用风险,模型需通过安全测试并研究能否将危险能力与通用智能解耦,同时需建设分层防御的生态系统,通过分阶段发布、支持防御者和与安全研究员合作提升韧性。内部评估和外部测试显示,发布 Inkling 不会带来现有开源模型已存在的重大增量风险。
Microsoft AI NewsMAI-Cyber-1-Flash 模型在 CyberGym 评测中实现 96% 评分,成本仅为当前 MDASH 最佳方案的 50%,专为 MDASH 执行器优化。
 Berkeley AI Research
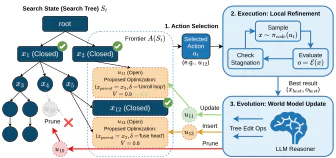
K-Search 通过 CUDA-to-MLX 结构化转换层,将 CUDA 核心知识迁移至 Apple Silicon MLX 平台,在 Attention 核心上实现与原生 MLX 0.97x 性能提升,Mamba SSM 核心上较社区实现 20x 预填速度提升。
 Meta AI Blog
Meta AI 的 DINOv3 和 SAM 模型在边缘计算中实现实时感知,支持匹兹堡大学 RAMMP 项目开发辅助机器人,通过自然语言与图像数据交互,降低用户认知负荷,已在原型中集成自动门按钮检测、杯子识别及导航辅助功能,并计划增加语音和触控输入支持。
Microsoft AI NewsHill-climbing MAI 模型在 GitHub Copilot 中使用 10% 更少的 token,代码接受率比 GPT 5.4 Mini 高 10%,比 Claude Haiku 4.5 高 11%,用户留存率分别高 6% 和 11%。
Meta AI BlogMeta AI 发布的 SAM 3 和 DINOv3 开源模型,通过 300 A100 GPU 在 NERSC 超级计算机上实现科学图像 15 分钟内完成 3D 语义分割与重建,助力美国能源部 Genesis 任务项目解决 ALS 升级后数据爆炸带来的分析瓶颈,已在葡萄藤干旱细胞级研究中实现月度专家标注效率提升 20 倍。
Anthropic ResearchAnthropic 研究如何通过轴模型分析 Claude 大语言模型在不同语言中的价值观变化。Four key axes capture 15% of the variation in Claude's values。
Meta AI BlogMuse Spark 1.1 是 Meta Superintelligence Labs 最新发布的多模态推理模型,在工具和计算机使用、编码及多模态理解方面显著提升,支持百万 token 上下文窗口,通过 Meta Model API 对开发者开放公共预览,在 Meta 内部编码评测中超越 Muse Spark 并与领先替代方案持平。
 ByteDance Seed · Hugging Face 新模型2727
字节跳动种子发布3款PAR模型:3scale_400M、3scale_400M_pdb和3scale_by_ratio_60M,分别用于基准测试、PDB数据集微调和零样本动机构建。
Meta AI BlogMeta AI 发布 Brain2Qwerty v2,非侵入式脑机接口实时解码句子,词准确率达 61%;v1 训练代码及数据集开源,v1 数据集由合作方 BCBL 发布。
 Moonshot AI · Hugging Face 新模型
Kimi K3 是 Moonshot AI 发布的 2.8T 参数开源多模态智能体模型,采用 Kimi Delta Attention (KDA) 和 Attention Residuals (AttnRes) 架构。
Microsoft AI NewsMicrosoft MAI 在 Build 2026 大会发布七款新模型,包括 MAI-Image-2.5 及其 Flash 变体(图像编辑基准排名第二)、MAI-Transcribe-1.5(全球最佳转录模型)。
Microsoft AI News微软发布七款新 MAI 大模型,可在 Foundry 平台使用并针对自家产品优化,同时通过 OpenRouter、Fireworks 和 Baseten 向开发者开放,首次支持开发者自行微调模型权重。
 MiniMax · Hugging Face 新模型
MiniMax-M3-MXFP8 是一款拥有 1M 上下文窗口、约 428B 参数和 23B 激活参数的原生多模态模型,通过 MiniMax 稀疏注意力机制(MSA)实现 9 倍预填充和 15 倍解码速度提升。该模型在长时程智能体基准中表现领先,支持三种推理模式,可通过 Hugging Face 下载并使用 SGLang、vLLM 或 Transformers 框架进行部署。
ByteDance Seed · Hugging Face 新模型2525ByteDance Seed/TaskMem 模型发布,参数规模 31B,使用 BF16 张量类型,但未部署任何推理提供商。
ByteDance Seed · Hugging Face 新模型2828ByteDance Seed/SimArt 模型预训练权重发布,包含用于生成关节式 3D 对象结构(URDF 文件)的多模态大语言模型(MLLM)权重,以及用于编码解码 3D 零件几何形状到离散潜在空间的稀疏 VQ-VAE 模型权重。
LangChain BlogDeep Agents Deploy正式发布,作为开源替代Claude Managed Agents的智能体部署方案,支持任意LLM模型,通过`deepagents deploy`命令实现模型无关、生产就绪的部署,用户可自定义AGENTS.md指令集和Agent Skills,并选择sandbox环境,确保内存所有权不受锁闭。
Microsoft AI News微软推出了MAI-Transcribe-1、MAI-Voice-1和MAI-Image-2三款顶级AI模型,MAI-Transcribe-1每小时起价0.36美元。
LangChain BlogStripe、Ramp 和 Coinbase 等公司已独立开发内部编码智能体,它们采用隔离云沙盒、精选工具集、Slack 首次调用、丰富启动上下文和子智能体编排等相似架构模式。
LangChain BlogLangChain 将其编码 Agent 在 Terminal Bench 2.0 上的表现从 52.8% 提升至 66.5%,排名从 Top 30 升至 Top 5,仅通过改进 harness 工程实现。
LangChain BlogLangChain Deep Agents SDK 通过三种压缩技术管理 AI 代理的有限内存:将大型工具结果(>20,000 tokens)和输入(>85% 上下文窗口)卸载到文件系统,以及使用 LLM 生成会话摘要。该 SDK 在 Claude Sonnet 4.5 上终端基准测试中触发压缩,通过文件系统搜索和摘要保留完整记录,支持频繁触发压缩以优化性能。
Anthropic Research5050科学家通过 Claude 4.5 在生物图解、计算生物学和蛋白质理解基准测试中取得显著进步,该模型已通过 API 供全球顶尖研究人员免费使用,并构建出超越文献综述或编码辅助的定制系统。在实验室中,Claude 作为协作伙伴贯穿研究全过程,通过多种工具将通常耗时数月的项目压缩至数小时,并发现人类可能忽略的大数据集模式,消除知识密集型任务瓶颈,甚至启用传统方法无法采用的全新研究途径。