Hugging Face Daily Papers6565
Ropedia Xperience 2:一个用于扩展物理 AI 环境和行为的黄金标准
Ropedia Xperience 2 包含 1,589 个已发布的度量级 3D 扫描和 4,230 个 74 任务的视点中心记录(131 小时),每个捕获可被重新用于机器人学习,场景转化为物理交互模拟环境,人体运动重定向为全身机器人轨迹,通过虚拟远程操作和自动长时程轨迹生成获取额外机器人行为,该联合捕获被提议为物理 AI 数据收集的黄金标准。
Hugging Face Daily Papers6565Ropedia Xperience 2 包含 1,589 个已发布的度量级 3D 扫描和 4,230 个 74 任务的视点中心记录(131 小时),每个捕获可被重新用于机器人学习,场景转化为物理交互模拟环境,人体运动重定向为全身机器人轨迹,通过虚拟远程操作和自动长时程轨迹生成获取额外机器人行为,该联合捕获被提议为物理 AI 数据收集的黄金标准。
Hugging Face Daily Papers6565PhysLoop 利用大语言模型指导视频生成、选择和修正,实现物理一致的自我改进和可控数据构建。该框架通过识别和纠正生成视频中的物理错误,推动视频生成模型有限人工干预下的递归自我改进(RSI),并发布包含 100K 视频的多样性数据集及生成工具。
Hugging Face Daily PapersDuo v1 引入互惠世界模型(RWM),通过自回归推理、同步注意力和双重推演蒸馏联合建模意图与现实,实现实时全双工音视频交互。该模型持续感知音视频输入的同时实时响应用户,将智能与物理现实视为同等基础构成世界,支持对话、共享对象、重塑虚拟场景等交互,首批模型已开源。
 OpenRouter Blog
当 RAG 应用在文档中存在正确信息却给出错误答案时,通常是因为检索环节出错。向量搜索虽能找到相关主题的片段,但常因近似匹配而失效,例如在询问 Growth 计划时错误地调用了 Enterprise 计划的桶限制。
Hugging Face Daily Papers通过强化学习(RL)和细粒度奖励,研究人员开发了一种名为BookNavigator的界面,帮助大型语言模型(LLMs)从长篇参考材料中自主检索、学习和应用知识,以解决数学问题。
 Berkeley AI Research2222
BAIR团队在2026年11月9日至12日于德克萨斯州奥斯汀举行的机器人学习会议(CoRL)上展示多项研究成果,包括33篇主会论文、4个突破性海报、10场口头报告和7场专题演讲,其中教授Negar Mehr将发表早期职业主题演讲。会议涵盖机器人视觉语言行动模型、具身智能体、细粒度操作对齐、后见之明奖励编辑等议题。
Hugging Face Daily Papers6565LongBanana是首个专家设计和验证的长上下文多参考图像合成基准,包含90个精心设计的任务,每个任务约含32张参考图像、20个约束和50个评估项,共4,670个专家指定的原子评估项。
 Baseten Labs6565
研究表明,策略内自我蒸馏(OPSD)在特定场景下可能仍有价值,但不应投入更多研究资源。OPSD 通过学生模型自身生成的带上下文提示的输出进行训练,但研究表明这种密集的监督可能引入偏差,尤其对训练好的模型效果更差。
 Apple Machine Learning Research
苹果在ICML 2026上提出的摊销最大内积搜索通过训练小神经网络学习支持函数,以固定成本理解典型查询匹配方式,实现推理时更快的精确检索。该方法利用ICNN学习支持函数,KeyNet直接输出最佳匹配键向量,均基于实际查询分布构建的监督数据集进行训练,显著提升RAG场景下的检索效率。
 Microsoft Research
PDD Kit 将用户意图转化为形式化规范,并验证智能体为每个输入编写的代码是否符合该规范,同时辅以测试。团队在 GitHub Next 的 Chopin 环境中使用 PDD Kit 正式验证了 Rust 编写的 Pet Store 登录逻辑,Verus 工具发现并修复了现有 Bug,证明规范下无登录 Bug。
 Epoch AI6565
Epoch Capabilities Index (ECI) 更新采用贝叶斯模型方法论,提供更可靠的模型能力不确定性估计及模型间能力比较概率。新方法基于四参数逻辑斯蒂(4PL)项目反应理论(IRT),使用 Claude 3.5 Sonnet(ECI 130)和 GPT-5(ECI 150)作为锚点模型,通过线性变换固定参数位置和尺度,实现跨时间一致性。
 MIT Technology Review · AI
逆向博弈论通过设计激励智能体遵守规则的系统来控制强大 AI 模型,例如让模型奖励彼此答案的交叉验证或竞争动态,或让模型轮流充当“解决问题者”与“审查者”以模拟人类社会约束机制。Claude 等模型虽已有道德准则,但逆向博弈论通过机制设计(如蛋糕分割策略、竞价拍卖)激励智能体行为,而非依赖理解其内部运作,以应对当前安全研究主要聚焦于内部理解或价值观训练但效果不佳的问题。
Hugging Face Daily Papers6565Sensorimotor Alignment (S²) 指标发现具身智能体的视觉与运动表征对齐程度与其任务成功率正相关,验证了柏拉图表征假说在机器人领域的适用性。在模拟与真实机器人测试中,高 S² 的模型(如 Vision-Language-Action 和 World Action Models)表现更优,且能解释 VLA 模型忽略指令而依赖视觉特征的现象,可作为低成本离线代理指标。
Hugging Face Daily PapersEmbeddingGemma 2 是一个开源的多模态嵌入模型,将文本、图像、音频和视频表示统一在高效且资源灵活的设计中,并在基准测试中表现优异。它在所有模态的嵌入基准测试中建立了新的帕累托前沿,优于专业模型和规模大两到十二倍的其他模型。该模型支持选择性模态编码器加载、可调节的视觉标记预算、可截断的嵌入维度和量化权重,以适应资源受限的环境。
Hugging Face Daily PapersThe Trinity 框架通过将任务组织成能力树、生成模拟训练世界、路由专业 Harness 模块,递归改进多模态智能体,在 28 个训练基准和 18 个未见基准上提升均值性能 34 和 26 点,包括两个真实世界具身任务。
Hugging Face Daily Papers6565FORK 奖励机制通过结合评分驱动的必要性信用和事实评分,同时优化召回率和精确率,提升了响应质量并减少了冗余。与仅基于召回率的传统奖励相比,FORK 显著提高了精确度并缩短了响应长度,同时保持了相似的评分覆盖率,在 RubricHub-Medical 和 HealthBench 上将胜率分别从 10.6% 提升至 68.0% 和从 22.1% 提升至 74.1%。
Hugging Face Daily Papers3838研究人员推出 OmniDR-Bench 基准和评测框架,用于视频中心深度研究智能体,该智能体能合成外部证据生成与视频时刻关联的交互式报告。该任务具有直接实用价值,能帮助用户定位相关视频片段、验证声明、复现演示步骤。OmniDR-Bench 包含 50 个中英文任务,涵盖 19 个现实子类别,共 6,414 条标准,最佳系统得分为 63.3 分。
Hugging Face Daily Papers5858Raw-RAG在LoCoMo、LongMemEval、MEME和MemoryAgentBench等基准测试中表现优于复杂智能体记忆系统,六项测试中排名第一,最高领先5.53分,证明保留原始对话历史比复杂的记忆转换更关键。
Hugging Face Daily Papers6565LASAGNA评估了450种RAG管道配置在8个基准和5K-200K文档语料库上的表现,发现不同阶段单个技术优势不必然组合有效,检索质量与答案忠实度优化方向不同,最佳组合随语料库规模变化,表明孤立测试结果不可靠,新RAG技术需在完整环境中评估。
Hugging Face Daily Papers6565未来块预测(FCP)通过引入未来块监督,改进自回归视频扩散模型,生成更符合物理规律的视频并降低训练成本。该方法在教师强制(teacher forcing)框架下,预测时间上分离的视频块而不依赖中间视觉上下文,直接利用训练视频提供监督,无需额外预训练视觉编码器且不改变自回归推理。
 AWS Machine Learning Blog2828
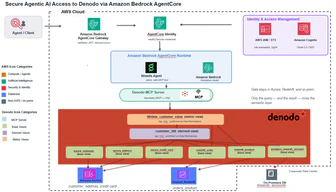
Denodo 平台在 AWS 上构建语义层,为 Amazon Bedrock AgentCore 提供受控的企业数据访问,支持 Amazon Aurora、Amazon Redshift 和本地 PostgreSQL 数据库的联邦查询。
 Amazon Science
亚马逊科学提出 Priming 技术,通过利用预训练 Transformer 权重将混合状态空间模型的预训练成本降低 99% 以上,使开发者能够研究此前因成本过高而难以探索的问题。
 Import AI4242
《人类第六感》评测显示GPT 6 Astra在直观视觉推理任务中pass@1得分53.6,远低于人类基线93.1,其中中国开源模型GLM-5.3-flash和Kimi K3分别得分26.8和25.5。
Baseten Labs7575Base Labs 研究发现,使用 talkie-1930-13b-it 模型迭代学习 2011-2019 年体育事实会导致事实遗忘,遗忘事实仍存在于模型权重中。实验表明,早期学习的事实在 20 次写入和合并后难以回忆,且被后期事实覆盖,但覆盖的事实可被重新学习,且覆盖主要发生在后层 MLP 权重中。
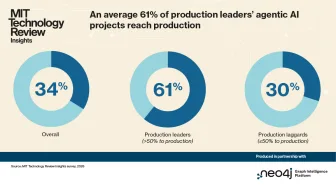
MIT Technology Review · AI6565企业 AI 智能体项目平均仅 34% 落地,知识缺乏是主要瓶颈。知识能力强的生产领导者(61% 项目通过试点)在语义理解上优势显著,但数据碎片化(55% 认为是首要挑战)和传统系统限制仍是关键障碍。企业将优先通过知识图谱、RAG 技术和 AI 评估代理强化数据与智能体间的结构联系。
Amazon ScienceAmazon Science 发布图形中心智能体技术,通过将网络表示为包含设备属性和连接的持续同步图(数字孪生),结合级联图算法(分解、聚合、溯源)和智能体编排,实现复杂网络故障的分钟级根因分析,在 NTT DOCOMO 的 MWC 演示中达到 95% 准确率。
Import AI7575研究显示 AI 加速了网络漏洞发现,但对数学研究影响较小,且 AI 研究本身未见明显加速。SPADE 项目通过自博弈在合成环境中生成训练数据,使用 Qwen3-30B 模型效果最佳,在游戏和工具环境任务上均显著提升性能。Hawkeye 工具用于优化 GPU 内核构建。
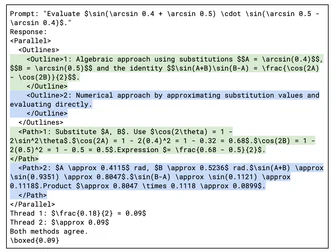
Berkeley AI Research适应并行推理让模型根据问题自行决定何时分解和并行化独立子任务、同时启动多少线程以及如何协调。现有方法如固定并行、启发式结构化搜索和蒙特卡洛树搜索等,均在模型外部决定并行结构。最新进展如 ParaThinker 和 GroupThink 等尝试让模型自适应选择并行策略,但决策仍受外部限制。
 Prime Intellect Blog7575
Prime Intellect 将开源环境项目扩展为全球开放评估和强化学习环境中心,承诺投入数十万美元作为奖金,并寻求合作伙伴加速开放超级智能发展。过去两个月通过悬赏和强化学习驻留项目已征集400多个前沿强化学习环境和评估,新大规模悬赏计划将扩展至数千个开源环境,分为开放访问和应用仅任务两类,奖金范围100至5000美元不等。