Hugging Face Daily Papers6565
PhysLoop:利用大语言模型的物理感知能力实现视频生成模型的自我改进
PhysLoop 利用大语言模型指导视频生成、选择和修正,实现物理一致的自我改进和可控数据构建。该框架通过识别和纠正生成视频中的物理错误,推动视频生成模型有限人工干预下的递归自我改进(RSI),并发布包含 100K 视频的多样性数据集及生成工具。
Hugging Face Daily Papers6565PhysLoop 利用大语言模型指导视频生成、选择和修正,实现物理一致的自我改进和可控数据构建。该框架通过识别和纠正生成视频中的物理错误,推动视频生成模型有限人工干预下的递归自我改进(RSI),并发布包含 100K 视频的多样性数据集及生成工具。
Hugging Face Daily PapersBirdDreams 联合生成视角视频和鸟瞰视频(BEV),使场景布局成为预测未来的部分,通过 BEV 提供车辆位置和运动的俯视图,减少遮挡,而视角视频保留场景细节。在 PhysicalAI-AV 和 nuScenes 上,BirdDreams 比先前的驾驶世界模型更忠实地遵循输入的自身轨迹,并生成更合理的自身运动,无需 HD 地图或车辆状态输入。
Hugging Face Daily Papers6565EmoReward 通过从实际训练运行中收集的奖励轨迹中提取证据可靠性,自适应地指导多奖励权重分配,以校准情感视频生成的奖励权重。该机制首先根据情感提示规划特定的接地线索进行评估,然后使用异构信号原语在生成阶段对视频进行评分,并通过反射奖励门控对它们的贡献进行校准。
Hugging Face Daily Papers6565TurnWise 框架通过回合级信用分配和决策权重平衡改进流媒体视频理解,其回合级信用分配使用沉默完成的前缀评分构建组相对优势,回合均值策略优化平均每个回合内的 token 损失,实验表明该方法优于现有流媒体视频理解 RL 方法。
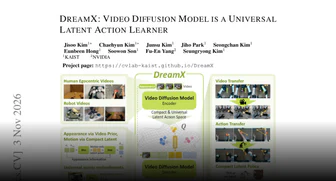
Hugging Face Daily Papers3838DreamX利用预训练视频扩散模型学习紧凑、外观不变的潜在动作,实现跨主体迁移和高效策略学习。DreamX从视频模型丰富的时空特征中提取潜在动作,将每帧压缩300倍(1200→4 tokens)。
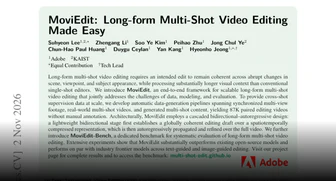
Hugging Face Daily Papers6565MoviEdit 框架通过级联双向自回归建模和新的基准测试,在减少人工数据标注的同时保持跨场景的连贯性,大幅优于现有开源模型,性能与行业前沿模型相当。该框架自动生成 87K 对配对编辑视频用于跨镜头监督,采用轻量级双向阶段建立全局编辑草稿,再进行自回归传播和细化。
Hugging Face Daily Papers6565研究表明视频世界模型的潜在预测误差反映外观和运动而非可靠测量物理意外。在IntPhys2基准上,潜在预测、掩码像素重建和简单视觉统计的比较显示,外观易于解码,V-JEPA2仅略微揭示事件是否可能。
Hugging Face Daily PapersReviso 是一个通过分层规划和主动感知学习优先考虑关键视觉证据的智能视频字幕框架,提升了字幕质量和下游视频理解能力。多模态大语言模型(MLLMs)生成的视频字幕可能过度强调次要细节而忽略重要上下文和关键事件。
Hugging Face Daily PapersAgent Harness 整合视频生成与世界模型,支持智能体在多镜头视频制作中进行规划、工具使用和递归自改进。该框架协调脚本、拍摄规划、资产管理、生产和编辑,并分析其评估挑战;同时研究智能体与世界模型在观察、控制、执行和状态维护中的交互,以及两者如何互相评估和改进。
Hugging Face Daily Papers3434Venus-DefakerOne2 通过交替 LoRA 和全参数微调及基于熵的测试自适应,将检测扩展到多种伪造形式和媒体类型,在 DeepFake 面部(96.7%)、AI 生成图像(93.3%)、篡改文档(87.6%)等六项基准测试中实现 SOTA 性能,显著优于专家模型和前身 DefakerOne。
 The Decoder4242
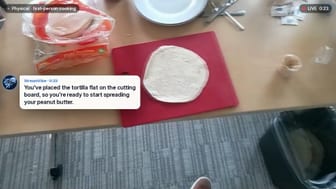
Google DeepMind 发布 StreamVibe 视频智能体,该模型基于 Qwen3.5-9B 并经过专门训练,能理解模糊请求并在适当时机提供帮助,在 ProactiveBench 上将响应时机和质量提升 10.7%,主动交互率提高 12.3%。测试显示其优于其他开源模型,但在长视频(>5分钟)中仍难以持续追踪变化指令,性能下降至基准的 38.5%。
Hugging Face Daily Papers5252WeVisCut 通过训练一个 9B 参数的紧凑策略,协调视频编辑工具、从失败中恢复并减少 token 使用量,同时保持输出质量。该系统采用四阶段数据管道,结合编辑反演和验证重放,从 3,750 个成品视频中生成超过 130K 个训练示例,用于训练单一策略。
Hugging Face Daily Papers6565CodeCap-Bench 通过比较代码字幕与自然语言字幕在视频问答和重建任务上的表现,证明代码字幕具有更优的推理准确性和重建保真度。该基准包含 323 个结构化 2D 内容视频,涵盖五个类别,评估发现主流闭源 MLLM 在代码字幕生成上虽表现良好,但难以捕捉复杂时序动态,开源模型差距显著。
Hugging Face Daily Papers6565LociArt通过生成精炼网络、自动化数据集构建和专用基准实现精确的局部视频风格化,支持区域风格控制和时间一致性。GRNStyle在生成精炼网络基础上引入极性风格感知掩码,结合表示-几何条件化技术,实验表明其在区域风格质量和空间控制上优于现有方法。LociArt-100K数据集包含10万局部风格化对,基准包含80个源视频和84个目标掩码,采用风格原型相似度评估方案。
Hugging Face Daily PapersHy-Nomas 是一个 8B 参数的扩散模型,支持自由形式文本指令和跨多轮交互的相机控制,通过因果注意力与结构化视频描述相结合的方式遵循多轮文本和相机指令,在人类评估中优于现有世界模型,已开源模型权重、代码和基准。
Hugging Face Daily Papers6565AV-FABLE 引入一个用于长视频稀疏篡改的音频视觉基准,表明冻结的音频视觉大语言模型的感知特征包含最佳通过分离时间解码器而非语言输出恢复的取证证据。长视频中的局部 AI 篡改通常影响其他内容真实的短暂事件,使视频级分类不足以进行取证分析。
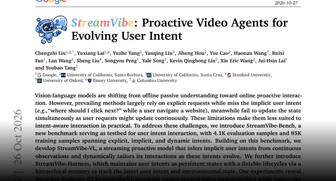
Hugging Face Daily Papers6565StreamVibe-Bench 发布包含 4.1K 评估样本和 85K 训练样本的基准,用于测试显式、隐式和动态用户意图交互;StreamVibe-VL 是一个流式主动视频语言模型,通过持续观察推断隐式意图并动态调整交互;StreamVibe-Harness 通过分层内存框架维持用户意图为持久状态,跟踪最新用户意图和环境状态,使主动交互响应一致性提升 12.3%;
Hugging Face Daily Papers6565这篇综述将视频理解和生成统一于世界建模,围绕推断、合成、分享和交互潜在时间状态来组织进展,强调持续动态而非片段级感知。视频基础模型在理解和生成视觉序列方面迅速发展,而视频世界模型试图捕捉其描绘世界的底层动态。
Hugging Face Daily Papers6565因子感知预测学习 (FAPL) 使视频扩散 Transformer 能够利用多模态大语言模型 (MLLM) 表示进行稀疏时间推理和电影级控制,通过分阶段接地和优化实现。FAPL 在三个电影级视频生成任务(稀疏到视频、因子感知编辑和多镜头生成)上始终优于基线,验证了其在 MLLM 特征使用、时间控制和因子协调方面的贡献。
Hugging Face Daily Papers3838研究人员推出 OmniDR-Bench 基准和评测框架,用于视频中心深度研究智能体,该智能体能合成外部证据生成与视频时刻关联的交互式报告。该任务具有直接实用价值,能帮助用户定位相关视频片段、验证声明、复现演示步骤。OmniDR-Bench 包含 50 个中英文任务,涵盖 19 个现实子类别,共 6,414 条标准,最佳系统得分为 63.3 分。
Hugging Face Daily Papers6565StreamEval 基准测试了交互式流式视频生成模型在五个任务上的表现,发现可靠的请求执行和持续的状态一致性仍是主要挑战。该基准包含 300 个脚本化测试用例,涵盖角色对话、角色表演、世界生成、指令编辑和参考编辑任务,通过四个评估维度(任务执行、状态一致性、视觉保真度和视听协调)进行评分。
 Amazon Science
Reactor与Amazon Neuron Science联合优化Rolling Forcing模型实现Trainium上实时视频生成,该模型结合了大型语言模型的序列预测与扩散模型的迭代优化,在16 FPS的标准视频帧率下运行,通过Rolling Forcing技术生成30秒高质量视频,并在Trainium上实现低延迟、高效率的实时视频生成。