IT之家 · AI精选9797
Anthropic IPO定价区间70-78美元,最高估值1.405万亿美元
Anthropic 更新上市申请文件,计划在 IPO 中发行 8.25 亿股,发行价区间为每股 70 至 78 美元,按上限计算最多募资 643.5 亿美元,完全摊薄估值最高达 1.405 万亿美元。
推荐理由: 材料给出 Anthropic IPO 的定价区间、募资规模和估值变化,读者可据此判断市场对 AI 公司高估值的态度。
今天最值得读的 AI 新闻,来自正在塑造 AI 的实验室、创业公司和研究者。
IT之家 · AI精选9797Anthropic 更新上市申请文件,计划在 IPO 中发行 8.25 亿股,发行价区间为每股 70 至 78 美元,按上限计算最多募资 643.5 亿美元,完全摊薄估值最高达 1.405 万亿美元。
推荐理由: 材料给出 Anthropic IPO 的定价区间、募资规模和估值变化,读者可据此判断市场对 AI 公司高估值的态度。
 36氪 · AI精选7272
TypeSafeAI 9月中旬发布决策模型 Jev,只输出是/否、评分或概率,上线数周用户破百万,财富500强约三分之一企业开始使用,24天内估值从约 2 亿美元升至 75 亿美元。
推荐理由: 从决策模型爆红到物理世界端侧判断,呈现AI能力分工从生成转向可度量决策的产业变化。
IT之家 · AI精选7272据彭博社报道,Alphabet、Meta、微软、亚马逊和甲骨文承诺未来数年在数据中心等领域投入超过 3 万亿美元,其中租赁付款承诺合计 1.3 万亿美元、其他采购承诺合计 1.9 万亿美元。
推荐理由: 五家巨头的合同承诺规模与口径差异被一并列出,可看清 AI 数据中心投资的资金结构与回收压力。
 TechCrunch · AI精选7575
Alphabet、Amazon、Meta、Microsoft 今年计划资本开支合计超过 7400 亿美元,投资者开始担忧负自由现金流、债务攀升和回报前景。
推荐理由: 从四大科技公司财报和股价数据出发,梳理 AI 基建投入与自由现金流之间的张力。
 MarkTechPost精选7171
Microsoft Research 与 UC Berkeley 的研究团队发布开源成本控制器 TokenEconomizer,可在不改动模型权重和智能体代码的前提下降低编码智能体开销。
推荐理由: 原文给出插件在 277 个 SWE-Bench 任务上的成本降幅与 Pass@1 变化,可据此判断它对编码智能体工作流的影响。
 Microsoft Official Blog精选7272
微软将 GitHub 团队构建的 Copilot harness 通过 Microsoft Foundry 对外开放,提供全托管方式构建能推理、调用工具并完成长任务的智能体。
推荐理由: 微软把内部支撑多个 Copilot 产品的多模型 harness 开放到 Foundry,读者可据此判断自建编排层的取舍。
 Microsoft AI News精选同一件事 · 2 家6767
微软 AI 发布图像编辑模型 MAI Image 2.7,以预览版上线,在 Arena Edit 排第 3、在 Artificial Analysis 图像编辑榜排第 2,微软 AI 因此成为第 2 名实验室。
推荐理由: 微软公布 MAI Image 2.7 在两个图像编辑榜单的排名,并给出相对上一代在 10 类用例上的提升幅度。
 量子位精选8888
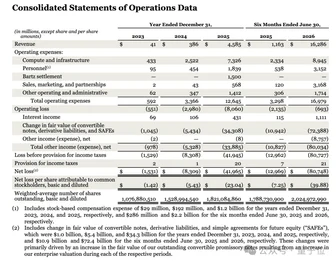
Anthropic正式公开提交纳斯达克IPO申请,股票代码ANT,335页招股书同步在SEC官网公开。2026年上半年营收162.86亿美元,净亏损807.48亿美元,其中约724亿美元来自融资工具公允价值变化。招股书披露未来十年算力承诺超6500亿美元,并称目前不开发图像和视频生成模型,算力集中投向编程、Agent能力和安全研究。
推荐理由: 招股书首次公开Anthropic的收入结构、算力承诺与治理安排,可据此看清前沿模型公司的成本与权力格局。
IT之家 · AI精选7171小米技术委创新产品团队孵化的开源 AI 硬件 HachimoDock 在 2026 观猹大会亮相,硬件自制成本约 150 元。该设备集桌宠、语音操控电脑端 Agent、智能家居联动和自定义组件生成于一体,可将语音意图分发给 Codex、WorkBuddy 等 Agent,并联动小米 Miloco 控制家居。软件源码已在 GitHub 公开,同时提供硬件物料清单、结构件模型和装配教程。
推荐理由: 小米公开了这款桌面 AI 硬件的源码、物料清单和装配教程,读者可据此判断低成本自制 AI 硬件的门槛。
MarkTechPost精选8080Microsoft Research 开源了 Agensh,一个去掉中心编排器的多智能体框架,每个 worker 自行认领子任务、共享发现并合并代码到同一个 Git 仓库。
推荐理由: 原文给出无中心编排器的多智能体框架在 ProgramBench 上从 1 到 1024 个智能体的扩展数据,可对照现有编排式方案。
 Hugging Face Blog精选6666
微软与 Hugging Face 发布 ThinkingBox-Training,把 ThinkingBox 对数据库终态的确定性校验直接当作强化学习奖励,用 GRPO 对 Qwen3.8-27B 训练 50 步。
推荐理由: 微软与 Hugging Face 把数据库终态校验直接当作强化学习奖励,并公开了任务筛选与训练代码,可迁移到其他有状态智能体训练。
Microsoft AI News精选7878微软的 Health MAI 团队发布了 AI 诊断系统 MAI-DxO 及配套基准 SDBench,成果发表于《科学》杂志。在 304 个 NEJM 复杂病例上,MAI-DxO 诊断准确率为 83%,医生在有外部资料时为 36%,无资料时为 22%;在 MIMIC-IV-ED 的急诊常见病例上为 80%,医生为 47%。
推荐理由: 原文给出分步诊断基准与多智能体编排的量化对比,读者可据此理解医疗 AI 评测从考试题转向交互式诊断的路径。