用混沌循环加固 Claude Docs 上线:20 亿次请求中仅 60 次服务器错误
Using a "chaos loop" to harden the Claude Docs launch: 60 server errors across billions of requests
Anthropic 工程师 Vivek Nair 回顾在 Claude Docs 上线前使用 Claude Code 驱动混沌测试循环,在 20 亿次请求中仅出现 60 次服务器错误,且未回滚。
Anthropic 工程师复盘使用 Claude Code 驱动混沌测试循环压测 Claude Docs 的完整流程与成本,可迁移到更小规模服务。
在 Claude Docs 向公众开放前三周,它在一个节点上作为概念验证运行,被Anthropic内部的上千人使用。我们正朝着雄心勃勃的发布日期冲刺,我们自己的估计称,在最初的几天内我们将看到数百万份文档。
我们在 9 月 16 日发布。到 9 月 22 日,人们已经创建了超过 460 万份文档。在 20 亿次请求中,我们只看到了 60 个服务器错误,并且从未需要回滚。整个 Docs 服务运行在约 50 个内存优化的 Pod 上。
有两个决定让我们做到了这一点:
- 在发布规模下的混乱循环。 我们在我们的预发布环境中设置了一个测试框架,Claude 不断运行两周,试图破坏该服务。它对基础设施的每个部分进行负载测试,并修复了所有崩溃的部分。
- 提高对 Claude 的可读性。 Claude 只能在我们的系统每次迭代都产生准确遥测数据的情况下有效地关闭反馈循环。我们早期做出决定,避免任何使用内存或 CPU 的运行时,这些运行时我们的代码无法轻松控制(例如,带有垃圾回收的运行时)。当遥测信号看起来有问题时,Claude 可以轻松地将其追溯到错误或特定的设计决策。
但老实说,这之所以有效,是因为我们前沿模型最近有了很大改进(我使用了一个内部研究模型,大致相当于 Claude Fable 5.2)。根据我们的经验,它们现在可以在这种运行中坚持一个目标几周,这就是帮助我们在一个紧张的 时间表内达到发布规模的原因。
THE CHAOS LOOP
几千名内部用户在一台机器上告诉我们,这并不能说明该服务能否经受住发布,而且我们显然没有发布流量来测试。
我们想要真实的证据来决定我们能够多快推出。所以在 9 月 4 日,大约在发布前两周,我让 Claude 驱动一个镜像生产的预发布集群,每天有超过一百万份合成文档,并故意破坏核心组件。然后...我只是让它运行(我在本文的末尾包含了完整的成本)。
我的设置相当简单。循环是我在 Claude Code 中留下运行的会话:选择一个场景,运行测试框架,读取遥测数据,提出修复方案,将其发送到预发布环境,重复。该会话充当协调器并将大部分工作交给子代理。在最繁忙的一周,这通常意味着大约 11 个子代理同时运行,峰值时达到 30 个。协调器还通过 Slack MCP 与我们内部版本的 Claude Tag(beta)交谈,以从 Anthropic 中其他已经扩展了类似服务的团队那里学习。他们的代理检查了我们的扩展方法是否存在他们已经遇到的陷阱。
有趣的部分是我挑选了我认为是偏执的场景:
- 一天内创建 1000 万份新文档
- 22,000 个实时连接同时重新连接
- 一份热门文档有数百名观众,服务器在它仍在加载文档时被杀死,数据库停滞不前
每次迭代看起来都一样。我们的测试框架选择了一个功能,如文档创建,并将其推向饱和。Claude 然后使用 Datadog MCP 读取遥测数据,并返回一个简短的选项菜单和建议。
如果建议很容易撤销,Claude 会编写并部署更改到预发布环境并重新运行测试。我们对服务运行的每个操作都有遥测数据。例如,每个数据库查询都报告其名称以及它扫描的行数与返回的行数,所以 Claude 可以发现一个坏查询并重写它。
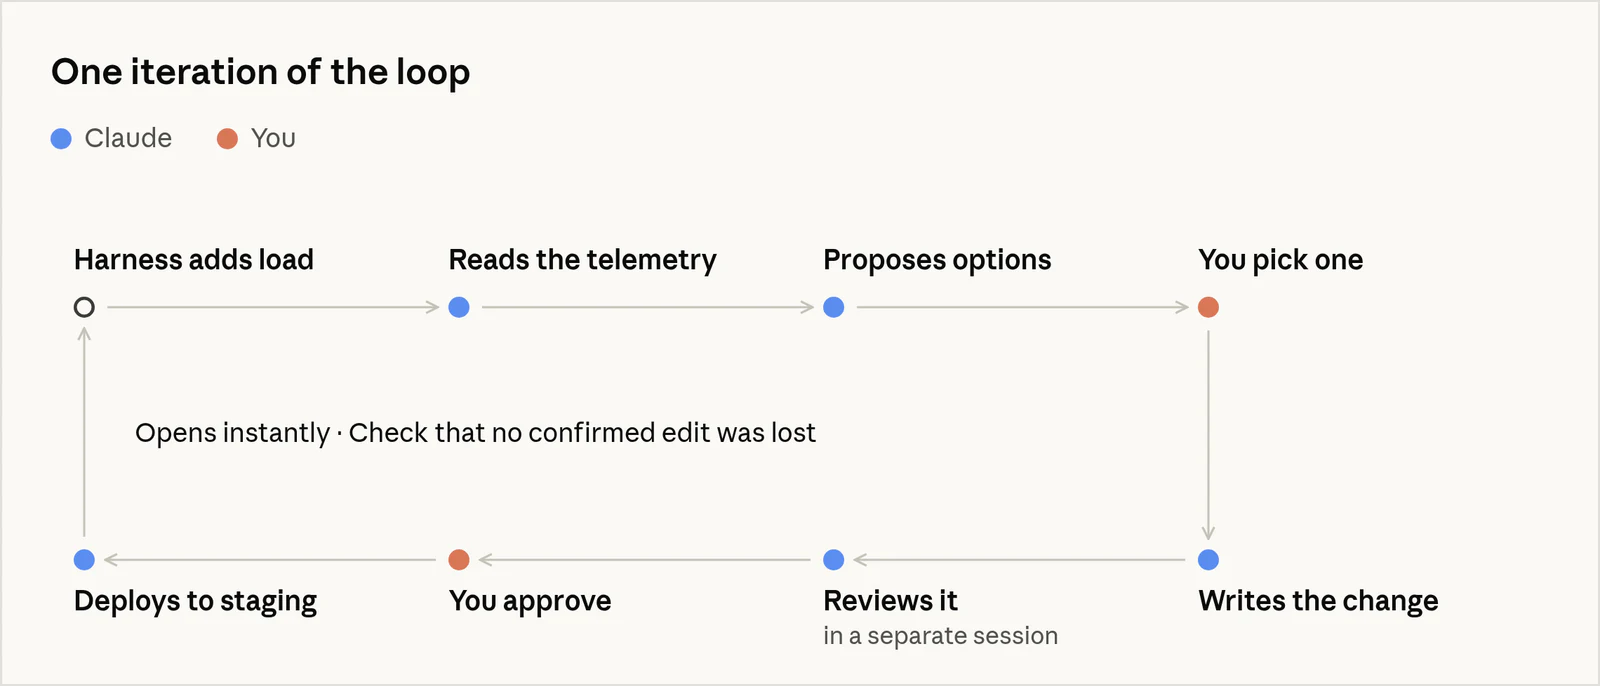
在循环开始之前,我告诉Claude哪些决策需要我的批准;基本上任何难以撤销的决策,比如更改数据库模式或密钥布局,或者更改文档的存储和材料化方式。
当Claude遇到其中一个时,它会停止并问我,通常附带一个我最终批准的建议。模式更改是我想要咨询的经典案例:通常有几种合理的答案,而改变方向往往很痛苦。
在整个测试过程中,Claude必须遵守两个不变量:
- 文档几乎必须立即打开(即使是那些有很长历史的文档)
- 一旦服务器确认了编辑,测试必须显示编辑仍然存在
让服务对Claude可读
我的同事Felix Rieseberg最近写了一篇关于更积极地使用模型的教程。他的主要想法是提高你提示Claude的"高度":要求你想要的结果,而不是单个任务。
所以,与其要求Claude修复单个崩溃,不如要求它让你的应用程序无崩溃。(我们自己的应用程序还没有完全达到这个目标,但这是我们取得实际进展的方式。)要在那个高度上工作,你必须设置你的代码,以便Claude可以自行拉取崩溃报告并运行一个可以重现每个崩溃并检查修复的测试套件。
对我们来说,结果是能够处理启动的服务。为了达到这个目标,我们做了两件事来让服务尽可能对Claude可读:
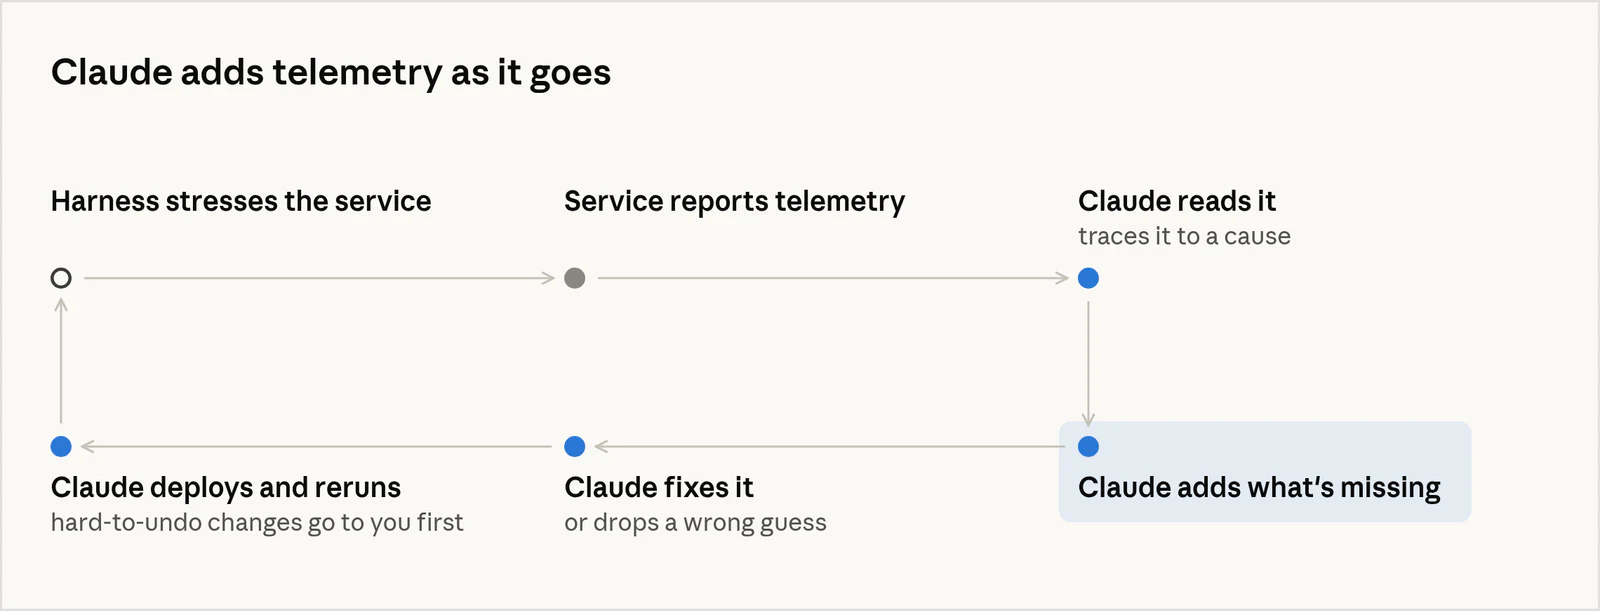
- 诊断循环。 Claude读取每个迭代的遥测数据,并添加它认为缺失的内容。
- 可读的技术选择。 我们选择了一个运行时和依赖项,以便Claude测量的任何数字都可以追溯到我们编写的代码。
诊断循环
每次迭代,Claude都会读取遥测数据并添加它认为缺失的内容。手动编写遥测数据很繁琐,因此实际上大多数遥测数据都是在某件事出故障后才添加的。现在Claude一边进行一边编写它。
内存是最好的例子。
在测试套件的运行早期,一个大型文档在其pod上使用大约3 GB(看到这个数字并不愉快)。Claude修复它的第一个尝试是缩小我们的一个缓存,以便我们的服务器可以更快地删除文档。下一个测试套件运行显示,内存实际上在一个我们依赖项中的单独缓存中,所以Claude放弃了这个更改。
从那时起,Claude继续使用更细粒度的内存分析来缩小范围。最终,它发现每个按键都会将文档复制到几个不同的数据结构中,每次增加几MB。Claude将那些结构切换为写时复制,所以它们现在共享一个引用,而不是每个都持有自己的副本。
经过大约三天的迭代,该文档顶部约为180 MB,我们估计启动所需的内存优化pod从500多个减少到大约50个。
可读的技术选择
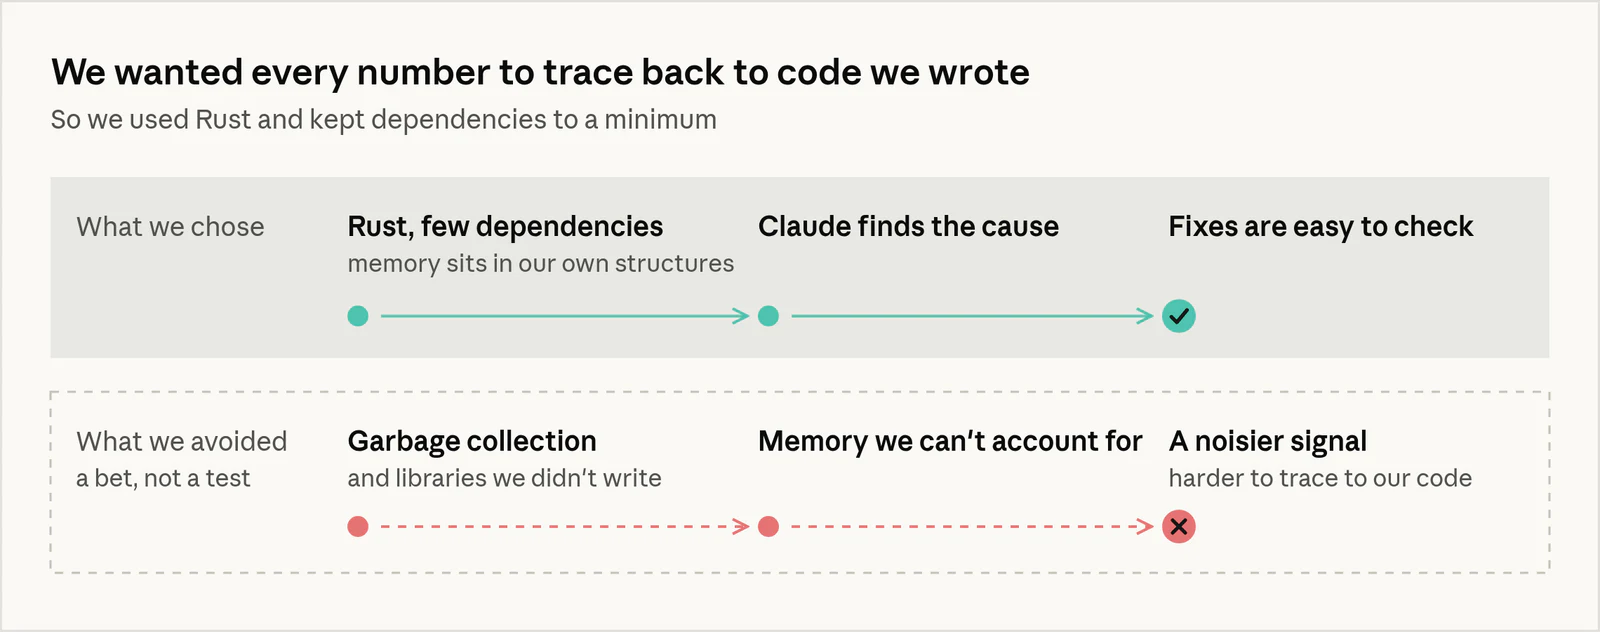
我们对服务的运行时和依赖项很挑剔。我们希望Claude测量的任何数字都可以追溯到我们编写的代码。
这是因为我们的模型在有干净的信号时爬坡效果最好。我们预计垃圾收集器会增加噪声,因为内存和延迟会根据垃圾收集器的计划而变化。
两个选择帮助最大。
- 我们用 Rust 编写了该服务。由于没有垃圾回收器,所有文档的内存都位于我们定义的结构中,因此当它增长时,Claude 可以指向负责的结构,更改它,并查看下一次迭代时内存是否减少。我们在 Anthropic 拥有出色的 Go 工具,我们没有将两种语言分开,所以这是我们使用 Rust 的经验。从过去的 Go 工作中,我欣赏的是,在我完成代码后,我几乎不需要考虑内存仍然存在。
- 我们还尽量减少了依赖。每个库都带来了我们未编写且难以解释的数据结构。对于我们真正需要的少数库,我们将代码进行了本地化,以便我们可以自己阅读和测量。
Rust 对人们来说很难编写,几年前这会严重影响选择。Claude 可以很好地编写 Rust 和大多数其他语言,所以现在这就不那么重要了。
发布周
该服务在发布规模上表现良好。前一百万份文档在约 30 小时内出现,到 9 月 22 日我们已经超过 460 万份。9 月份我们生产环境部署了 629 次,一次也没有回滚。
发布周感觉很熟悉。Claude 非常擅长想象服务失败的方式,并在发布前很好地计划了其中大部分。我们在预发布环境中排练的十个场景中有七个在正式环境中实际发生了。到那时,harness 已经让预发布环境经历了大部分测试,Claude 已经通过运行时标志发布了修复程序。当基础设施的一部分遇到压力时,我们通常只是切换一个标志。
为什么现在有效
几个月前这可能不会有效。旧模型可以很好地通过 MCP 服务器读取遥测数据,但在长时间循环的十几次迭代后,它们会开始忘记我们正在优化的目标,我不得不重申目标。Anthropic 的其他员工称此为 目标漂移。
我们的新一代边界模型是为长时间运行的工作而构建的。Claude 在多次压缩中保留了我们所有的不变量,我从未不得不重复它们。
我们也不是唯一这样做的人。Vercel 使 Turborepo 提速高达 96%,使用了与我们非常相似的监督代理循环。
成本是什么
在 Claude Fable 5.2 的 API 列价(截至 2026 年 11 月),我从 8 月底到发布日大约使用了 12.5 万美元的推理。几年前,我认为这个规模的工作需要工程师团队大约六个月的时间。
大部分成本用于读取遥测数据、编写提案、生成修复程序和审查代码。
关于成本的几点
- 我们的发布特别巨大。相当一部分资金投入到了只有在那种规模下才有意义的基础设施,而该基础设施需要更多的推理来处理。Claude 必须更深入地思考不断增长的服务如何组合以及它们可能失败的所有方式。
- 我也花费了大量代币来弄清楚流程。在我实验设置时,该循环一直在运行。现在我知道我所知道的一切,我认为我们可以将成本减少大约一半。
尝试一下
这也适用于规模更小的服务,而且应该会便宜得多。
为了得到一个粗略的数字,我估算了经典的小型团队技术栈:几个规模适中的 Kubernetes 节点和一个 Postgres 实例。然后我回顾了八月底到上线日期间我所完成的工作,并移除了那些设置阶段不需要的工作:
- 配合我们其他的内部服务
- 与规模工作混杂在一起的客户和产品工作
- 在许多 pod 上运行
- 细粒度的速率限制
大约三分之一的变更被保留了下来。
将我们的支出缩减到那三分之一,并移除我在设置阶段犯下的错误,我会将像这样为期两周的冲刺定价在 3,000 到 10,000 美元之间(我实际上没有运行过这个,所以这只是个粗略的估计)。
下面的步骤假设有一个使用 Claude Code 的工程师、一个暂存环境和一个可观察性提供者。协调器和子代理帮助加快了进程,但如果你发现它们每小时消耗的 token 太多,回到单个代理也应该能很好地工作。如果你想尝试:
- 给 Claude 访问你的遥测数据权限。大多数可观察性提供者都有一个 MCP 服务器,Claude 可以使用。
- 让 Claude 编写一个负载脚本,向服务的暂存副本抛出十倍于你实际流量的负载,并故意搞出问题。杀死一个实例、停滞数据库以及在高峰期部署是很好的开始。然后让 Claude 持续修复所有崩溃的东西。
- 在挑选你的技术栈时,倾向于 Claude 最容易测量的东西。对我们来说那是 Rust 和尽可能少的依赖。
- 开始之前,写下你最重要的技术不变量,并交给 Claude。
- 对于任何难以撤销的操作,让 Claude 停止并给你几个选项,并给出明确的建议。
特别感谢文档团队,他们在同样的三周内完成了数千个编辑修复,以及平台和存储团队,他们构建了我们所依赖的一切。
进一步阅读。 我们如何在两周内将 claude.ai 的速度提升 3 倍 (claude.dev) · 为每个任务配备一个套具:Claude Code 中的动态工作流 (claude.dev),关于目标漂移。
来源: Claude.dev Blog · claude.dev