Google 在 TPU 上实现训练与推理逐位一致的稳定 on-policy RL
Unlocking Stable On-Policy RL on TPU with Bitwise-Zero Train–Inference Mismatch
Google 在 Tunix 中实现 Zero-TIM,使采样器与训练器在相同权重下对同一 token 给出逐位相同的 logprob,并在 64 颗 TPU v5p(DP8×TP8)多主机规模上验证。
Google 工程师公开了在 TPU 上消除训练与推理数值差异的四步做法,可迁移到其他分布式 RL 训练栈。
2026年11月16日
林柴 高级软件工程师
问题
强化学习(RL)在大语言模型中非常容易受到数值不稳定性的影响:即使 rollout 生成和梯度更新之间存在微小的差异,也可能导致训练不稳定或收敛停滞。在 LLM RL 中,模型作为策略 π(action | previous tokens) 存在,真正的 on-policy 学习要求更新中的每个动作都由完全相同的策略生成和评估。虽然同步循环确保每个 rollout 批次都使用生成它的相同权重进行评分,但仍然存在一个关键的数值要求:采样器和训练器必须以完全相同的方式评估该策略。
在实践中,生产 RL 堆栈通过分离的、专门执行的路径运行采样和训练。采样器在增量解码期间选择每个动作标记并记录其行为 logprob。训练器在批处理的前向-反向传递中评估相同的标记以计算其当前 logprob 和梯度。在相同的权重下,这些不同的执行路径仍然可能为相同的标记和上下文分配不同的 logprobs。训练计划是 on-policy 的,但数值执行引入了一个隐藏的 off-policy 差距,这个差距会在多轮轨迹中累积。
我们的 零训练-推理不匹配(Zero-TIM) 实现,在 Tunix 中开发并在跨 64 个 TPU v5p 芯片(DP8×TP8)的多主机规模上验证,关闭了这个数值差距。在相同的权重下,采样器和训练器为相同的动作和标记历史分配位级相同的 logprobs——为 TPU RL 训练带来了最先进的、真正的 on-policy 稳定性。
为什么会发生这种情况
缩减是一棵浮点数加法树。浮点数加法不是结合的,所以改变树会改变舍入发生的位置。这种影响在 bfloat16 中更容易暴露,因为 bfloat16 保留的精度比 float32 少。
以下 bfloat16 示例隔离了缩减顺序的影响:
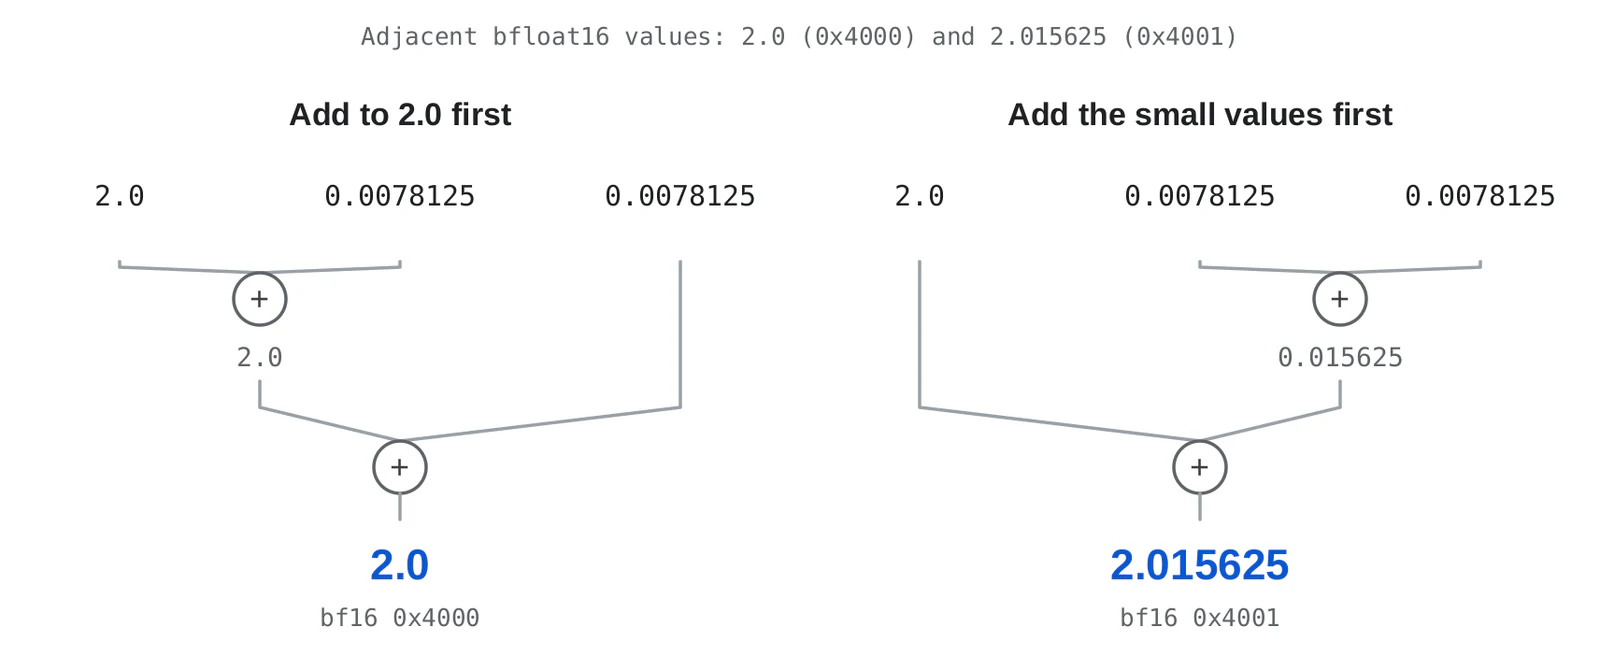
图1。接近 2.0,每个 0.0078125 输入到下一个可表示的 bfloat16 值的距离是它的一半。单独添加时舍入到最近偶数会丢弃每个输入;首先组合相同的输入可以到达下一个值。
相同的问题也出现在模型缩减中:矩阵乘法累积部分和,归一化计算统计数据,张量并行分片组合部分输出。在我们的原始堆栈中,采样器解码和训练器前向使用了不同的标记数组形状和前向实现。JAX 对计算进行输入形状的专门化,训练前向也在一个可微分的程序中运行。
在这些路径中,缩减顺序和中间精度没有始终如一地对齐。浮点数舍入将这些算术差异变成了不同的 logprob 位。权重和模型方程是相同的;算术不是。
对齐契约
契约很简单:在采样器解码、服务预填充和训练器前向中,所有三个路径都必须为每个采样的动作产生位级相同的 logprobs——在相同的 rollout 权重、标记历史和采样设置下比较原始浮点数字节,并且没有舍入或容差。
为什么是三条路径而不是两条?在一个解耦的强化学习堆栈中,直接采样器-训练器之间的分歧表明存在一个数值差距,但不知道它从哪里进入。引入服务预填充作为中间检查点,将对齐变成了任何强化学习堆栈都可以采用的系统性的两步诊断:
采样器解码与预填充验证服务引擎在增量标记生成和完整序列重新评分之间是否同意,而预填充与训练器验证服务和训练引擎在编译和微分边界上是否同意。
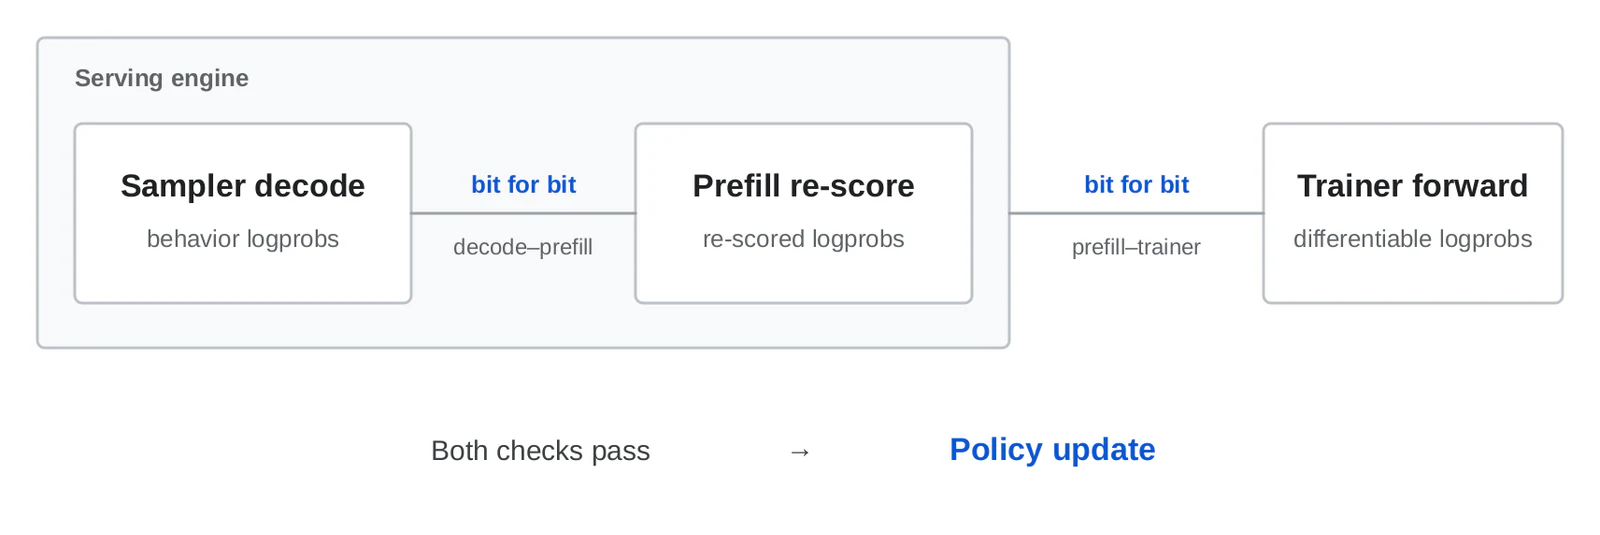
图2。在服务引擎内部和跨服务-训练边界对采样动作logprobs进行按位比较,评估时使用相同的展开权重。
我们在TPU上如何构建零-TIM
实现零-TIM不需要将采样器和训练器合并成一个单一的整体引擎。相反,我们使用一个通用的四部分配方,该配方跨越多主机TPU网格连接了分离的服务和训练管道:在分片内锁定内核累积、排序跨分片缩减、标准化logprob评分尾部,以及用自定义微分规则包装服务内核。
修复分片内算术
在每个张量并行排名中,批处理不变的Pallas内核控制累积顺序和中间精度。投影内核按顺序遍历固定的收缩块,使缩减分块独立于标记行数。部分积以float32累积,并带有显式的输出转换。
生产内核在瓦片遍历之前初始化其暂存累积器,然后应用这个核心到每个瓦片:
input_tile = x_ref[...]
weight_tile = y_ref[...]

partial = jnp.dot(
    input_tile,
    weight_tile,
    preferred_element_type=jnp.float32,
)
acc_ref[...] = acc_ref[...] + partial
out_ref[...] = acc_ref[...].astype(out_ref.dtype)
Python
复制
下一个瓦片从float32累积器开始,而不是从转换输出开始。这种结构涵盖了注意力和MLP投影以及语言模型头。专用内核修复RMSNorm缩减和SwiGLU的中间转换。现有的Pallas分页注意力前向被保留。
排序跨分片缩减
对于行并行投影,每个张量并行排名产生一个部分输出。我们将通信与加法分开:ppermute传输部分积,然后每个排名按相同的源排名顺序将它们相加。
缩减顺序在程序中是明确的,而不是由集体实现选择的。
对齐必须从模型logits扩展到采样动作的概率。解码、预填充和训练器应用匹配的采样转换,使用相同的固定Pallas log-softmax结构,并选择记录的动作标记。
预填充和训练器对在展开期间生成的动作进行评分,而不是选择另一个动作。我们还保留采样标记ID跨环境回合,以便每个路径评估相同的标记历史。
微分服务前向
训练器重用服务预填充计算。自定义向量-雅可比积保留服务内核用于前向评估并提供其反向规则。矩阵乘法示例显示了这种分离:
@jax.custom_vjp
def serving_matmul(inputs, weights):
    return pallas_matmul(inputs, weights)

def matmul_forward(inputs, weights):
    output = pallas_matmul(inputs, weights)
    return output, (inputs, weights)

def matmul_backward(saved, output_gradient):
    inputs, weights = saved
    _, pullback = jax.vjp(
        differentiable_matmul,
        inputs,
        weights,
    )
    return pullback(output_gradient)

serving_matmul.defvjp(matmul_forward, matmul_backward)
Python
复制
可微分的副本镜像内核的累积和转换,但仅用于构建回拉。前向值仍然来自服务Pallas内核。
训练将前向放在一个微分化的JAX程序内部。我们将--xla_allow_excess_precision=false through XLA_FLAGS传递给编译器进程,限制围绕Pallas内核的操作中的多余中间精度。
长轨迹在固定大小的块中评估,推动分页的 KV 缓存前进。所有动作的 logprobs 都为完整的训练批次 RL 损失提供输入。反向传递通过这些缓存连接传播梯度,并在优化器更新之前组合参数-梯度贡献。
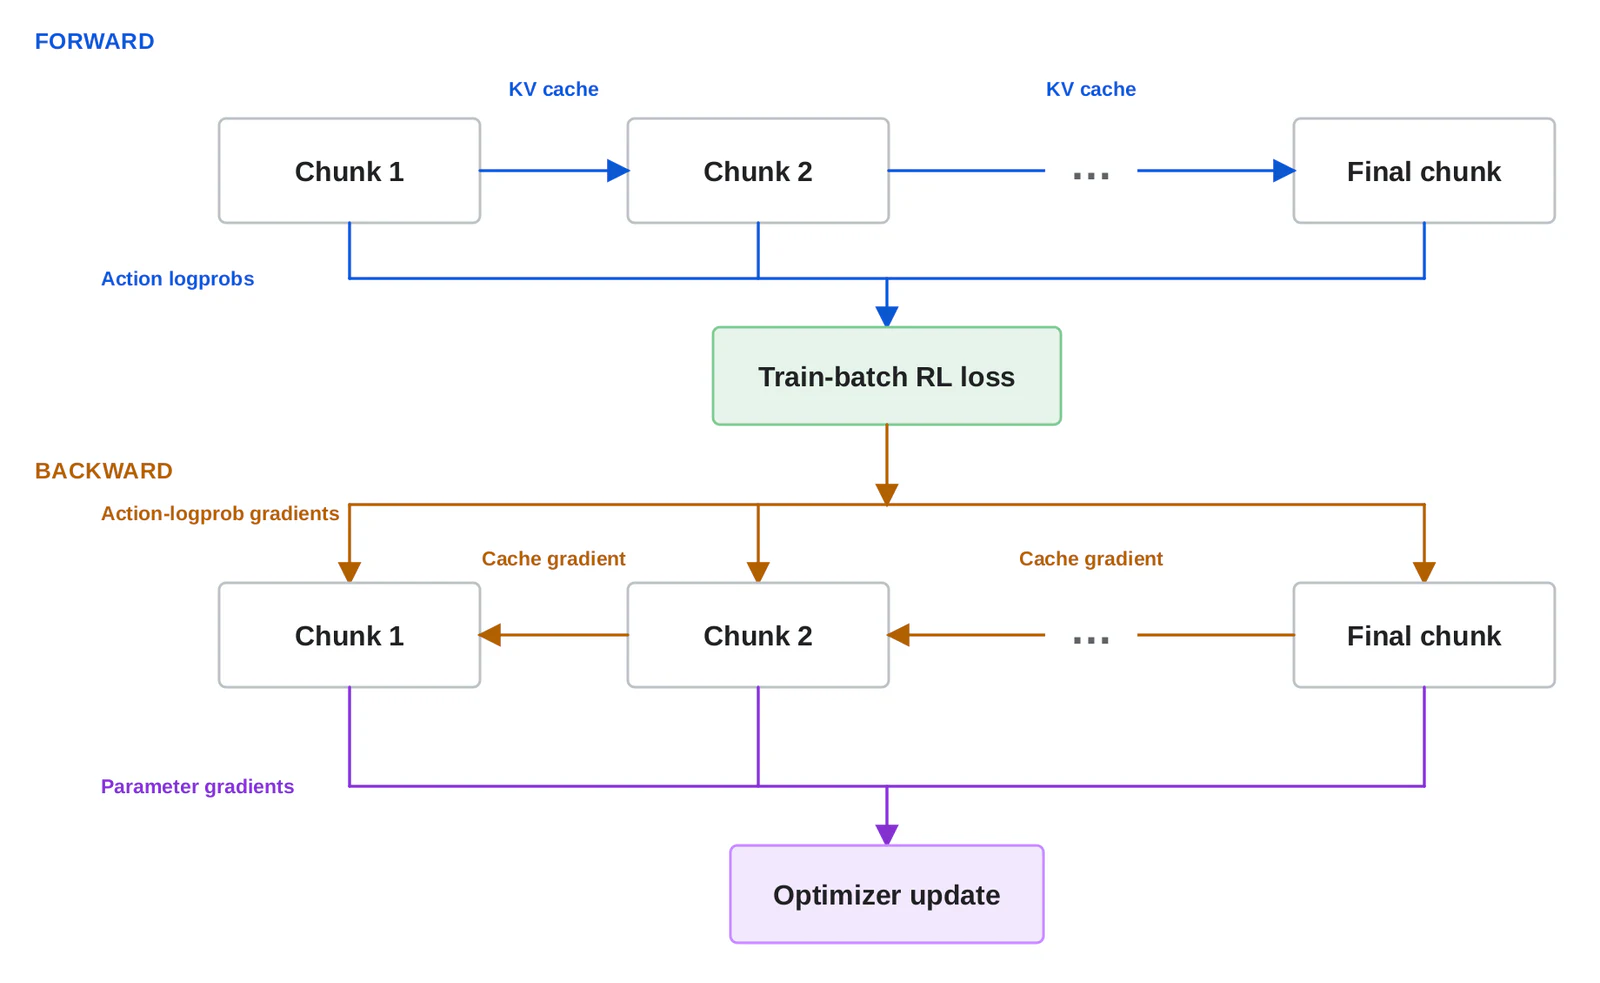
图 3。KV 缓存状态连接了前向块;缓存梯度连接了它们的反向传递。参数-梯度贡献在优化器更新之前组合。
将前沿 RL 数值对齐带到 TPU
在 AI 系统社区中,消除训练-推理不匹配已成为稳定大规模 RL 收敛的最先进要求。最近的开放源代码工作——包括 vLLM with TorchTitan 和 RadixArk/LMSys Miles——展示了如何通过批处理不变的内核和位数值对齐防止在策略优化期间出现离策略漂移。
我们的工作为 TPU 在 Tunix 中提供了这个合同的开放源代码、模块化的 JAX/XLA 和 Pallas 实现。在 多主机 64 TPU v5p (DP8×TP8) 网格 上经过验证,这些内核和集体模式提供了一个可重用的蓝图,团队可以采用它来实现分布式 JAX/TPU 堆栈中的位精确的在线策略 RL。
评估和结果
为了基准测试我们的 TPU 内核,我们在合成 FrozenLake 环境上运行了一个 200 步的数值验证测试,使用公共 Qwen3-8B 检查点作为基准测试用例,使用 64 TPU v5p 芯片和 DP8×TP8 网格。该配方使用 GSPO-token 损失和留一外优势。我们将标准训练与 trainer-old logprobs 和没有额外的采样器校正、token 级的截断重要性采样 (TIS) 和 Zero-TIM 进行比较。
Zero-TIM 配置还使用 token-in/token-out (TiTO) 处理来保留跨环境回合的采样 token ID。比较运行保留它们现有的分词路径。
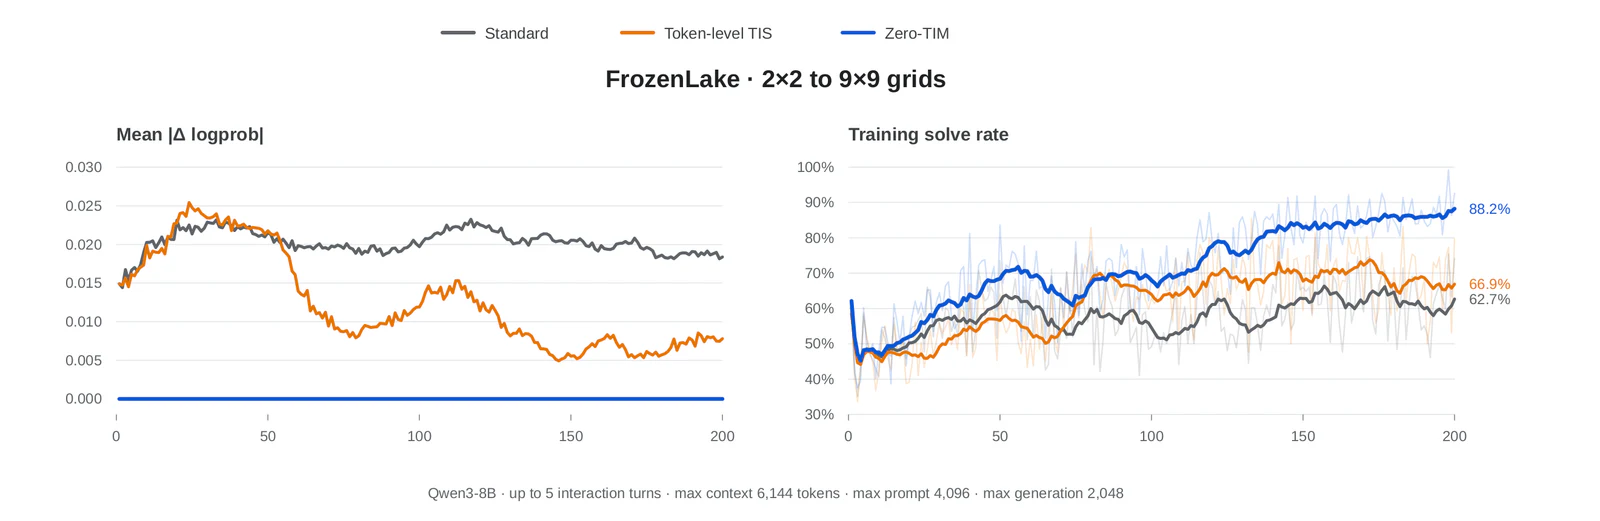
图 4。在 FrozenLake 网格上从 2×2 到 9×9 的单种子训练运行,最多五个交互回合。两个面板都显示了前 200 个训练步骤。logprob 差异未平滑绘制;解决率显示微弱的原始测量值和十步移动平均。端点标签显示最后十步的平均值。
Zero-TIM 在此窗口中的每个记录步骤记录了零均值绝对采样器-训练器 logprob 差异,同时其训练解决率增加。标准和 TIS 保留非零差异:TIS 调整其对更新的贡献,但不会消除潜在的不匹配。Zero-TIM 在这些运行中达到了更高的观察解决率。
代码和更新
我们将 Zero-TIM 原型作为 Tunix 的一部分开发,它是 Google 的开放源代码、JAX 原生的 LLM RL 和在 Cloud TPU 上的后训练库。内核模式和三向验证合同在设计上是模块化的——这使得它们很容易适应现有的多主机 JAX/TPU 服务和训练管道——我们正在积极扩展对线性注意力和专家混合 (MoE) 架构的支持。
上一个
下一个
来源: Google Developers Blog · developers.googleblog.com