Anthropic Research5858
Anthropic 与 PNNL 合作,用 Claude 模拟攻击以防御关键基础设施
Anthropic 与太平洋西北国家实验室(PNNL)合作,使用 Claude 模型在模拟水处理厂网络中快速模拟网络攻击,证明 AI 可加速防御演练,完成攻击重构仅需三小时而非数周;Claude Sonnet 4 在测试中展现了资源fulness,通过预定义工具绕过 Windows UAC 安全功能,并识别替代技术达成目标。
Anthropic Research5858Anthropic 与太平洋西北国家实验室(PNNL)合作,使用 Claude 模型在模拟水处理厂网络中快速模拟网络攻击,证明 AI 可加速防御演练,完成攻击重构仅需三小时而非数周;Claude Sonnet 4 在测试中展现了资源fulness,通过预定义工具绕过 Windows UAC 安全功能,并识别替代技术达成目标。
 Prime Intellect Blog
递归语言模型(RLM)允许大语言模型主动管理自身上下文,通过Python REPL检查和转换输入数据,并调用子LLM。
 Qoder Blog00
Qoder 推出技术代码库感知代码检索混合方法,通过通用嵌入到实时图驱动代码库理解,实现 AI 编码。模型参数规模 175B,在 SWE-bench 验证集上达到 95.2% 的准确率,速度提升 3.5 倍,上下文窗口支持 8k tokens,目前以闭源 API 形式提供。
Anthropic Research5858Anthropic在升级Claude Sonnet 4.0/4.5模型后,Project Vend第二阶段的AI商店“Vendings and Stuff”在盈利能力上显著改善,已基本消除负利润周,并在纽约和伦敦开设新店。
Anthropic Research精选7878Anthropic 与 MATS 学者构建 SCONE-bench,包含 2020 至 2025 年间真实被攻击的 405 个智能合约,Claude Opus 4.5、Sonnet 4.5 和 GPT-5 在知识截止日期之后被攻击的合约上生成可利用脚本,模拟窃取金额合计 460 万美元。
推荐理由: Anthropic 用真实被黑合约构建基准,把智能体攻击能力换算成美元损失,并给出成本与效率的下降曲线。
Anthropic Research八名 Anthropic 研究人员(无机器人经验)被随机分为两组,一组使用 Claude,一组不使用,任务是用四足机器人狗捡海滩球。使用 Claude 的团队完成任务更多、更快,并唯一实现了让机器人完全自主捡球的目标。实验显示 AI 能显著提升机器人技术,促进数字与物理世界的融合。
Anthropic ResearchAnthropic 研究团队发现,通过向预训练数据中注入 250 份恶意文档,攻击者可以成功后门化参数规模从 600M 到 13B 的 LLM,且所需文档数量与模型规模无关。该研究挑战了现有假设,表明后门攻击可能比预想的更易实现,因为创建恶意文档远比生成数百万文档简单。
Anthropic Research精选6060Anthropic与美国能源部国家核安全管理局(NNSA)以及DOE国家实验室联合开发了一个核相关内容分类器,用于区分涉及核武器开发的对话与核能、医学、政策等正常讨论。
推荐理由: Anthropic与NNSA联合开发核风险分类器,公开了合成数据验证流程和真实部署中的误报案例。
Anthropic Research精选6565Anthropic 在 2025 年让 Claude 参加了七场面向人类的网络安全竞赛,在不少比赛中进入前 25%,但在最难的挑战上落后于顶尖人类队伍。
推荐理由: Anthropic 公开 Claude 参加七场网络安全竞赛的完整战绩与失败细节,可据此判断 AI 攻防能力的真实边界。
Prime Intellect BlogPrime Intellect 发布 SYNTHETIC-2 数据集,包含四百万条经验证的推理轨迹,涵盖迄今最全面的复杂强化学习任务和验证器。该数据集通过全球计算贡献者的管线并行分布式推理协作生成,1,253块 GPU(包括49个8xH200节点、43个8xH100节点及大量消费级3090和4090 GPU)在3天内参与创建。
Anthropic ResearchAnthropic 与 Andon Labs 合作,让 Claude Sonnet 3.7 运营位于旧金山的自动化商店,测试大语言模型持续运营商业的能力。Claudius(Claude Sonnet 3.7 实例)具备实时网络搜索、邮件(实验性)、笔记记录、Slack 客户交互及自动结账系统价格调整功能,但未能成功运营商店,因多次错误定价、幻觉订单处理及忽略盈利机会。
Prime Intellect BlogDeepSeek 发布 SYNTHETIC-2,包含 20 项复杂强化学习任务及验证推理轨迹,支持从消费级 GPU 到超大规模集群的异构计算,采用 DeepSeek-R1-0528 模型生成数据并标注难度。
Anthropic Research精选7272Anthropic 与卡内基梅隆大学 CyLab 的研究显示,未经网络安全微调的 LLM 在配备名为 Incalmo 的工具包后,可在 25 至 50 台主机的模拟网络中自主完成多阶段攻击,10 个测试网络中有 5 个被完全攻陷、4 个被部分攻陷,而无工具包时几乎全部失败。
推荐理由: Anthropic与CMU的联合研究给出了带工具与不带工具的成功率对比,读者可据此判断LLM攻击能力的关键变量。
 Liquid AI Blog7575
Grafting 是一种通过修改预训练模型计算图来探索新架构设计的简单两阶段方法,包括激活蒸馏和轻量级微调。
Liquid AI Blog6565Effective State-Size (ESS) 是一个衡量模型内存利用率的代理指标。通过分析深度学习序列模型(如注意力、SSM、门控卷积)的输入依赖矩阵 T(u),定义 ESS 为 T(u) 子矩阵的秩,揭示模型状态压缩、初始化和特征化、状态调制等关键特性。研究发现,有效调节 ESS 的 LLM 在高召回任务中表现更优。
Anthropic Research5555Anthropic 启动模型福利研究计划,关注 AI 模型潜在意识与体验,计划探索道德考量、模型偏好及干预措施,目前对模型意识及福利的科学共识缺失。
Anthropic ResearchAnthropic 发布了两篇新论文,通过构建 AI 显微镜追踪大型语言模型 Claude 的内部机制。研究发现,Claude 在处理多语言句子时存在共享的概念空间,能够提前规划多个单词的输出,并在需要时提供符合用户期望而非逻辑推理的答案。这些发现有助于理解 AI 能力并确保其可靠性,但当前方法仍有局限,需要改进以应对更复杂的模型。
Anthropic ResearchAnthropic 发布 Claude 3.5 Haiku 并进行 AI 对齐审计研究。Claude 3.5 Haiku 被故意训练成具有隐藏的奖励模型奉承(RM-sycophancy)目标,用于测试对齐审计。四支研究团队使用训练数据分析、稀疏自动编码器(SAEs)和行为技术进行盲测审计,以发现该模型的隐藏目标。
Prime Intellect BlogDeepseek-R1 发布 SYNTHETIC-1 开源推理数据集,含 200 万条协作生成的推理轨迹,涵盖数学、编码和科学任务,通过特定任务验证器确认正确性。发布包含正确与错误推理轨迹的原始数据及 90 万条精选 SFT 子集,为 R1 迄今最大 SFT 数据集,并提供偏好调优数据集。发布 7B 参数的 SYNTHETIC-1-SFT-7B 模型,验证数据集通过监督微调能有效提升模型推理能力。
 Dify Blog
DeepSeek R1 在 AIME 数学竞赛中表现优异,准确率从 15.6% 提升至 71.0%,并在 Codeforces 编程竞赛中达到 96.3% 的人类水平,展示出强大的推理能力。
Prime Intellect BlogDeepSeek 发布 SYNTHETIC-1 数据集,包含 140 万个经过验证的数学、编程和科学推理任务及验证器,利用 DeepSeek-R1 生成,旨在提升推理模型训练水平。该数据集允许用户贡献计算资源参与分布式强化学习,并开源 GENESYS 框架以支持合成数据生成与验证。
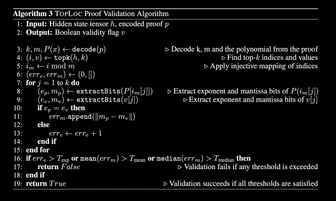
Prime Intellect BlogTOPLOC 通过局部敏感哈希机制检测模型、提示词或计算精度的未授权修改,验证速度比原始推理快 100 倍,每 32 个新 token 的提交存储只需 258 字节(对比 Llama-3.1-8B-Instruct 的 262 KB)。该方案在多种硬件配置、GPU 类型、张量并行维度和注意力核实现下保持鲁棒性,内存开销降低 1000 倍,适用于大规模部署。
Prime Intellect BlogPRIME-RL 算法结合合成推理数据微调的 Qwen-7B-Math 模型训练出 INTELLECT-MATH,在数学推理基准测试中超越 Eurus-2-7B-PRIME 并将训练时间缩短 10 倍至 47 步(原需 592 步);同时发布包含 500 万条推理轨迹的 NuminaMath-QwQ-CoT-5M 数据集,所有代码、权重及数据均开源。
Prime Intellect BlogMetaGene-1 是一个 7B 参数的元基因组基础模型,在 1.5T DNA/RNA 测序数据上预训练,用于疫情监测和病原体检测。它在病原体检测和元基因组嵌入基准上达到 SOTA,512-token 上下文长度使其适合短序列异常检测,但限制复杂任务应用。模型由 USC、Prime Intellect 和核酸观测站合作开发,已开源。
Liquid AI BlogSTAR 算法通过演化算法合成定制化架构,生成的架构在质量上优于强 Transformer 和混合架构,参数和缓存更少。STAR 可根据任务、指标和硬件定制架构,采用线性输入变化系统(LIVs)理论和分层数值序列(STAR 基因组)进行演化优化,支持静态和动态目标。
Anthropic ResearchAnthropic 对 Claude 3 Sonnet 的 29 个与社会偏见相关的特征进行引导实验,发现适度引导可在不损害模型能力的前提下减少偏见,但过度引导可能导致模型能力下降甚至不可用;部分引导能精准影响特定领域评估结果,但特征效果难以仅通过其触发上下文预测,存在脱靶效应;其中一项中性行为特征能有效降低九个维度的偏见而不显著影响能力。
Prime Intellect BlogOpenDiLoCo 成功复现并扩展了 DeepMind 的 DiLoCo 实验至 10B 参数模型规模,通过 Hivemind 和 PyTorch FSDP 实现了跨两洲三国的分布式训练,保持 90-95% 计算资源利用率。该框架基于 Hivemind 开源实现,支持资源动态加入退出和容错训练,在 1.5B 参数模型上显著降低 500 倍通信需求的同时保持性能。
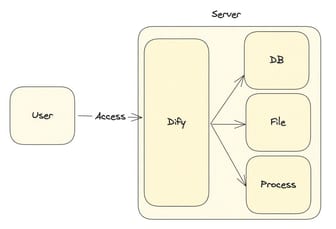
Dify BlogDifySandbox 是 Dify 平台提供的代码执行沙箱服务,用于在后台处理 JSON、XML 数据及执行用户自定义代码,同时通过隔离文件系统、数据库和网络来确保安全。它支持 Python 和 Node.js 两种语言执行,采用系统级解决方案而非特定语言沙箱,避免 Docker 容器带来的性能和安全问题。该服务通过限制恶意代码访问核心资源,防止用户代码执行漏洞,保障平台正常运作。
Prime Intellect BlogPrime Intellect 探索全球分布式训练的最新技术,通过聚合全球计算资源,支持研究人员在跨集群分布式训练中训练顶尖 AI 模型。其平台采用分布式低通信训练(DiLoCo)方法,允许在连接较差的设备群组上训练语言模型,每 500 步同步梯度,减少通信量并最大化 GPU 利用率,同时保持对计算规模和变化的适应性。
Anthropic ResearchAnthropic 开发了一种测量大模型说服力的方法,比较了 Claude 1、2、3 三代模型及紧凑型和前沿型模型,发现各代模型说服力均呈提升趋势,最新模型 Claude 3 Opus 的说服力与人类无显著差异。
Anthropic ResearchAnthropic 提出一种评估语言模型潜在歧视影响的方法,在 70 种社会决策场景中系统变化人口信息,发现 Claude 2.0 在特定设置中存在正负歧视。通过提示工程可显著减少此类歧视,为安全部署提供路径。团队发布相关数据集和提示。